Bedrock 将检索与长期记忆整合到单次调用
AWS 展示如何通过 AgenticRetrieveStream 将对话存储、事实提取和长期记忆接入助手。示例覆盖多用户场景下的文档访问权限与个人记忆隔离。
AI 深度解读
知识库助手能查到文档,不代表它记得用户。上个月说过自己在法兰克福办公,这次问休假政策时,用户往往期待系统自动补上这个条件,同时只引用自己有权查看的资料。
AWS 这篇文章给出的方案,是把 Amazon Bedrock Managed Knowledge Base 与 Amazon Bedrock AgentCore memory 接起来:一次请求完成历史恢复、按需读取长期记忆、带权限检索和回答保存。它值得看的地方,在于如何把「记住用户」和「隔离用户」一起落到请求与权限设计上。
记忆怎样真正参与知识库检索
普通对话历史主要解决追问,例如「那申请流程呢」。跨会话的个人信息更难处理:用户的地点、岗位、回答偏好,可能散落在几周前的聊天里,不能每次都把全部记录塞进上下文。
作者把记忆分成两层。短期记忆(STM)保存会话事件,负责恢复当前对话;长期记忆则从对话中异步提取记录,让规划器判断哪些信息能帮助本次检索,再用这些信息组织知识库子查询。
他们配置了两种提取策略:summary 保存「聊过什么」,包括偶然提到的办公地点;user-preference 保存「希望怎样被回答」,例如偏好简短列表、不要表格。提到某个地区,不等于偏好在那个地区部署,二者不能混为一谈。
一次 AgenticRetrieveStream 调用中,服务会恢复历史,通过推测性检索或规划器选择的记忆搜索取得相关信息,再检索文档并流式生成带引用的答案。默认还会保存这一轮问答,供后续异步提取使用。
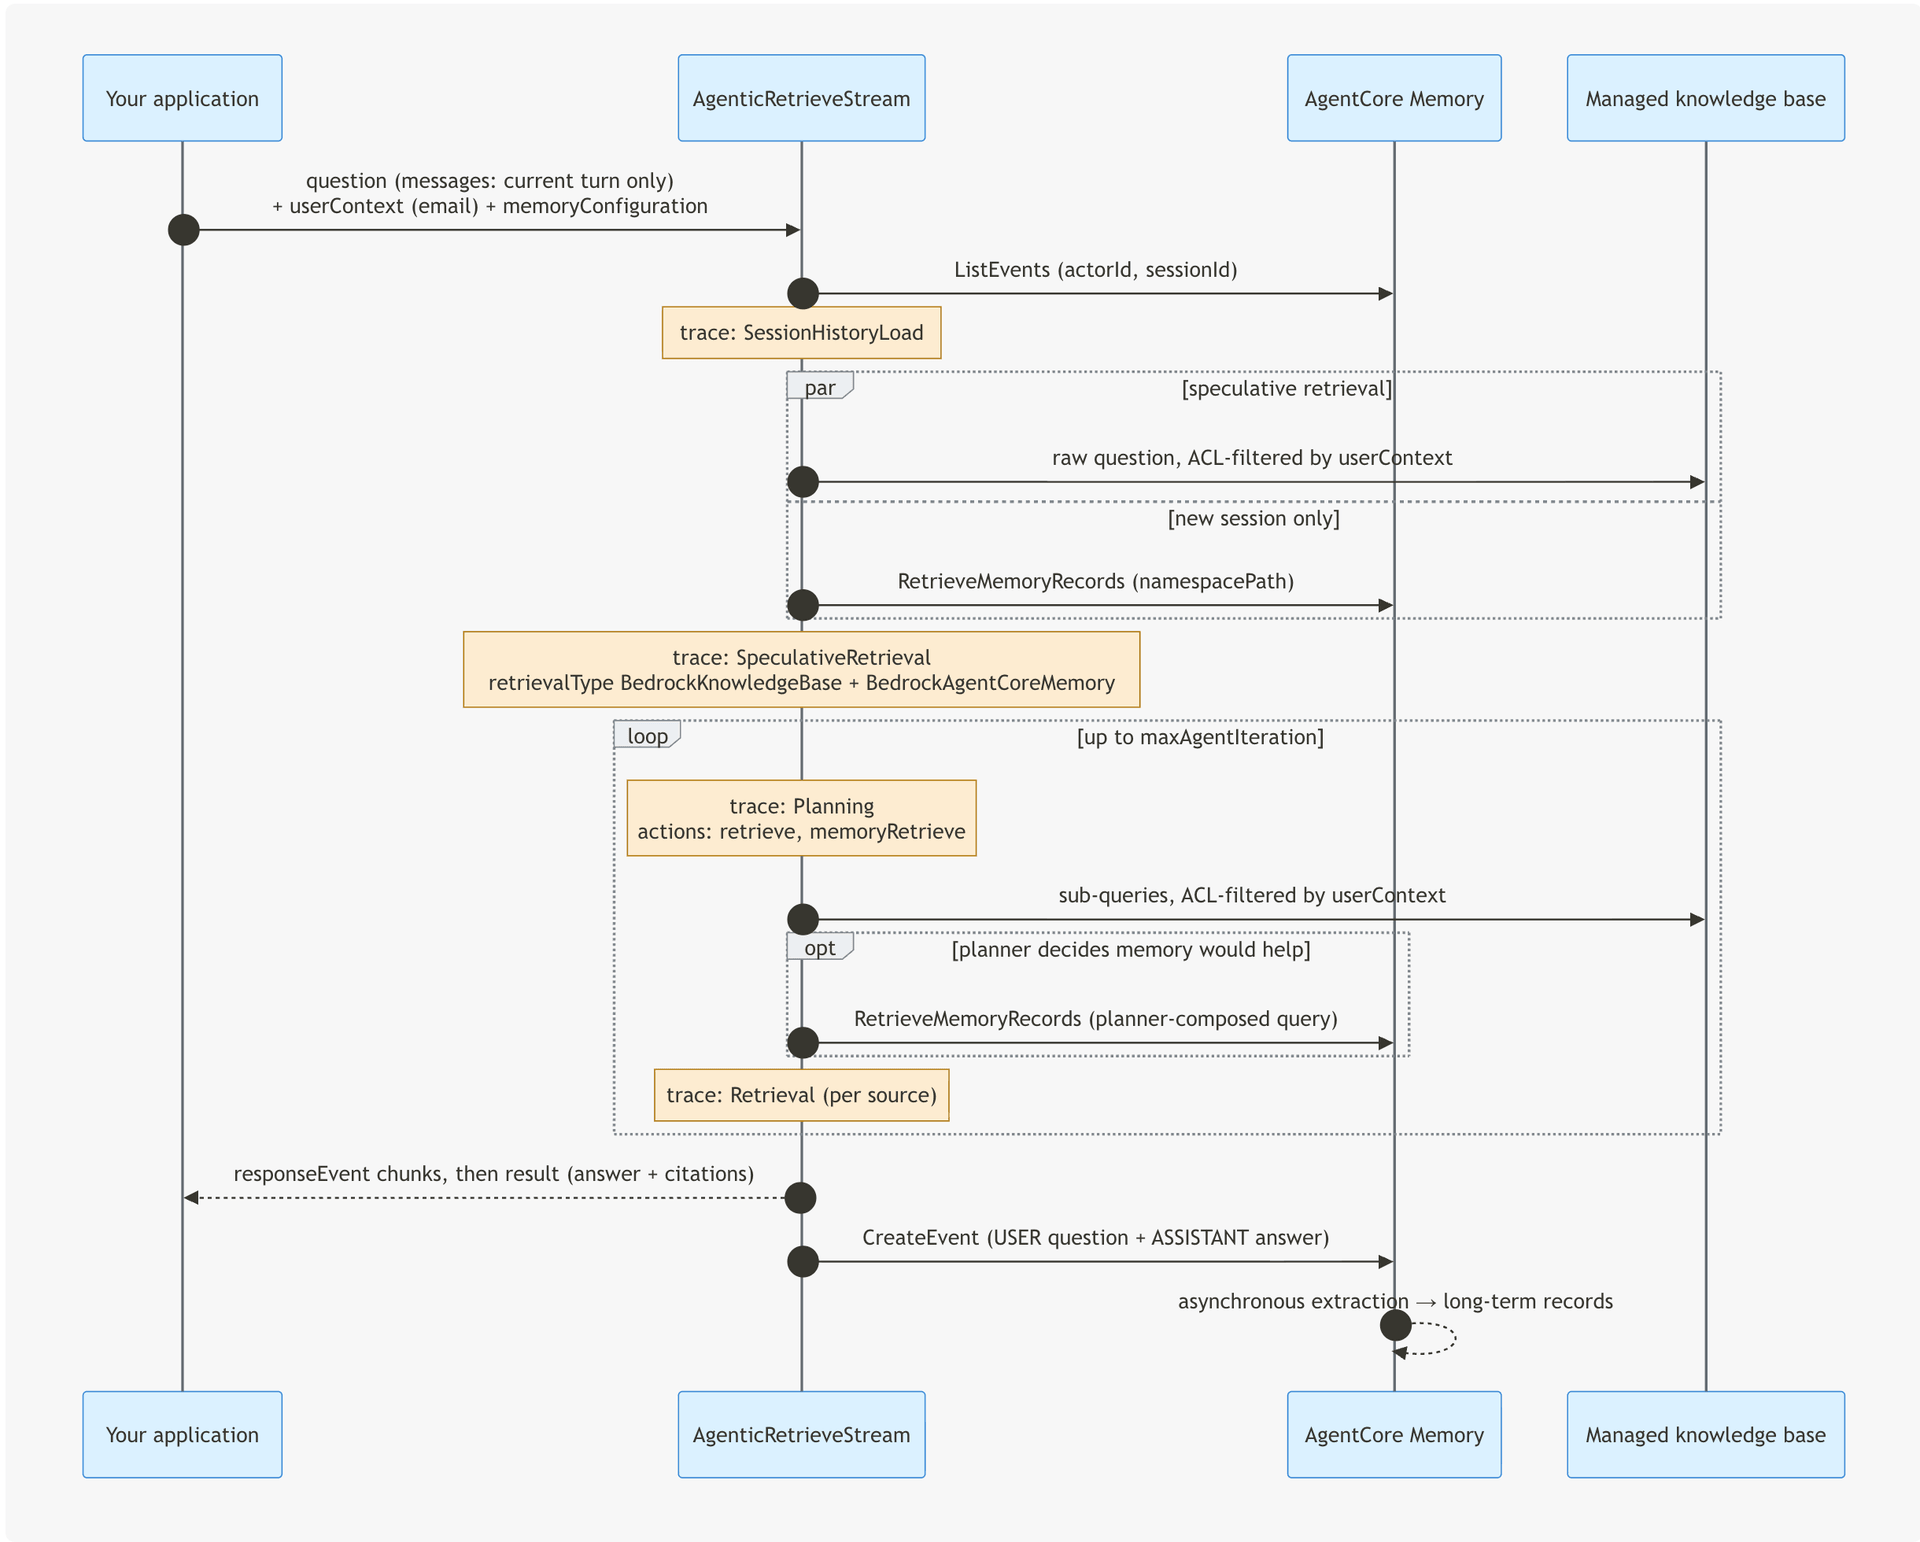
这里减少的是应用层编排。应用仍负责认证和 UI;AgentCore memory 负责存储、保留、加密与提取。作者配置原始事件在 30 天后过期,但没有说明所有长期记录也采用同样期限,不能据此理解成「30 天后全部遗忘」。
同一个用户,为什么要用两种身份
示例中的 AnyCompany 共用一个知识库和一个记忆资源。HR、IT 文档向所有员工开放,工程手册只给工程师,销售提成计划只给销售人员。
文档访问控制列表(ACL)使用 email 匹配员工,记忆却使用 Cognito 的 sub 作为 actorId。原因很具体:邮箱可能改名,也可能在离职后重新分配;记忆身份必须稳定,不能转交给另一个人。
文档权限和个人记忆是两条独立的隔离边界。
后端验证 Cognito ID token 后,把 email 放进 userContext.userId,把 sub 放进记忆身份与命名空间。客户端只提交 { question, sessionId? }。示例还要求 token_use 为 id、email_verified 为真;access token 不携带这里需要的 email。
Cognito 用户池将 email 设为必填、自动验证且 Mutable: False,这个配置在建池后不能修改。接入 Okta 或 Microsoft Entra ID 时,也需要让映射后的邮箱与数据源 ACL 一致。
S3 数据源使用 MANAGED_KNOWLEDGE_BASE_CONNECTOR,来源设为 S3、version: "1",通过 aclEnabled: True 和全局 ACL 文件给文档附上权限。aclEnabled 同样不能在创建后修改。这里需要额外提供供知识库同步的 ACL,并不是说 S3 自身没有访问控制能力。
CreateDataSource 异步完成后要等到 AVAILABLE,再执行 StartIngestionJob 并等待 COMPLETE。样例中 11 份文档全部扫描并索引,失败数为 0。没有 ACL 覆盖的文档不会被摄取;邮箱匹配不到 ACL,或者请求缺少 userContext,都不会返回该数据源的结果。
命名空间还要为检索留出统一入口。由于 retrievalConfigs 只接受一个条目,作者将偏好和摘要放在同一用户根路径下:
- 偏好使用
/anycompany/{actorId}/profile。 - 会话摘要使用
/anycompany/{actorId}/summaries/{sessionId}。
这样 /anycompany/<sub> 才能覆盖两类记录,不必为每个员工创建独立资源。
一次请求接管历史,但身份校验仍在后端
示例使用 us-west-2,要求 Python 3.10 或更高版本、Boto3 1.43.72 或更高版本。记忆资源必须与知识库处于同一 AWS 账户,并达到 ACTIVE 状态。
下面这段请求展示了核心接法:当前问题、文档身份、会话身份和长期记忆范围一起传入。
def build_request(principal, question, session_id):
    return {
        # 使用 sessionBinding 时,messages 只携带当前问题。
        "messages": [{"role": "user", "content": {"text": question}}],
        "retrievers": [{"configuration": {"knowledgeBase": {"knowledgeBaseId": KB_ID}},
                        "description": KB_DESCRIPTION}],
        # 文档 ACL:只检索该邮箱有权访问的文档。
        "userContext": {"userId": principal.email},
        "agenticRetrieveConfiguration": {
            "foundationModelType": "MANAGED",
            "rerankingModelType": "MANAGED",
            "maxAgentIteration": 3,
        },
        "generateResponse": True,
        "memoryConfiguration": {
            "memoryId": MEMORY_ID,
            "sessionBinding": {"actorId": principal.sub, "sessionId": session_id},
            "persistenceMode": "DEFAULT",
            "retrievalConfigs": [{"namespacePath": principal.namespace_path("/anycompany")}],
        },
    }
要盯住 messages 那一行:使用 sessionBinding 后,只传当前问题,不再自行回放历史。persistenceMode: DEFAULT 将问题与最终回答保存为一个事件,因此要求 generateResponse: true;NONE 则恢复历史但不写入。只给 memoryId 也不合法,违反这些约束会收到 ValidationException。
新会话由后端生成 "conv-" + uuid4().hex,作为首个流式帧返回,前端在后续请求中回传。短期记忆按 (memoryId, actorId, sessionId) 定位,因此另一个用户提交相同 sessionId,也只会进入自己的身份空间。
不过,服务不会替应用验证传入的身份和命名空间是否属于当前用户。作者进一步用 IAM 兜底:后端通过 sts.assume_role 携带 userId=<sub> 会话标签,策略据此限制 actorId 和 /anycompany/${aws:PrincipalTag/userId}/*。
权限也随功能拆开:恢复会话需要 ListEvents,检索长期记忆需要 RetrieveMemoryRecords,默认持久化需要 CreateEvent;应用自己的会话列表和记忆查看页分别使用 ListSessions、ListMemoryRecords。
UI 可通过 ListSessions(maxResults=50) 列会话,通过 ListEvents(includePayloads=True, maxResults=100) 读历史。每轮事件包含用户问题和最终答案两个 payload。只有需要会话标题等额外业务数据时,才考虑保留自己的会话表。
我的判断
这套设计最有价值的是责任边界:个人信息可以帮助构造检索问题,文档能否返回仍由 ACL 决定;代码传错记忆身份时,还有 IAM 条件提供第二层限制。这个思路比只在提示词里要求「不要泄露其他用户信息」更适合作为工程边界。
但集成效果和记忆质量要分开看。原文提供了真实运行的 trace 摘录:Maya 查询值班津贴时检索到工程文档,回答为每周 500 USD 或 450 EUR;销售员工 Sofia 的检索只出现 HR 和销售片段。不过,提供的原文到这里就截断了,没有完整展示长期记忆改善回答、跨用户攻击被拒绝的结果。
作者也没有给出延迟、成本、答案准确率,或与自建历史表、手工提取用户资料的对照数据。因此,「减少历史读写代码」有明确依据,「整体更快、更便宜、更准」仍不能下结论。
对于已经使用 AWS 托管知识库的团队,这条路径能省去不少编排。若团队需要精细控制记忆纠错、删除、审核或跨系统迁移,原文没有交代完整机制,仍要单独评估。自行保存历史和用户资料虽然维护工作更多,却能直接决定提取时机与业务规则。
能拿来做什么
- 给企业文档助手拆开文档身份和记忆身份:ACL 使用与数据源一致的身份,个人记忆使用稳定且不会复用的用户 ID。
- 在前端与 Node 后端之间收紧聊天接口,只接收问题和可选会话 ID;email、
actorId、命名空间以及 AWS 会话标签都由后端依据已验证身份生成。 - 迁移已有聊天页时,同时调整历史读取和流式协议:前端接收后端生成的会话 ID,后续只提交当前问题,并为会话列表保留分页处理。
- 用同一个问题测试不同权限用户,再结合 trace 检查检索文档、记忆搜索和子查询;验收时分别记录权限是否正确、记忆是否有用。