规格驱动AI开发:需求入库,代码可追溯
文章将规格驱动开发定义为人与Agent共享的需求契约:规格文件进入版本控制,编码前由人审核,实施过程可追溯到需求条目。核心目标是减少Agent自行猜测需求,以及聊天上下文难以长期维护带来的返工。
AI 深度解读
AI 写代码时,最麻烦的往往是它替你补了需求,而团队没有及时发现。SDD(spec-driven development,规格驱动开发)试图把需求变成可审查、可追踪的文件,让 agent 按明确约定工作,减少对聊天记录的依赖。
原文没有评出哪款工具最好,而是提供了一套判断方法:先看规格如何参与验收,再看工具怎样接入开发。对已经使用 CLAUDE.md 和 plan mode 的团队,这比再装一个工具更值得先想清楚。
写过计划,为什么还不算完整的 SDD
作者给 SDD 设了三个条件:规格文件进入版本控制;人在代码编写前审查并批准规格;开发过程能够追溯到具体需求,解释某段代码为什么存在。
第三条最关键。计划可以告诉 agent 接下来做什么,但未必能说明交付结果满足了哪条约定。SDD 的价值不只在开工前写清楚,还在交付后能核对。
这不是全新的工程思想。作者指出,软件工程讨论类似问题已有四十年,变化在于规格的读者增加了能直接执行任务的 agent。模糊表述不再只引发讨论,也可能立即变成错误实现。
原文用 OpenSpec 的主题切换需求说明,规格应该同时包含预期行为和可检查的场景:
## ADDED Requirements

### Requirement: Theme selection
The app SHALL let users switch between light and dark themes,
defaulting to the system preference.

#### Scenario: User toggles dark mode
- **WHEN** the user clicks the theme toggle
- **THEN** the app switches to dark mode and persists the choice
要留意 THEN 那一行:切到暗色主题只是部分要求,保存用户选择也是验收内容。但这段规格仍没有说明保存位置、保存期限,以及用户如何恢复跟随系统。它提供了检查起点,还需要团队补齐业务边界。
三类 SDD,区别在谁判断代码正确
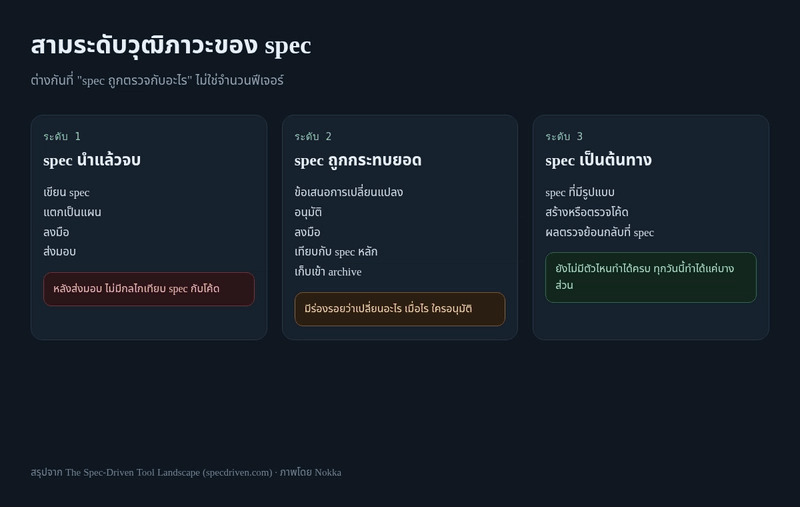
作者把工具形态和规格成熟度分成两个维度。CLI、IDE、framework 决定工具怎样接入工作;spec-first、spec-anchored、spec-as-source 则描述规格与验证的关系。两者不能混着比较。
spec-first 是先写规格,再实现。交付后规格通常作为文档保留,没有持续核对机制。启动容易,但代码继续变,文档容易停在过去。
原文举了一个假设:规格写着每分钟最多接收 500 名用户,后来团队引入队列提高承载能力,却没有更新规格。三个月后,读者仍会把旧数字当成系统现状。这个例子解释的是文档漂移,不是作者提供的性能实验。
spec-anchored 会在交付后继续对照规格和代码。常见做法是把 change proposal(变更提案)与已接受的规格分开,提案通过、实现完成后,再合入主规格。OpenSpec 的 explore-propose-apply-archive 流程体现了这种思路:保留变更理由与审查过程,再更新正式约定。
不过,对账也可能走偏。如果实现不符合需求,审查者直接把规格改成实现现状,记录虽然一致,原来的目标却丢了。
spec-as-source 更进一步,让规格成为生成或检查代码的直接来源。难点是自然语言缺乏机器可以直接执行的严格语义。「体验流畅」到底怎样才算通过,不能靠一句要求自动解决。
作者认为尚无工具完整实现这一理想,并引用 Tessl 的方向变化:早期强调 spec-as-source,后来转向 registry 和 evals,原路线被搁置。这是作者结合资料作出的判断,不能当成所有产品均已实测的结论。
这三类不是必须逐级升级的路线,差别是团队把多少正确性判断交给人和机器。
选工具,先看约束能否落地
作者准备按六项标准比较工具:更适合新项目还是已有代码;约束只是建议,还是由 hook、CI 执行;支持哪些 agent,是否绑定 IDE;代码能否追溯到需求;团队需要维护多少命令和文件;项目的许可证、提交频率和未关闭 issue 是否健康。
这些问题比功能数量更接近日常成本。一个工具能生成 requirements.md、design.md、tasks.md,并不等于它能发现实现偏离需求。Kiro 的文件结构只是组织方式,验证能力仍要单独检查。
原文也提供了热度快照。作者称自己在 2026 年 10 月 24 日通过 GitHub REST API 获取了以下数据:
| 项目 | Star 数 | 原文补充 |
|---|---|---|
| Spec Kit | 142,616 | 创建于 2025-08-21 |
| OpenSpec | 72,868 | 创建于 2025-08-05,约早两周 |
| Superpowers | 304,296 | 创建于 2025-10-09 |
| BMAD Method | 54,489 | 创建于 2025-04-13 |
| Agent OS | 5,537 | 未关闭 issue 为 1 |
| claude-task-master | 28,269 | 最近提交为 2026-04-28 |
claude-task-master 的例子用于提醒:接近三万 Star,也可能近六个月没有新提交。但提交少不能单独证明项目不可用,issue 少也不能单独证明维护良好,还要看项目是否稳定、社区是否活跃。
作者明确承认,目前拿不到多数工具的真实用户数;闭源产品只能检查文档和价格;代码结果的比较还需要让不同工具完成同一任务。这篇是比较系列的第一篇,尚未交付那组实验结果。
我的判断
我赞同把「能否追溯和验证」放在选型前面。对 AI 编程而言,需求文档的价值要通过评审、实现和验收体现,单纯多生成几个 Markdown 文件,很容易增加维护负担。
但原文提供的是分类框架和选型标准,没有给出 SDD 比普通计划模式节省多少时间、减少多少缺陷的对照数据。开头提到两小时的工作拖成两天,也是问题描述,不是统计结论。
它的披露同样需要保留:文章由 deepseek-v4.1-flash 经 ollama-cloud,通过 Hermes Agent 生成,再由 Nokka 监督和检查。这个过程不直接决定内容质量,但工具现状与 Star 数都应视为作者报告的当日快照。
和 CLAUDE.md 加 plan mode 相比,SDD 更有吸引力的部分是需求变更记录和验收追踪。对于短期、小范围任务,人工核对可能已经足够;对于持续维护的功能,规格如何更新才是长期成本。原文也没有证明重型 framework 一定比轻量文件流程有效。
能拿来做什么
- 下次让 AI 实现主题切换时,先把默认跟随系统、手动切换、刷新后保留选择写成场景,再让 agent 实现,并逐条核对结果。
- 在已有前端或 Node 项目中,为一次功能变更保存独立提案,记录修改理由和验收条件;交付时同时检查代码与正式规格是否需要更新。
- 评估 SDD 工具时,要求它处理同一个真实任务,重点检查实现能否对应需求、遗漏能否被发现,以及团队多维护了哪些文件。
- 已经使用 CLAUDE.md 和 plan mode 的团队,可以先补上需求编号与验收对应关系,再判断是否需要引入完整工具链。