用本地模型批量审查需求缺陷
SlothSpec 从规格文件中提取带编号的 shall 语句,标记模糊措辞、待定项、复合要求及缺失单位。它结合本地 Gemma 4 模型给出质量判断和验证方式建议,文章还介绍了 NASA 规格文档试用。
AI 深度解读
把需求文档交给 AI,难点往往不是让它挑出毛病,而是让它别把整份文档都判成有问题。SlothSpec 的作者用一台 16 GB 内存、集成 AMD 显卡的笔记本,审了一份 97 页的 NASA 标准:最终提取出 333 条需求,模型仍标记了其中 238 条,真正被放到报告最前面的只有 42 条。
这个项目值得看,是因为作者把误报、失败实验和回退都摊开了。它展示了一条更务实的路线:规则负责稳定筛查,本地模型补充判断,工程师保留最终决定权。
为什么规则和模型要分两层
作者做过空军和国防航空航天行业的数字系统工程管理,累计约十年。他发现,很多需求反复栽在相同的问题上:措辞模糊、数值待定、一个句子塞进多个要求,或者写了数字却没有单位。
SlothSpec 接收 .docx、.pdf、.txt、.md,提取包含 shall 的需求及其 ID,再给出问题标记、质量评级、验证方法和改写建议。验证方法分为 Inspection、Analysis、Demonstration、Test,还要说明测试人员具体做什么。
第一层不用模型,直接检查 TBD、and/or、if possible、including but not limited to、minimize,以及缺单位的数字等模式。它快、结果稳定,审查人员也容易解释为什么提出这条意见。
第二层才调用 Gemma 4,把需求和规则命中的问题一起送进去。模型通过 Ollama 的 format 参数返回固定 JSON schema,temperature 设为 0,避免程序再从一大段自然语言里猜字段。
下面这条宠物喂食器需求,暴露了两类典型问题:
SPF-022 The SPF shall be robust to tampering by pets, including but not
        limited to pawing, tipping, and chewing.
要看的是 robust 和 including but not limited to:前者没定义承受能力,后者让测试范围没有边界。Gemma 4 给出的改写是:
The SPF shall withstand pawing forces up to <<max force, N>> without functional degradation.
The SPF shall withstand tipping forces up to <<max force, N>> without functional degradation.
The SPF shall withstand chewing forces from <<pet type>> without functional degradation.
这里最有价值的是 <<max force, N>>:缺失的指标留给工程师补,模型不允许编造数字。但第三条仍缺少啃咬力度,说明拆成三条之后,也不等于需求已经合格。
工具还提供 watch mode,文件放入目录后,报告会出现在 reviewed/;缓存让修改 3 条需求后只重审这 3 条;CSV 则方便把意见放进审查矩阵。它围绕的是工程师已有的审查流程。
玩具测试跑通,为什么还会被真实 PDF 击穿
作者先写了一份故意有问题的智能宠物喂食器规格:20 条需求,其中 15 条埋了缺陷,5 条正常。
v0.1 抓到了全部 15 条缺陷,却也误报了 5 条正常需求中的 4 条。它甚至嫌 shall not 是否定表述,改写后又用了意思相同的 does not exceed。这一轮耗时 14.7 分钟。
v0.2 加入了 good、needs work、rewrite 的评分准则和示例。作者发现最初的示例直接来自测试文档,等于提前给答案,于是换成雷达、水泵和加热器。另一个提速点是关闭默认开启的 thinking mode:设置 think: false 后,耗时从 14.7 分钟降到 5.2 分钟。
v0.3 尝试用小模型 e2b 评分、大模型 e4b 只改写被标记的需求。结果误报少一些,却更慢,改写也没有变好。再给编辑模型增加 scratchpad,让它寻找评分模型遗漏的问题,它反而编出了喂食器固件完整性检查。作者回退了方案,默认保留单个 e4b,玩具规格耗时为 3.4 分钟。
真正的考验来自 NASA Kennedy 的地面支持设备设计标准 KSC-DE-512-SM。
最先失效的是 PDF 提取。v0.3 抽出 451 条所谓需求,混进页脚、目录、修订历史,还把引用标准 IPC-6018 错当成 16 条需求的 ID。
修复靠的是文档处理:去掉跨页重复内容、跳过带点引导线的目录、按原文层级生成 5.4.7a 和 6.3.1.1b(2)(a) 这样的编号,要求章节号递增,并在文末政府表格之前停止。清理后才得到 333 条带真实 ID 的 shall 需求。
规则同样需要校准。Table 1、NFPA 70 被当成缺单位的数字,正常的标准措辞被当成语态问题。调整后,规则标记从 224 降到 104,作者称真正的问题仍然保留。
输入提取错了,模型再认真,也只是在审查一份被程序拼坏的文档。
238 条警报里,为什么只把 42 条排在前面
解析修好了,模型又开始过度挑错:333 条需求里,它标记了 312 条,占比 94%。
其中 141 条都在抱怨需求依赖外部标准。例如真空系统按 ASME B31.9 设计,在这类工程文档中是正常写法,验证时按对应标准检查即可。作者给评分准则补了一条说明,并使用 NASA 文档里没有出现的 FCC Part 15 举例,再完整跑了一轮。
最终报告显示,模型标记 238 条,约占 71%。作者承认,这仍然太高。
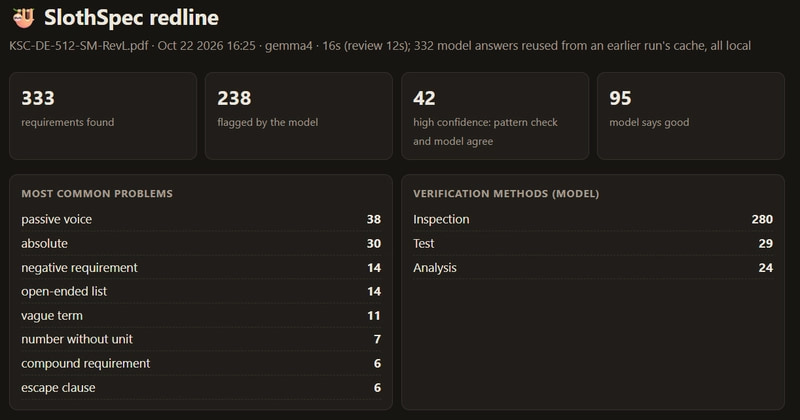
报告于是优先展示规则与模型都命中的 42 条,加上绿色 high confidence 标记和筛选按钮。工程师先审这些,再浏览其余结果。
部分意见确实具体:4.2.3.4j 的「风险降低到可接受水平」缺少接受标准;6.4.8c 的「尽可能靠近」可以改成 within <<distance, mm>>;6.2c 的「按要求认证」没说明要求来源。模型还发现 4.2.3.1a 对冗余系统的物理布置或隔离没有给出隔离判据,这类问题很难只靠关键词捕获。
但改写也可能改变需求含义。作者在每次运行、每个模型上都遇到同一个问题:food-safe materials and/or BPA-free plastic 被改成两项必须同时满足的要求,即把原来的选择关系收紧成 AND,即使专门加提示词也没解决。
本地运行则有明确的使用前提。作者的技术栈是 Python、Ollama 和 Google 开放权重 Gemma 4,模型标识包括 gemma4,也称 e4b,以及 gemma4:e2b。文档不离开机器,不需要 API key,没有按 token 计费。
对无法上传专有文档的工作环境,这是工具能否使用的门槛。作者实际演示的只有虚构喂食器规格和公开 NASA 文档,没有使用工作数据。他用 Claude 辅助写代码和测试,再在自己的笔记本上运行各版本,把实际结果反馈回去。
我的判断
我认可这个项目把 AI 放在「初审助手」的位置。规则筛重复问题,模型补语义判断,人处理工程取舍,分工很清楚。相比直接把整份规格交给聊天机器人,它还能保留需求编号、输出固定字段、缓存增量结果,更容易接进持续审查。
但 42 条 high confidence 只是规则与模型的一致结果,原文没有逐条人工标注的准确率,也没有统计剩余需求中漏掉了多少问题。两层都命中,可能只是同时对某种措辞敏感。这个标签适合决定阅读顺序,不能当成质量认证。
性能数据也有边界。玩具规格从 14.7 分钟到 5.2 分钟、最终默认方案 3.4 分钟,伴随提示词和流程调整,不能把所有提升归给一个参数。NASA 文档不到一小时跑完,是作者这台机器上的实测;原文没有给出足够的硬件、推理配置和重复测量信息供一般团队复现同样速度。
作者认为前沿云模型会更快、质量可能更好,但没有提供对照数据。小模型更适合评分、大模型更适合编辑,也只是这些实验里的观察。混合方案最终被回退,恰好提醒我们:增加一个模型角色,需要用最终效果证明价值。
这套方法适合减少机械审查的负担,不能证明需求在工程上已经正确。
能拿来做什么
- 给日常 AI 编程增加一次需求初审。在生成代码前,先找出「尽快响应」「尽可能兼容」「按要求处理」这类表述,要求补充验收条件;缺失指标保留占位符,由需求负责人确认。
- 如果用 Node 或 Python 做文档审查脚本,先验证提取出的正文、编号和引用位置,再接模型。SlothSpec 的 PDF 实验说明,解析质量会直接决定后续意见是否有用。
- 为需求审查保留稳定样本,既放故意有问题的需求,也放合格需求;评分示例使用不同领域的内容,避免把测试答案写进提示词。调整后同时检查漏报、误报和耗时。
- 把 AI 改写作为待确认建议。遇到
and/or、否定条件、外部标准引用时,逐条核对逻辑是否改变,并利用结构化输出和 CSV 把意见送回现有审查流程。