把积压工单交给云端编程智能体
一家约 40 名工程师的金融科技团队,让云端编程智能体接收 Jira 或 Slack 任务并提交 PR,以处理长期积压的小修复。两名工程师用约六天搭建初始核心,标题称目前约 40% 的 PR 可一次完成。
AI 深度解读
两名工程师花约 6 天搭好核心,随后让 AI 接着开发这套「软件工厂」:从 Jira 或 Slack 接任务,在云端修改代码,再提交 PR。作者团队报告,约 1,100 个 PR 中,40% 一次就达到了预期。
但更值得读的不是这个比例,而是另一个数字:一张积压 85 天的工单,AI 用 10 分钟交出两个 PR,最终上线却又花了 22 个自然日。这篇实践真正回答的是,代码写快之后,团队还得补上哪些环节。
软件工厂多做的,是把任务接进团队流程
作者来自斯德哥尔摩的金融科技公司 Billogram,约 40 名工程师负责欧洲的周期性支付业务。技术栈包括 AWS、Kubernetes、serverless、Python,以及部分遗留 PHP。新市场、复杂功能和监管工作优先,小修小补长期排不上队。
他们搭建的流程很直接:在 Jira 或 Slack 描述任务,coding agent 在云环境里进入代码仓库工作,最后提交 PR。
核心分成两个仓库。编排器(orchestrator)接收 webhook、组装提示词、分发短期凭证;云端 agent 环境提供仓库目录、构建工具和描述团队工作方式的 skills,每次执行遵循对应仓库的 AGENTS.md。
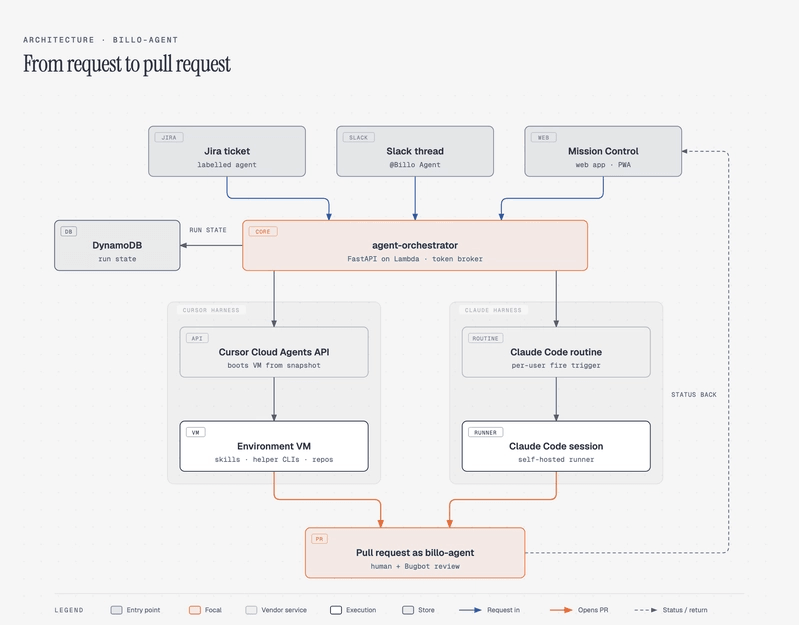
两名工程师用了约 6 天搭出第一版。在系统能够自行启动 agent 前,他们先手动启动云端 agent。之后的模式是:人搭骨架,工厂继续迭代,人负责审查和合并。
目前仍留在代码中的内容,编排器有 89%、agent 环境有 97% 由工厂编写。两个仓库合计 639 个已合并 PR,其中 596 个由工厂发起。这是存量代码行占比和 PR 来源统计,不能直接当成人力节省比例。
具体产出比百分比更有参考价值:Jira 接入由一个工单完成,约 6,000 行代码;他们最初刻意使用 Linear,避免学习期间误触真实 Jira 看板,切换后再让工厂移除 Linear。运行管理页面 Mission Control 由人做初版,工厂追加约 30 个 PR,补上工具调用日志、提示词启动入口、仓库过滤、移动端布局和暗色模式。
执行端同时使用 Cursor Cloud 和 Claude Code 的自托管 runner。作者称,后者每个会话获得 AWS 账户内按需启动的 Lambda microVM,发起人可通过 Claude app 实时查看和引导。
系统还有一个反馈回路:运行后复盘并生成改进工单;PR 合并后,把审查意见整理进 AGENTS.md;Slack 里的部分支持问题也会转成工单。所谓「自己建设自己」,仍然依赖人确定目标、完善需求和决定合并。
40% 一次通过,能说明多大程度的成功
从 8 月 31 日到 10 月 22 日,工厂发起约 1,100 个 PR。原文没有注明年份,结果大致分成三类:
- 约 40% 被称为 one-shotted,即首次产出就符合预期。
- 约 50% 需要返工,但已有可用基础,审查者在 PR 中反馈,工厂继续修改。
- 剩余约 10% 偏差较大,关闭且未合并,作者主要归因于场景不合适或工单准备不足。
40% 是首轮产出符合预期的比例,不是无人审查、自动上线的比例。
早期每天约处理 30 张工单,多数来自工厂自己的待办。最繁忙的一周从 9 月 28 日开始,有 245 次会话、219 个合并 PR。整体会话约 53% 使用 Cursor Cloud,47% 使用 Claude Code,后者晚近三周加入。但原文没有按任务难度、成本和成功率分组,无法据此判断谁更强。
两个案例说明了它可能做到什么。
一次遗留 PHP 服务升级,团队只要求升级到最新语言大版本、采用当前 OS 基础镜像并修复问题。agent 运行数小时,下载不同语言版本的 C 源码,与业务代码对照,发现舍入实现变化:把 126.045 保留两位小数,现有版本和其余较新版本返回 126.05,最新版本返回 126.04。
对每月处理数百万笔交易、年支付规模约 50 亿瑞典克朗(5B SEK)的系统,这一分钱值得追查。但原文没有给出 PHP 版本号、调用函数或完整测试代码,读者不能据此认定自己的服务也有同样问题。它展示的是一次主动调查行为,不是可直接复现的兼容性结论。
另一张积压 85 天的工单,10 分钟后产生前后端两个 PR,共 440 行,包含测试,其中部分后端逻辑从零实现。人工总投入约 3 小时,包括验证、审查和发布;两项审查问题分别由 agent 用 12 分钟、7 分钟修复。
作者估计,同样任务不用 AI 需要 1 至 2 天,使用 IDE 内 AI 需要 4 至 8 小时,使用工厂需要 2 至 3 小时。这些是团队估算,缺少对照实验;约 3 小时的实际人工投入,则更适合拿来理解流程成本。
真正卡住交付的,是审查和负责人
前面那张工单虽然十分钟就出了 PR,却用了 22 个自然日才上线。
原因是试验由领域团队之外的开发者发起,所属团队没有提前参与,大家仍在完成既定承诺。系统能产出代码,却不能替团队安排审查时间,也不能自动确定谁对结果负责。
作者因此提出:必须由领域内开发者从头到尾负责,团队提前预留审查容量。
大 PR 会进一步放大问题。一次监控看板开发跨仓库产生 4 个 PR,约 2,000 行代码,认真审查可能花掉与手写接近的时间。他们让每个 PR 附带 Decisions and assumptions,解释 agent 自行作出的决定和假设;提交前清理自己的 diff;较大任务用 GitHub stacked PRs 拆成有依赖关系的小 PR。
这些是缓解办法。作者明确承认,大规模 AI 代码审查还没有解决。
因此,工厂始终只通过 PR 修改代码,先开 draft,再接受另一个 AI agent 和任务报告人的审查,回答意见并推送修复,从不自行合并。基础设施修改同样提交到基础设施仓库,由 infra 团队规划和应用。
产品任务则由 PM 和工程师先完善工单,提前确认方案与可行性。工程师的系统知识应当出现在任务开始时,而不是收到成品 PR 后才被迫介入。下一步让 agent 访问 QA 环境、验证部署后的服务,目前仍是计划。
我的判断
我赞同作者把重点放在规格驱动开发(spec-driven development)上。这里的「规格」不是把一句话写长,而是提前说明目标、边界和验收方式,让审查能够对照约定检查结果。
这套实践也有明显前提:他们已有构建工具、仓库规范、审查流程,以及能把模糊需求整理清楚的工程师。工厂早期又主要处理自己的待办,不能直接推断它在所有业务仓库里都能保持相同表现。
相较于直接把工单贴进 Cursor 或 Claude Code,工厂增加的价值主要是统一入口、执行环境、记录和反馈沉淀。作者自己也承认,目前还不是剧烈变化。若团队任务量不大,编排系统的维护成本可能需要单独核算;原文没有提供模型费用、基础设施成本或长期维护投入。
代码生成速度可以压缩,实现之外的等待不会自动消失。
40% 首轮命中值得继续观察,PHP 案例也足够有启发,但都不足以证明整体生产率提升了某个固定倍数。更可靠的经验是:越能提前明确负责人、验收要求和审查安排,越容易把生成的代码变成真正交付。
能拿来做什么
- 先从需求清楚、风险较低的前后端积压任务试起,在工单中写明涉及仓库、预期行为和验证方法,并指定一名领域内开发者负责交付。
- 在 PR 中要求 agent 写出
Decisions and assumptions,尤其说明自行补充的业务假设;跨前后端或改动较大的任务,提前拆分审查范围。 - 把反复出现的审查意见整理进
AGENTS.md,由人确认规则是否通用,让后续任务复用,而不是让同一问题每次重新解释。 - 同时记录生成耗时、人工验证与审查时间、最终上线时间。评估是否需要软件工厂时,用完整交付周期和维护成本判断,别只看出了多少 PR。