网站提供 Markdown,能否改善 AI 访问
文章区分 llms.txt、独立 Markdown 页面和基于 Accept 请求头的内容协商,解释各自服务的工具与代理。其核心判断是:改善代理读取文档的体验,不等于提高 Google 搜索或 AI 搜索曝光。
AI 深度解读
给 AI 提供 Markdown,能让文档更省 token,但未必能让网站获得更多搜索流量。原文最有价值的地方,是把这两件常被混在一起的事拆开:搜索引擎如何收录内容,和编程助手如何读取文档,解决的是不同问题。
如果你维护开发者文档、API 参考或 SDK 指南,这篇值得读。它给出了 Next.js 的接入思路,也划出了边界:格式可以变,内容不能偷偷加料。不过,示例代码距离生产可用还有几处需要补齐。
省 token 和增加搜索曝光,是两笔账
原文讨论了三个容易混淆的东西:作为文档入口的 /llms.txt、页面的 Markdown 版本,以及通过 Accept: text/markdown 请求这种版本的内容协商。内容协商,就是同一个地址根据客户端声明,返回不同格式。
先看搜索曝光。按原文转述,Google 的 Gary Illyes 在 2025 年 7 月表示,Google 不支持 llms.txt,也没有支持计划。2026 年 5 月的 Google 搜索 AI 功能指南进一步说明,面向这些功能的优化仍属于 SEO,不需要 llms.txt 或特殊机器可读格式。
原文引用的 2026 年日志研究称,GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot 很少请求 /llms.txt,主要还是抓取 HTML。SE Ranking 对约 30 万个域名的研究发现,采用率约为 10%,没有测出它与被引用之间的关联。
这些证据支持的是「尚无可测量的引用收益」,不能推成所有场景都绝无收益。
再看文档读取。Cloudflare 在 2026 年推出 Markdown for Agents:请求的 Accept 头包含 text/markdown 时,将 HTML 转为 Markdown,并通过 x-markdown-tokens 返回估算大小。它展示的一篇博客,从约 16,000 tokens 降到约 3,000 tokens。
降低上下文开销有具体案例,提高搜索排名则缺少证据。
原文还转述了 John Mueller 对面向 SEO 向机器人提供 Markdown 的批评。这与 Cloudflare 的产品并不冲突:搜索爬虫会解析 HTML,编程助手却需要在有限上下文中容纳文档。导航、页脚和重复结构占得越多,留给接口说明与代码的空间就越少。
什么样的网站值得提供 Markdown
最适合的是开发者文档。用户把链接交给 Cursor、Claude Code 或 ChatGPT,希望助手据此调用 API、解释参数或编写接入代码。清晰的 Markdown 可以减少页面杂项,让正文更容易进入上下文。
原文列举了 Stripe、Anthropic、Cloudflare、Vercel 提供 llms.txt 或 Markdown 文档的做法。这里的价值是方便工具读取,不能把这些公司的采用行为当成 SEO 效果证明。
另一类是 Agent 代表用户查询的产品目录或知识库。不过,原文没有提供这些场景的准确率、延迟或转化率对照,适用性仍要结合访问方式判断。
如果只是一个营销网站,希望多放一个文件就增加 Google 排名或 ChatGPT 引用,现有材料不足以支持投入。内容是否有用、页面能否正常抓取,优先级更高。
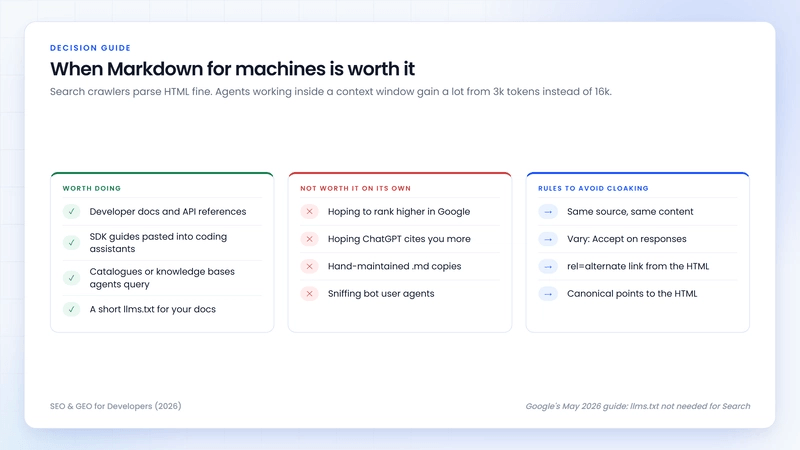
同一份内容,怎样安全地返回两种格式
原文提醒的风险是内容伪装(cloaking):给机器人和普通用户展示不同内容。按其转述,Google 的相关垃圾内容政策从 2026 年 5 月起,也明确适用于 AI Overviews 和 AI Mode。
因此,Markdown 应从 MDX、CMS 或渲染后的 HTML 自动生成。正文可以换格式,但不能塞入网页里没有的额外承诺、关键词或「给 AI 的说明」。
Next.js 示例用下面这段中间件,把 .md 地址和明确请求 Markdown 的访问重写到接口:
// middleware.ts
import { NextResponse, type NextRequest } from "next/server";

export function middleware(req: NextRequest) {
  const { pathname } = req.nextUrl;
  if (!pathname.startsWith("/docs")) return NextResponse.next();

  const accept = req.headers.get("accept") ?? "";
  const wantsMarkdown =
    pathname.endsWith(".md") ||
    // Only when Markdown is explicitly listed. Browsers send text/html and */*.
    /(^|,)\s*text\/markdown/i.test(accept);

  if (!wantsMarkdown) return NextResponse.next();

  const slug = pathname.replace(/^\/docs\/?/, "").replace(/\.md$/, "") || "index";
  const url = req.nextUrl.clone();
  url.pathname = `/api/md/${slug}`;
  return NextResponse.rewrite(url);
}

export const config = { matcher: ["/docs/:path*"] };
关键是判断 wantsMarkdown 的那一行:浏览器常带 */*,不能据此就返回 Markdown。不过,这个正则没有完整处理 Accept 的权重与优先级,例如 text/markdown;q=0 仍会匹配,正式接入时需要完善。
接口部分使用 node:fs/promises 的 readFile 读取 content/docs 中的 .mdx 文件,以 gray-matter 去掉 front matter,再调用 stripJsx 移除组件标签。它接收的 params 类型是 Promise<{ slug: string[] }>,需要先 await params。
响应必须带上 Content-Type: text/markdown; charset=utf-8,并设置 Vary: Accept,让缓存区分两种格式。否则,浏览器可能拿到 Markdown,Agent 也可能收到 HTML。
搜索归属则保留给 HTML:示例使用 Link: <https://example.com/page>; rel="canonical";原文也提供了通过 X-Robots-Tag: noindex 排除 .md 搜索结果的选项。HTML 页面通过 generateMetadata 中的 alternates.types 声明替代格式,对应 rel="alternate"。示例缓存时间是 Cache-Control: public, max-age=3600。
最后用原文命令检查响应:
curl -s https://example.com/docs/auth | head -c 200                           # HTML
curl -s -H "Accept: text/markdown" https://example.com/docs/auth | head -20  # Markdown
curl -sI -H "Accept: text/markdown" https://example.com/docs/auth | grep -i -E "content-type|vary|link"
重点检查第三行的 content-type|vary|link,同时确认前两行返回的正文确实对应同一篇文档。
我的判断
我赞成按读取需求提供 Markdown,也赞成不按 User-Agent 猜测访问者身份。客户端声明需要什么格式,服务端就按协议处理,行为更容易理解和验证。
但原文的「Markdown 对 Google 排名没有作用」说得偏满。它展示的材料主要证明 Google 不要求这种格式,以及研究未发现引用关联;没有隔离其他变量的完整实验。对编程助手「帮助很大」的判断,也主要来自 token 缩减案例,没有答案质量的对照数据。
代码更适合当接入草图。stripJsx 用正则删除组件标签,可能把组件通过属性或运行逻辑生成的关键信息一起丢掉;文件路径只用 startsWith(DOCS_DIR) 检查,也不足以严谨验证目录边界。原文没有说明 Next.js 版本和部署文件打包方式,不能默认复制后就能上线。
Cloudflare 托管转换可以减少维护工作,但依赖套餐是否包含 Markdown for Agents。直接从源文件生成更便于控制文档结构,代价是自行处理组件语义。两种方式没有质量对照,应拿自己的文档验证。
能拿来做什么
- 如果你维护 API 或 SDK 文档,先选认证、错误处理等高频页面生成 Markdown,检查参数、代码和组件内容是否完整,再让编程助手完成同一个接入任务,对比读取开销与答案质量。
- 如果你准备接入 Next.js,先完善 Accept 权重解析、目录边界校验和 MDX 转换,再检查 CDN 是否正确处理
Vary: Accept。 - 如果你已有文档导航配置,可以在构建时生成简短 llms.txt,列出认证、支付、Webhook 和更新日志入口,避免人工维护导致链接过期。
- 如果你的目标是增加搜索曝光,优先检查内容质量与可抓取性;把 Markdown 的投入记作文档读取体验改进,不要承诺尚未验证的排名收益。