为工具调研智能体加上隔离测试与执行护栏
toolsmith 定期调研替代工具,在临时容器中测试候选项,再通过 Discord 请求人工决策。文章还复盘测试缓存目录导致安装中断的问题,并用执行 README 步骤的测试发现故障。
AI 深度解读
让 Agent 每周替你研究一款工具的替代方案,先在临时容器里测试,再到 Discord 等你确认,听起来像一套自动化选型流程。toolsmith 更有意思的地方,是它把证据和权限都设成了门槛:没有测量事实支撑的建议不提交,执行前还要经过守卫检查。
作者的安装指南也暴露了一个很实际的问题:测试通过,不代表用户照着 README 就能装成功。对正在给 Agent 接终端权限的程序员,这篇短文值得看的正是这些工程细节。
替代方案先测过,再交给人决定
toolsmith 是一个 Hermes Agent 配置档案(profile),面向作者自己的家庭实验室。它每周挑一个领域,研究现有工具的替代品,把最合适的候选放进可丢弃容器里测试,再通过 Discord 请求 ✅ / ❌ 确认。无法用测量事实支撑的内容会被扣下。
这里有两层约束:建议需要证据,批准需要身份。配置中要指定 Discord 频道和用户 ID,只有指定用户的 ✅ 才算数。
完整流程依赖 Hermes Agent、Proxmox 和真实容器,还要配置 Proxmox 节点、允许使用的沙箱容器,以及两个定时器。原文没有展开定时器的具体安排,也没有展示某次工具替换的测量结果。因此,能确认的是流程设计,不能据此判断它选出的工具一定更好。
13 项测试通过,为什么安装仍然失败
README 原先要求先运行测试,再执行 install.sh。问题就出在这个顺序:测试留下了 scripts/__pycache__ 目录,安装器用 install -m 0755 scripts/* 复制文件时碰到目录,命令失败;随后 set -e 让安装中途停止,profile、配置和数据文件都没有装好。
修复方式很直接:安装器只复制文件。
下面这段命令解决的是从获取代码到安装的最小验证路径:
git clone https://github.com/casareanderson/toolsmith && cd toolsmith
python3 -m unittest discover -s tests       # Ran 13 tests ... OK
HERMES_HOME=$HOME/.hermes ./install.sh
要留意第二行与第三行的先后关系。作者此前没有在干净机器上完整走过这个顺序,首次运行「照着指南操作」的测试就发现了问题。
测试 README 中的操作路径,也是在测试产品。
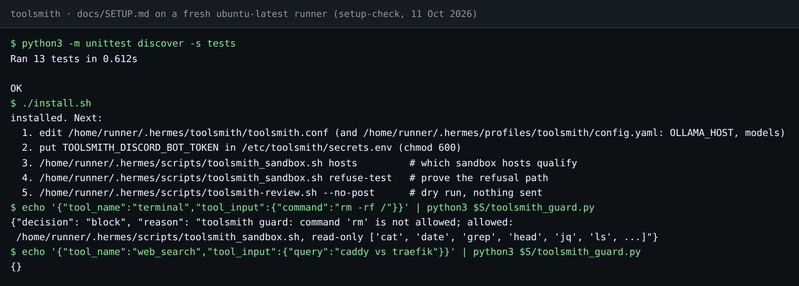
作者现在每周会在全新的 Ubuntu 环境里运行这些基础步骤。图中展示了 13 项测试、安装器,以及守卫阻止 rm、允许网页搜索的检查:
守卫必须在工具执行之前生效
toolsmith 的守卫是一个 pre_tool_call 钩子,每次工具调用发生前都会先经过它,并通过标准输入接收 JSON。
下面两次调用分别验证危险终端命令和正常搜索:
S=$HOME/.hermes/scripts
echo '{"tool_name":"terminal","tool_input":{"command":"rm -rf /"}}' | python3 $S/toolsmith_guard.py
echo '{"tool_name":"web_search","tool_input":{"query":"caddy vs traefik"}}' | python3 $S/toolsmith_guard.py
重点看两个 tool_name 对应的结果:第一条返回 "decision": "block",并列出允许的操作;第二条返回 {},表示放行。
守卫采用 fail_closed:即使守卫自身崩溃,工具调用也会被阻止。大白话就是,检查系统坏了,也不能直接通行。
其他检查同样围绕拒绝和预演展开:toolsmith_sandbox.sh refuse-test 会故意申请过多内存,预期结果是被拒绝;toolsmith-review.sh --no-post 则运行完整预演,但不向 Discord 发送内容。bot token 放在环境文件里,不写进配置文件。
不过,每周的干净环境验证只覆盖到守卫。Discord、Proxmox 和真实容器之间的完整联动,并没有纳入这条验证路径。
我的判断
我认同它把权限检查放在执行前,也认同它测试安装顺序和拒绝路径。这些都有具体操作支撑,比单纯要求模型「谨慎使用终端」更容易检查。
但原文只展示了阻止一条 rm -rf / 和放行一次搜索,没给出完整规则,也没展示其他命令形式的覆盖情况。标题里的「不能运行 rm」,不能扩大理解成「终端操作已经全面安全」。
与单元测试相比,照着 README 在干净环境里操作,确实补上了集成环节;但它仍未覆盖完整业务链路。至于这种 Agent 是否比人工选型更省时、建议是否更可靠,作者没有给对照数据,目前只能当作个人 homelab 的实践经验。
能拿来做什么
- 给 Node CLI 或内部工具增加一条干净环境验证,严格按 README 的顺序执行,特别检查测试产物是否会影响安装。
- 给 AI 编程助手接终端前,设置执行前的权限检查,并明确检查器报错时应阻止调用。
- 为会发消息或创建资源的自动化提供预演入口,同时加入「申请应被拒绝」的反向检查。
- 让 Agent 做工具选型时,要求建议附带可复核的测量事实;缺少证据的候选先保留,最终决定交给指定负责人。