单张4090部署 Sage-A1.5 的资源与参数坑
文章介绍使用原版 llama.cpp 在 RTX 4090 上运行 Sage-A1.5,官方 Q4_K_M 量化文件约 22GB。重点涉及推理参数、请求并发、令牌预算和自检提示,并解释 MoE 活跃参数与完整权重内存需求的区别。
AI 深度解读
Sage-A1.5 能不能在一张 RTX 4090 上跑研究型 Agent?作者的实测答案是可以,但部署成败不只取决于显存。模型卡里的错误参数、服务端并发限制、被推理过程吃掉的 token 预算,都可能让一个能加载的模型变成不好用的服务。
这篇最有用的部分,是把「模型跑起来」和「Agent 真能工作」之间的坑拆开了。至于自检模式是否值得开,作者给出的结论很克制:先在自己的难题上测,简单查询可能只是多花时间。
24 GB 能装下,为什么还要看上下文和并发
Sage-A1.5 来自上海人工智能实验室,Hugging Face 组织名为 InternScience,论文署名包括 Wenjie Lou 和另外 98 位作者。它基于 Qwen 团队的开放 35B 模型和实验室此前的 Agents-A1 再训练,官方提供约 22 GB 的 Q4_K_M GGUF,采用 Apache-2.0 许可证,原版 llama.cpp 就能加载。
它采用混合专家架构(MoE):256 个专家块中,每个 token 经过 8 个,再加一个共享块。因此,磁盘上有 350 亿参数,每个 token 实际激活约 30 亿。
作者用「速度看 30 亿,内存看 350 亿」解释这个差别。这个理解有助于估算,但不能把激活参数量直接当作吞吐保证。
显存预算要覆盖完整权重、上下文和并发请求,不能只看激活参数。
作者在单张 RTX 4090 上测得,32,768 tokens 上下文、两个并行槽位、纯文本时,峰值占用为 21.3 GiB,显卡可用容量为 23.5 GiB。64K 上下文加视觉输入占 23.1 GiB,128K 纯文本占 23.4 GiB,测试中没有速度下降。32K 配置下,单请求约输出 136 tokens/s,首 token 等待约四分之一秒。
低于 24 GB 时,llama.cpp 可通过 --n-cpu-moe 把部分专家放进系统内存。但作者只模拟了小显存环境:模拟 16 GB 时约慢 5.6 倍,研究题仍答对了。他们没有测试真实的 16 GB、12 GB 显卡,也没有测 RTX 3090 或未压缩模型。
因此,这些数字适合用来规划试验,不能直接变成其他显卡的性能承诺。
Agent 卡住,先查参数、队列和 token 预算
第一个坑非常直接:模型卡给出的启动参数会让服务退出。
下面两行展示了错误值和 llama.cpp 接受的值:
--reasoning-format deepthink   # llama-server exits: "Unknown reasoning format: deepthink"
--reasoning-format deepseek    # what llama.cpp accepts
要看第二行的 deepseek。这个参数负责区分思考过程和最终回答;作者表示,即便更新得多的 llama.cpp 也不接受 deepthink,但没有给出具体版本号。
第二个坑是子 Agent 的并行只发生在调用层。
作者让主 Agent 查询铪、铼和锝的发现年份间隔。三次测试里,它都同时创建了三个子 Agent,工具调用格式也都符合代码要求。但他们的平台部署后默认只允许一个请求执行,三个任务只能排队,整轮耗时 72.0 秒。把限制改成两个请求后,两次运行分别耗时 50 秒和 56 秒。
自建服务需要同时检查 llama.cpp 的 -np 槽位数和前置代理限制。模型一次发出多个任务,不代表底层真的同时处理。
第三个坑更容易被接口封装藏住:推理 token 也算进 max_tokens。
作者的一道普通问题在 max_tokens 为 4,096 时,返回了整整 4,096 tokens 的 Thinking Process:,没有最终答案。另一个只需两句话的定义问题,花了 1,905 tokens 推理,耗时 14.4 秒。
他们的非流式接口还有独立问题:一旦设置 content,就会丢掉 reasoning 字段。示例因此将预算设为 16,384,并对 Agent 循环使用流式输出。
这里不能只照抄更大的预算。前端和 Node 调用端还要区分「仍在推理」「正在调用工具」与「已经完成」,否则用户看到的可能只是一个长时间转圈的聊天框。
自检能提高难题成绩,简单查询未必划算
Verification Mode 会要求模型在回答前检查自己的工作。模型团队报告,在包含全部 1,266 道题的 BrowseComp 测试中,成绩从 72.5% 提升到 82.9%。这些题侧重难以检索的网络事实,部署文章的作者没有复现该基准。
他们只测了容易、可由 Wikipedia 支撑的问题,答案没有变化,工作量却接近翻倍。
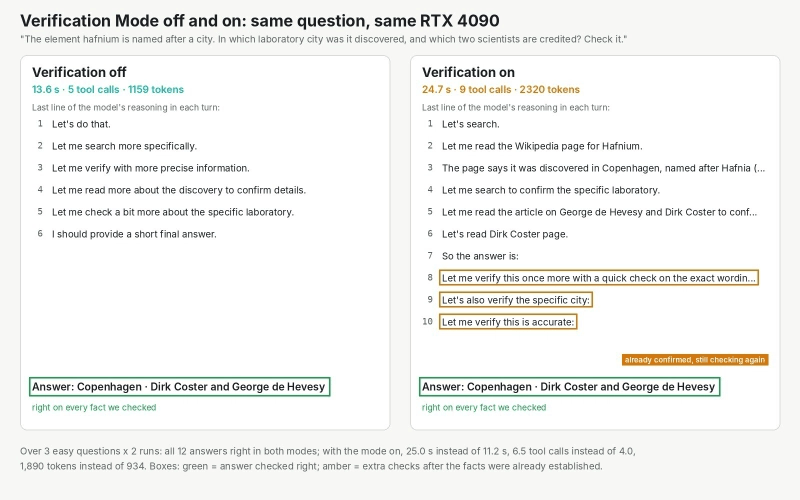
图中,关闭自检耗时 13.6 秒、调用工具 5 次、消耗 1,159 tokens;开启后变成 24.7 秒、9 次、2,320 tokens。不过运行也有波动,第二组铪问题中,开启自检反而少调用了一次工具。
开关位于聊天模板中,也就是把消息转换为模型输入提示词的那层脚本。直接调用 llama-server 时,文档中的 chat_template_kwargs={"verification": true} 可以生效,前提是 system 消息非空。
作者的平台接口尚不透传这些 kwargs,所以示例把模板中的触发行追加到 system prompt,并核对两种方式生成的提示词一致。这里还有大小写差异:模板使用小写 protocol,项目页面却用了大写开头。原文没有列出完整触发行,不能据此自行拼装。
我的判断
作者最有价值的发现,是把模型行为和服务行为分开检查。错误启动参数、单请求队列、响应字段丢失,都不是模型能力不足,却会直接破坏使用体验。
但这仍是一组部署经验,无法证明 Sage-A1.5 已经具备稳定的规模化研究质量。测试只有少量简单题、单张卡,而且每次只运行一个主 Agent;三个子 Agent 格式正确,也不足以覆盖长任务中的检索失误、交接遗漏和错误传播。
自检同样需要按题型判断。模型团队的 BrowseComp 成绩与作者的简单查询实验,衡量的是不同难度的任务。原文没有提供与其他模型、其他 Agent 框架或普通检索流程的对照数据,不能据此认定这套方案更优。
能拿来做什么
- 自建 llama.cpp 服务时,先核对
--reasoning-format deepseek、-np和代理并发限制,再用包含子 Agent 的任务检查是否真的并行。 - 给 Node 调用端设置 token 预算时,把推理消耗一起算进去,并检查预算耗尽后是否拿到了最终答案。
- 在前端接入流式输出,为推理、工具执行和最终回答提供明确状态,并按研究任务的耗时设计等待体验。
- 用同一批问题分别开启和关闭 Verification Mode,记录总耗时、工具调用次数、completion tokens 和正确性,再决定哪些任务值得开启。