用每小时探针检查文档 API 数据残留
pagenull 每小时向生产 API 提交带唯一标记的文档,再扫描日志、临时文件、容器和数据库,发现残留即判定失败并公开结果。文章还介绍通过只读文件系统等措施限制 Chromium 落盘的设计。
AI 深度解读
PDF API 承诺不保留文件,开发者该怎么验证?pagenull 的做法是:每小时向生产 API 发送带随机标记的文档,再扫描日志、临时文件、容器文件和数据库,公开检查结果。
这套方案值得看的地方,不只是定时扫描。作者把只读容器、日志字段限制、部署前测试和签名回执串了起来,同时承认:这些证据能提高承诺的可信度,却不能从外部彻底证明服务商没有留存数据。
文件没进数据库,也可能留在日志里
pagenull 是一个 HTML to PDF API。用户提交的发票、合同、工资单,除了可能进入数据库或存储桶,还可能落在几个容易被忽略的位置。
Headless Chromium 会产生浏览器配置、磁盘缓存和临时文件,渲染过的页面可能进入其中。开发者调试时写一句 console.log(req.body),或者让异常处理器打印失败请求,文档内容就可能在日志聚合系统里待上 30 天。Chromium 崩溃时生成的内存转储,也可能包含页面数据。
还有产品功能带来的留存:曾经增加的「保存 PDF 24 小时」、调试保留开关,以及替客户上传文件时留下的中间副本。
作者没有把这些归咎于恶意。它们往往来自默认行为和临时需求。
不保留文档,需要同时约束浏览器、日志、文件系统和产品接口。
先限制写入路径,再检查有没有遗漏
作者强调,真正保护数据的是运行架构,后面的检查只是验证它有没有按预期工作。
渲染容器使用只读文件系统。Chromium 唯一可写的目录是 /tmp,通过内存文件系统 tmpfs 提供,渲染器重启后消失。每次渲染创建独立的隐身浏览器上下文,PDF 完成后立即关闭,同时禁用崩溃报告器。
这里有个区别:关闭浏览器上下文负责隔离请求,tmpfs 负责避免临时内容写入持久磁盘;原文没有说关闭上下文就会立刻清空整个 /tmp。
日志则采用字段白名单,只接受 key id、时间、endpoint、status、size、duration,以及供支持人员定位问题的 render id,其他字段直接丢弃。相比提醒大家别打印正文,这种接口限制更容易持续执行。
产品层面也不提供留存选项:没有文件链接、请求正文日志或调试保留参数。需要上传 PDF 时,deliverTo 将文件发送到客户自己的存储,并拒绝私有地址和云元数据地址,避免被用于访问内部网络。原文没有展开地址校验的实现细节。
渲染器部署在欧盟,具体是芬兰 Helsinki 的 Hetzner。部署地域是数据处理边界的信息,但不能单独证明没有留存。
每小时检查和部署前测试,各自能抓住什么
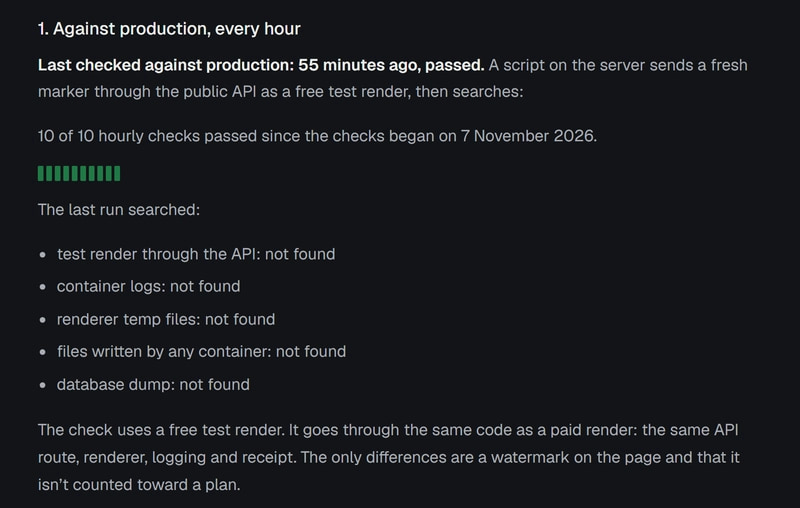
生产检查每小时运行一次:生成全新的随机标记,放进 HTML,通过公开 API 发起免费测试渲染,然后搜索测试渲染的响应和记录、容器日志、渲染器临时文件、所有容器写入的文件,以及数据库完整导出,最后在 /proof 发布结果。
测试渲染与付费渲染走相同的 API 路由、渲染器、日志和回执流程。区别只有页面水印,以及不计入套餐额度。
随机标记让不同存储位置有了统一的搜索目标。只看新增文件会漏掉日志,只看日志又可能漏掉数据库字段。不过,原文将响应也列为检查对象,却没有交代如何区分正常返回内容与异常留存,这部分仍需看实现。
部署前还有三类测试:
no-retention.test.ts通过真实 API 代码渲染带标记的文档,扫描数据库完整导出、每条日志和全部 console 输出,并在渲染期间发生文件写入时失败。no-trace-on-disk.test.ts使用真实 Chromium,在浏览器运行时及关闭后,搜索它创建的配置、缓存和临时文件。no-write-paths.test.ts扫描自有源码,检查是否存在短白名单以外的磁盘写入、绕过指定 logger 的日志,以及重新引入输出存储的选项或数据表。
前两类验证当前行为,第三类防止后续需求把留存能力加回来。例如「保留失败渲染方便排查」看起来合理,却会改变整个承诺。
每次渲染还返回 pagenull-receipt header。它使用 Ed25519 对 render id、PDF 的 SHA-256、时间、地域、renderer build 和 stored: false 签名。其中 build 是渲染器代码、依赖版本及 Chromium 版本共同形成的哈希。
公钥位于 /.well-known/pagenull-keys.json,用户可以在 /verify 或通过简短的 Node.js 脚本验证。原文没有提供脚本代码。发票银行账号即使只改了两个数字,文件哈希也会不匹配。
签名能验证回执与文件是否对应,不能证明文件已经被删除。
我的判断
我认同这套方案把隐私承诺变成可持续检查的工程约束。相较于只写隐私政策,字段白名单、只读渲染器和源码检查都有明确的执行位置;相较于只跑测试,每小时检查生产环境又补上了一层运行证据。
但作者没有提供对照实验、长期检查统计或独立审计结果,因此不能据此认定它优于所有同类服务。扫描随机标记也有检测边界:原文没有说明如何发现经过编码、压缩或其他转换后保存的内容。没搜到原始字符串,不能直接推导为没有任何副本。
时间边界同样存在。一次小时检查无法覆盖之后的代码变更;测试只反映运行时对应的提交,不能阻止运营方部署另一份代码;回执中的 stored: false 仍然是服务方签署的声明。
作者对此没有回避。他们将架构限制、只读渲染器、公开测试、生产检查和数据处理协议放在一起支撑承诺。这个思路成立,但「难以偷偷违背」与「无法违背」之间仍有距离。
能拿来做什么
- 如果你的 Node 服务处理 HTML、发票或合同,可以先盘点请求正文经过的日志、异常处理器、浏览器缓存和临时目录,尤其检查失败路径有没有额外保存内容。
- 为敏感接口设计只接受固定元数据的 logger,并在测试中扫描数据库和 console 输出,比单靠代码审查提醒更容易形成长期约束。
- 做浏览器渲染服务时,可以参考独立上下文、只读文件系统与 tmpfs 的组合,同时分别确认请求结束和进程重启时,临时数据如何清理。
- 评估第三方 PDF API 时,可以查看生产检查、测试源码和回执验证方式。pagenull 的
/proof还提供示例电子发票及验证报告,Playground 无需账号即可获取 PDF 和回执,免费额度为每月前 100 份 PDF;这些入口方便检查承诺,但仍需结合业务要求判断。