CI 故障该交给重试机制还是 AI 修码
文章按故障类型区分基础设施自愈与 AI 代码修复的职责:运行器处理机器、网络、磁盘、内存及工具版本问题,代码缺陷交给修码 Agent。错误分派可能让 Agent 修改正常代码,或让自动重试掩盖真实缺陷。
AI 深度解读
CI 变红之后,该让 Runner 重跑,还是让 AI 改代码?作者的答案是:先判断失败归谁管。环境问题交给基础设施层,仓库缺陷交给开发者或编程 Agent;分错了,前者可能诱导 AI 乱改代码,后者可能被重试掩盖。
这套思路值得借鉴,但原文没有提供流水线实测。它更像一份故障分流方案:讲清责任边界,再用一个公开故障目录说明分类方式。对正在给 CI 接入 AI 修复的团队,最有用的是接入前该补上的判断环节。
先问该改环境,还是该改仓库
作者把 CI 修复分成两层。
Runner 层负责代码运行所依赖的环境,包括机器、访问依赖仓库的网络、磁盘、内存上限,以及镜像中的工具版本。如果代码原本应该通过,只是环境出了问题,合理处理就是修复环境,再运行同一份代码。
Agent 层负责仓库中的改动,比如错误断言、类型错误、缺失的数据库迁移,以及与代码不匹配的配置。遇到这些问题,必须修改仓库。原样再跑一次,并没有消除失败原因。
分流的依据是故障需要改变什么,而不是哪个工具更聪明。
模型能读懂磁盘已满的日志,也不代表它能给 Runner 增加磁盘。反过来,Runner 可以重新执行任务,却无法纠正一个错误断言。
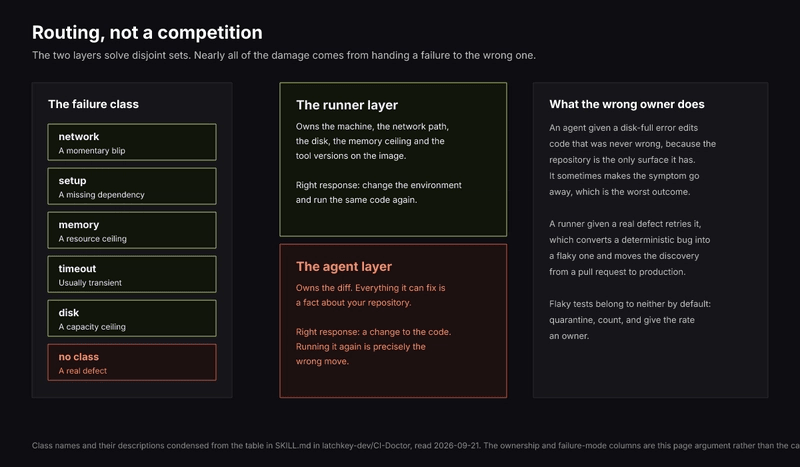
作者引用开源 CI Doctor 的分类目录。按原文描述,其中有分类标记的环境故障分为五类:network、setup、memory、timeout 和 disk;没有分类标记的条目则被视为真实缺陷。
这里要区分两件事:目录提供了分类,作者进一步提出了每类应该由谁处理。后者是文章的主张,并不是目录本身验证过的结果。
4,555 条故障签名,不能当成你的失败概率
作者在 2026-09-21 统计了 latchkey-dev/CI-Doctor 的 references/index.tsv,共得到 4,555 条记录。其中,760 条带有分类,3,795 条没有分类。
按这份目录,大约六分之一的故障签名属于环境问题,六分之五属于缺陷。但「故障签名」是不同错误模式的目录条目,不是某段时间里实际发生的故障次数。
同一个依赖仓库网络故障,可以在一个月里反复触发;某个代码缺陷,也可能只出现一次就被修复。因此,即使环境问题的种类较少,它在团队日志里的出现次数仍可能很多。不能据此推断:自家 CI 的失败也只有六分之一来自环境。
原文后面还使用了「六比一」描述未分类与已分类条目的比例,这与具体计数并不一致。3,795 对 760 接近五比一;约六分之一说的是环境类占全部条目的比例。实际引用时,应保留计数和统计口径。
这份数据能说明分类值得做,却不能证明做完之后能节省多少时间。作者明确承认,文章没有运行实验支撑,也没有给出任何具体产品的修复成功率。
自动重试和 AI 改码,各有一种危险的成功
对 Runner 来说,危险在于把「跑绿了」当成「修好了」。
作者反对对所有失败任务统一重试,也反对用 continue-on-error 把真实失败绕过去。如果代码存在缺陷,重试不会修正缺陷,却可能让问题延后暴露。作者担心,团队最终会把应当在 pull request 中处理的问题,留到后续分支甚至生产环境。
这里需要补一个边界:严格确定性的缺陷通常会持续失败,重试不会凭空让它变绿。真正容易被掩盖的,是受执行顺序、时序或状态影响的缺陷,以及被忽略掉的失败。原文的警告有道理,但表述不能理解成任何重试都会把确定性错误变成偶发错误。
对 Agent 来说,危险则是提交了一个看起来合理、方向却错了的修改。
作者举了内存不足的例子:Agent 看到退出码 137,找到当时运行的测试,然后修改测试。这样的修改偶尔会让任务通过,却可能只是削弱测试,掩盖了真实的内存上限问题。这是作者用于说明风险的场景,不是有成功率统计的实验。
作者建议把失败类别随日志一起交给 Agent,让它知道问题可能属于 memory 或 network,减少盲目改码。不过,类别标签只能提供约束,不能保证模型一定停手。
还有一种情况,两条路径都不该直接接:偶发失败的测试,也就是 flaky test。
原文举例,一个测试每运行 30 次失败 1 次。它不能直接归因于环境;只给 Agent 一次失败日志,也不足以支持可靠修复。作者建议先隔离、统计失败率,并明确负责人。是否允许重试可以讨论,但必须成为有记录的决定,而不是默认动作。
我的判断
我认同作者把「分类」放在「修复」前面。对接入 AI 的团队,这比先挑选模型更基础:输入里如果混着网络抖动、磁盘不足和代码缺陷,Agent 就要同时猜原因、猜责任,再生成修改,出错空间自然更大。
但这套两层模型是责任划分的起点,还不是可以照搬的自动判定规则。
例如 memory 和 timeout 都可能有多种原因。构建进程超过 Runner 的内存上限,可能需要调整资源,也可能是代码或构建配置导致内存异常增长。超时同样可能来自网络,也可能来自程序挂起。错误类别提示了排查方向,不一定直接决定最终责任人。
退出码 137 也不能单独证明内存不足。它能提示进程被强制终止,具体原因还需要结合日志和运行环境判断。把某个退出码直接映射成允许自动重试的类别,仍然可能误判。
相比人工看到红灯就重跑,分类后再处理有助于留下原因和记录;相比把所有日志都塞给 Agent,它也能减少无关输入。不过,作者没有提供这几种方案的对照数据,效率收益仍是经验判断。
更稳妥的落地方式,是让分类可以被核查,也允许暂时无法分类。
目录中的「未分类」有其特定含义,自家流水线里的「分类器没认出来」却不一定就是代码缺陷。这两者不能直接画等号。
能拿来做什么
- 给前端或 Node 项目的失败报告补上最小诊断信息:失败步骤、退出码、关键错误片段,以及当前判断的类别。按作者建议,优先提供失败步骤的日志,避免直接把整条流水线日志交给 Agent。
- 把依赖安装时的网络异常,与类型检查、测试断言等失败分开处理。只有确认环境阻碍了原本应当通过的代码,才进入环境修复和重试路径。
- 对反复偶发失败的测试记录失败次数、运行次数和负责人。允许重试时也保留失败记录,让最终通过状态不会抹掉不稳定性。
- 每月统计各处理路径承接了多少失败。如果环境路径持续增长,就继续按网络、工具安装、内存、超时和磁盘拆查原因,避免把自动重试次数增加当成系统变健康的证据。