美团开放万亿级 Agent 模型权重
美团发布 LongCat-2.5 权重,这款面向 Agent 的模型拥有 1.6 万亿参数,完全使用国产硬件训练。据报道,其 Terminal Bench 得分为 88.4,示例部署使用 194 颗华为昇腾芯片。
AI 深度解读
美团开放了 LongCat-2.5 的模型权重:总参数 1.6 万亿,面向能自主完成多步任务的 AI Agent,尤其是编程。原文最醒目的信息是,它完全使用国产硬件训练,部分编程评测接近 Claude Opus 5。
但「接近」需要拆开看:命令行任务、真实仓库修复和更难的长程任务,成绩并不一致。对开发者更有用的,是它如何训练 Agent、怎样接入现有工具,以及为什么开放权重仍然离个人部署很远。
1.6 万亿参数,能给编程 Agent 带来什么
LongCat-2.5 在正式亮相一周后开放权重,采用混合专家架构(MoE)。它把能力分散在多个专家子网络中,每处理一个 token,只调用其中一部分:总参数 1.6 万亿,每个 token 约激活 480 亿参数。
激活参数少,能减少计算量,但不代表整个模型只需要存下这部分参数。
通过 API,它支持最高 100 万 token 上下文、最长 12.8 万 token 输出,接收文本、图片和视频,输出文本,并允许开关推理。对于需要反复读文件、执行命令、检查结果的 Agent,这提供了容纳更多任务材料的空间。但窗口容量不能直接证明它能可靠地利用全部内容。
相比 LongCat-2.0,新模型增加了图像理解。原文强调,它借鉴 LongCat-Next,把图片按原生分辨率拆成离散 token,与文本一起处理,目标是改善视觉编程、设计和 3D 任务。
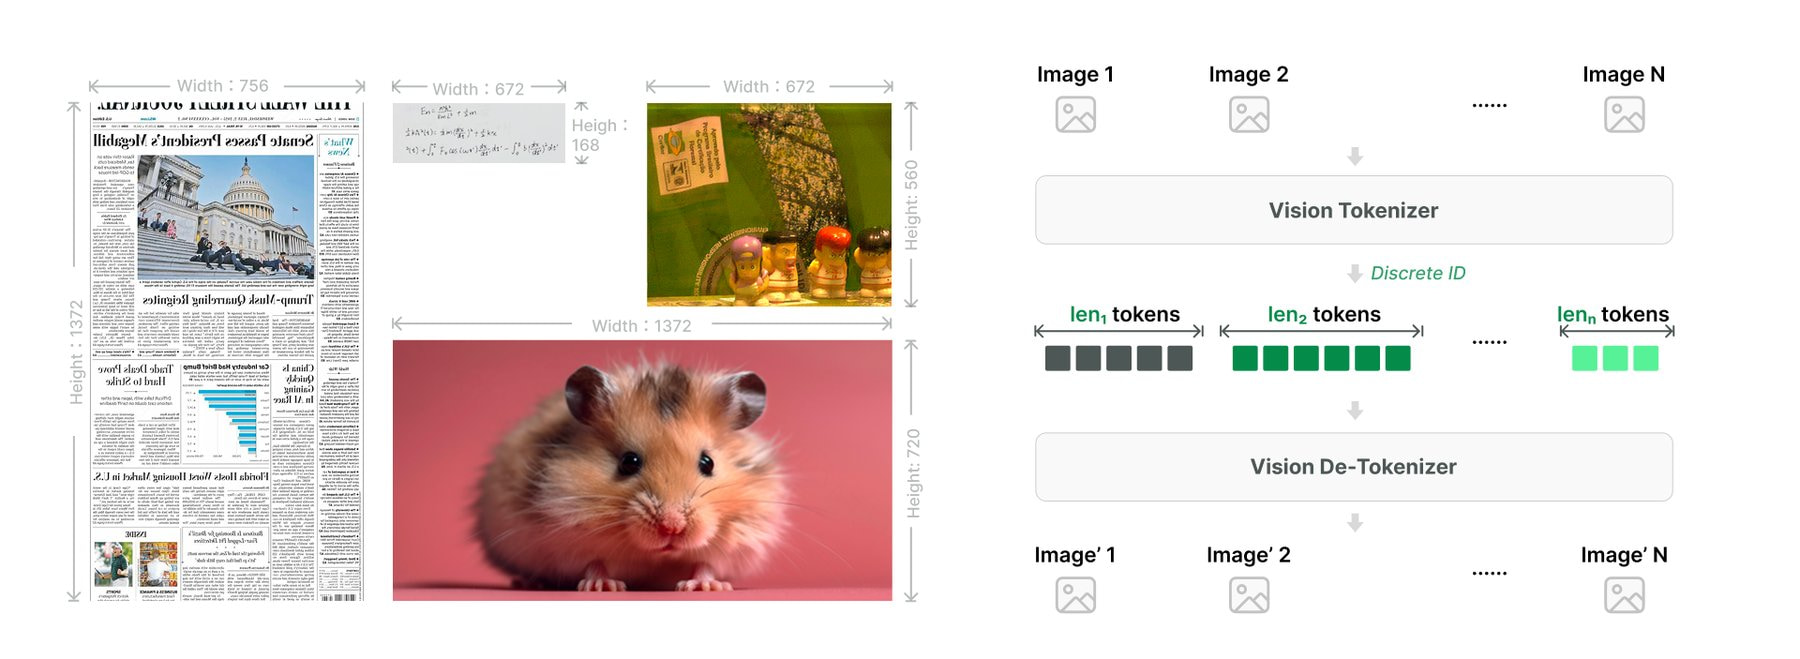
前端读者可以把它理解为:模型试图把截图中的视觉信息和代码指令放进同一套处理流程。不过,原文没有给出截图还原页面的具体案例,也没有单独验证这种图像处理方式带来了多少提升。
训练 Agent,为什么要先堵住取巧的路
模型会写代码,与它能独立完成软件任务,是两回事。
美团的强化学习任务来自真实 GitHub 仓库的 pull request,也包括重建的 Agent 失败案例。训练环境禁止联网,移除 Git 历史和缓存文件,再通过测试与语言模型裁判检查结果,识别取巧行为。
这些限制解决的是奖励可信度:如果模型能直接找到现成补丁,或者从历史记录里翻出答案,任务通过也未必说明它学会了修复问题。
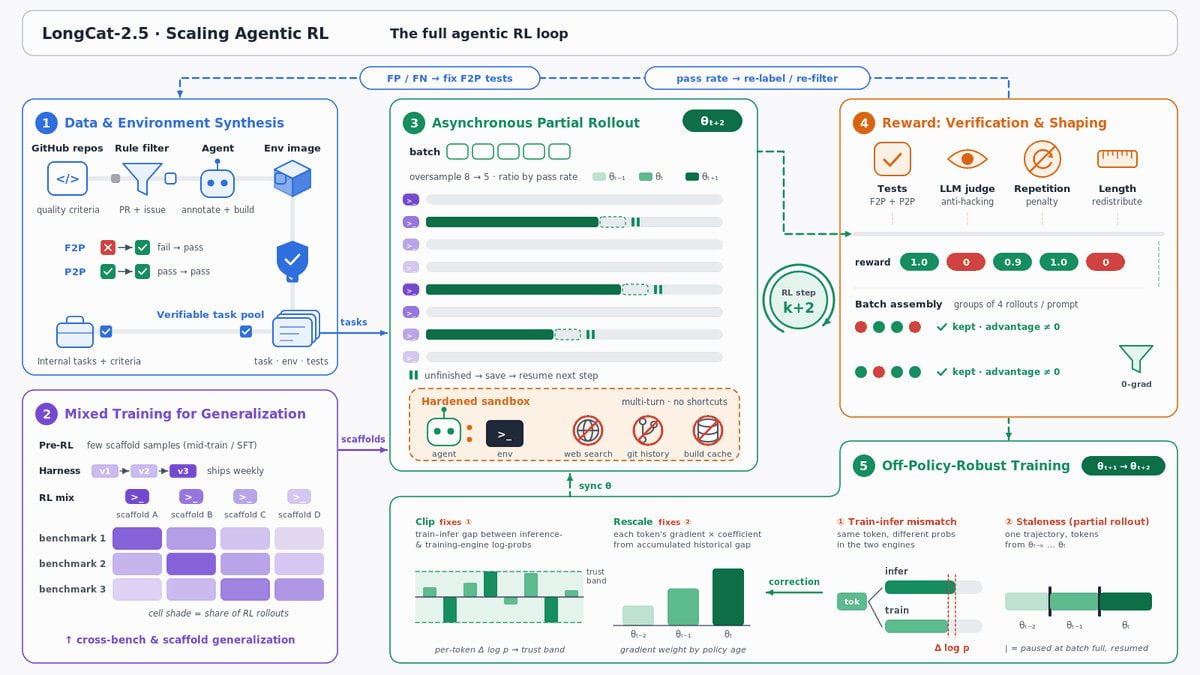
团队还把多个专用教师模型在 Agent、推理和对话方面的能力蒸馏到 LongCat-2.5 中,即让一个模型学习多个专门模型的表现。
这套训练设计有道理,但原文没有提供消融实验,无法判断成绩提升分别有多少来自任务构造、环境限制或蒸馏。不能把其中某一个环节单独认定为成功原因。
跑分接近 Opus 5,部署却要看另一组数字
美团公布的评测,呈现的是能力分布,而不是统一领先:
| 评测 | LongCat-2.5 | 原文给出的对照 |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | Claude Opus 5:89.1;GPT-5.6 Sol:88.8;Deepseek-V4.1-Flash:90.6 |
| DeepSWE | 64.6 | Deepseek-V4.1-Flash:74.2;GPT-5.6 Sol:72.7 |
| Terminal Bench v4.0 | 38.5 | GPT-5.6 Sol:37.3;Claude Opus 5:53.9 |
| BrowseComp | 91.9 | 表内最高,但使用美团自己的测试环境 |
DeepSWE 衡量真实代码仓库的缺陷修复能力。LongCat-2.5 从前代的 9.7 提升到 64.6,进步很大,但在表内仍只超过 Claude Opus 4.8。到了更难的 Terminal Bench v4.0,它与 Opus 5 的差距也明显扩大。
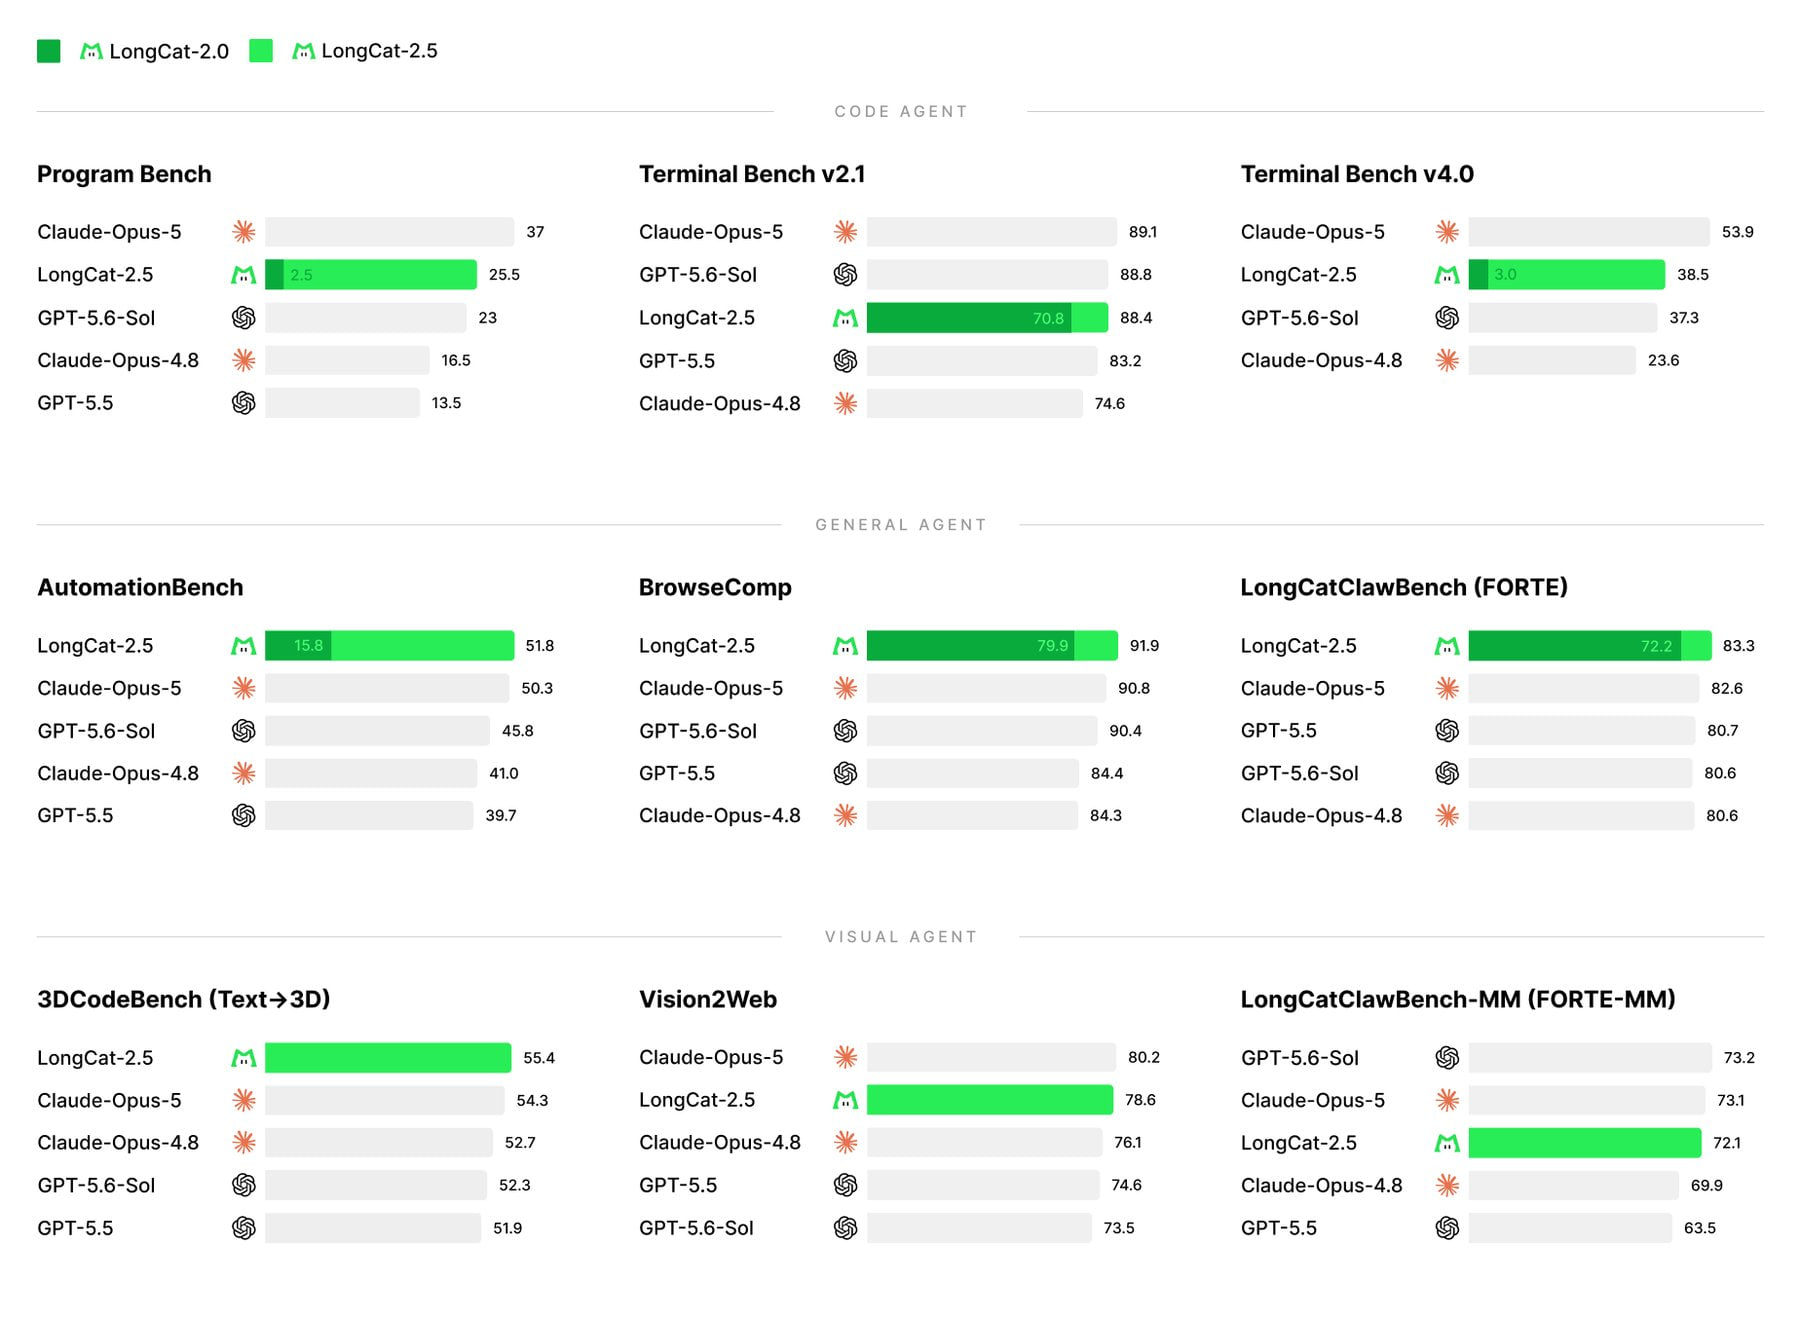
这份表没有纳入更新的 Claude Opus 5.5 和 GPT-6.1 Sol。因此,更准确的说法是「部分评测接近表中较早一批模型」,不能据此认定它已经追平最新水平。
部署成本同样不能只看参数激活量。美团将专家权重和激活值量化到 4-bit,利用国产芯片原生支持的低精度计算。其压力测试显示,相比 8-bit 版本,提示处理吞吐提升 43.3%,响应生成吞吐提升 42.77%;美团称准确率与未压缩模型相当。
量化版本放在独立仓库。自托管指南给出的示例需要 194 颗 Huawei Atlas A2 系列 Ascend 加速器:2 颗处理图像,64 颗处理输入,128 颗生成响应,没有提供 Nvidia GPU 部署指导。
权重采用 MIT 许可证,允许商用、修改和再分发。API 兼容 OpenAI 与 Anthropic 格式,可接入 Claude Code、Codex 和 Hermes。发布时的限时促销价约为每百万输入 token 0.27 欧元、每百万输出 token 1.07 欧元,不能当作长期价格承诺。
我的判断
我更看重它把国产硬件、低精度推理和 Agent 训练串起来的工程路径。原文还提到,前代 LongCat-2.0 在 6 月下旬使用超过 5 万颗国产 AI 芯片训练。这说明相关工作有持续投入,但没有训练成本、周期和能耗对照,无法判断整体经济性。
「完全使用国产硬件训练」与「在所有编程任务上达到领先水平」,是两个需要分别验证的结论。
跑分来自美团自己的评估,BrowseComp 又使用自建环境;原文没有提供独立复测。这里有厂商报告的实测数字,也有对这些数字的解释,证据强度需要分清。
与现有闭源 API 相比,它提供了 MIT 权重和自托管可能性;但对普通前端或全栈团队,194 颗加速器的示例很难成为日常选项。更现实的入口是兼容 API,再用自己的仓库任务验证效果。接口格式兼容,也不等于工具调用和长程执行表现完全一致。
能拿来做什么
- 已经使用 Claude Code、Codex 或 Hermes 的团队,可以尝试接入其兼容 API,用同一批仓库修复任务比较完成率、耗时和费用,尤其关注多轮修改之后能否通过现有测试。
- 维护内部 Agent 评测时,可以借鉴它清除 Git 历史和缓存的做法,为每个任务准备干净环境,避免把找到现成答案误判成修复能力。
- 对截图驱动的前端开发,可以拿已有页面截图和明确验收条件试跑,分别检查布局、交互与代码可维护性,验证图像理解是否真正帮助交付。
- 有国产算力和自托管需求的团队,可以优先评估独立的 4-bit 版本,并把硬件容量、部署复杂度和实际吞吐一起核算,再决定是否替换现有服务。