用微虚拟机隔离集群中的编码智能体
作者将 Claude Code 部署在 k3s 集群中,以 Kata 微虚拟机隔离各智能体,执行修复缺陷、更新依赖和部署排障等任务。方案围绕代码仓库、集群 API 与调试工具的访问需求,强调最小权限和多层防护。
AI 深度解读
把 Claude Code 放进 Kubernetes,让它修 Bug、更新依赖、排查部署问题,难点在于给它多少权限:权限少了干不了活,权限多了又可能改坏集群、泄露代码。作者给出的方案是,把执行环境、集群访问、代码合并和网络出口分别设限,再用人工审核兜住部署入口。
这套方案值得参考,但原文中的安全结论、性能数字和操作命令,证据强弱并不相同。读它最有用的方式,是提取权限边界的设计,同时分清哪些部署经验还不足以成为保证。
能自主排障,为什么不能直接改集群
作者在 k3s 集群里运行 Claude Code,每个 Agent 被放进一个 Kata Containers microVM。它可以读仓库、查看集群状态、使用调试工具,再通过 Git Pull Request 提交修改。
这里实际分开了两种能力:获取诊断信息,以及改变线上状态。
Kubernetes 一侧,作者用 RBAC,也就是基于角色的访问控制,把 ClusterRole 的操作限制为 get、list、watch。Agent 可以观察资源,但不能通过这些权限删除 Pod、修改 Deployment。通过 kubectl create token 生成的访问令牌被设为 24 小时过期,用来缩短凭据泄露后的暴露窗口。
原文第一段权限示例如下,它想表达的是允许读取 pods、nodes 和 configmaps:
apiVersion: rbac.authorization.k8s.io/v1kind: ClusterRolemetadata: name: ai-agent-read-onlyrules:- apiGroups: [""] resources: ["pods", "nodes", "configmaps"] verbs: ["get", "list", "watch"]
要注意 verbs 中的三个只读操作;同时,这段原文代码已经丢失换行,不能直接作为 YAML 使用。后一个示例增加了 services、apps 组下的 deployments,以及 rbac.authorization.k8s.io 组下的 roles、rolebindings。正文还提到 webhooks,但没有给出对应配置。
只读权限限制的是修改能力,并不自动限制敏感信息的读取。
例如,ConfigMap 可能包含内部地址和业务配置;Pod 配置也可能暴露环境信息。因此不能只检查动词,还要检查资源种类和授权范围。原文没有完整交代命名空间、RoleBinding 或 ClusterRoleBinding 的绑定方式,不能据此认定它已经实现了最小权限。
从 Agent 写代码到生产发布,谁负责拦住错误
作者设计的发布路径是:Agent 创建 PR,人工审核并合入受保护的 main,Argo CD 再从 main 同步到集群。
这条链路的价值,是让 Agent 能完成代码工作,同时把生产变更留在已有审核流程里。Git token 可以允许推送功能分支、创建 PR,但不能绕过主分支保护。原文前面写「禁止直接推送分支」,后面又允许功能分支推送,表述并不一致;实际配置必须区分功能分支与受保护分支。
这里还要纠正一个责任归属。原文多次把「合并前人工批准」写成 Argo CD 的能力,但 Git 分支保护、PR 审核与 Argo CD 部署同步属于不同环节。Argo CD 只跟踪 main,不能单独证明 Agent 没有合并权限。
作者声称,他们审核了超过 200 个 Agent PR,其中 15% 因发现缺陷被拒绝。这至少说明,审核环节确实拦下过问题。但原文没有列出缺陷类型、严重程度,也没有比较人工修改或其他 Agent 工作流,不能据此推导整体代码质量。
对程序员而言,这比「让 Agent 自动部署」更容易落地。前端或 Node 项目的修复、依赖升级可以先走 PR;涉及线上资源的变化,则通过受审查的仓库配置进入部署流程。代价是审核仍然需要时间,PR 数量增加后,审核能力可能成为新的瓶颈。
隔离、出口和停机机制分别解决什么
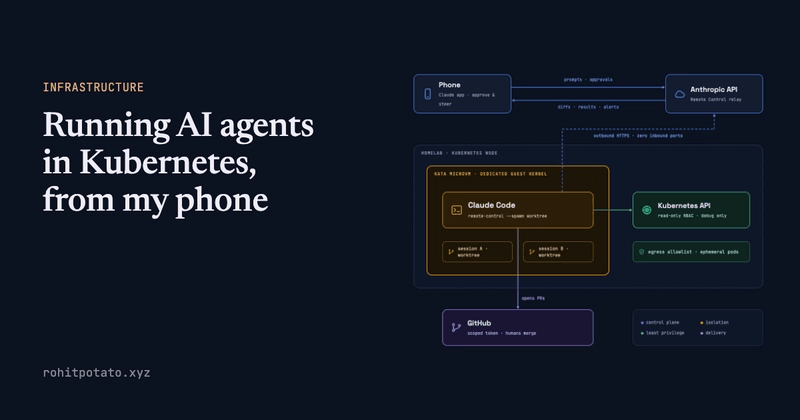
Kata Containers 给 Agent 配置独立的 guest kernel,减少普通容器共享宿主内核带来的风险。原文提到 QEMU、Firecracker 等虚拟化组件,强调攻击者需要突破额外边界才能影响宿主。
这个方向成立,但「攻陷 Agent 后绝不影响宿主和其他节点」说得太满。microVM 不能消除共享存储、网络和凭据带来的跨边界风险。原文还引用 CVE-2021-28485 说明虚拟化组件存在漏洞,却没有提供漏洞细节、受影响版本及其与实际部署的关系,不能直接当作这套环境的逃逸证据。
网络方面,Agent 主动通过 HTTPS 连接 Claude Code 的 Remote Control,不需要开放入站 SSH 或 VPN。与此同时,出口默认拒绝,只放行 Git 仓库、Remote Control API 等必要目的地,由 Calico 或 Cilium 等组件执行策略。
这两个措施解决的问题不同:主动向外连接减少远程入口,出口白名单限制数据能发往哪里。即使只允许 HTTPS,获准访问的服务仍可能成为数据外传通道,所以不能把「只出不进」理解为没有泄露风险。
作者还提出用 Cilium 的 FQDN 策略按域名管理出口。不过,原文把域名策略、DNS 查询拦截和应用层过滤混在了一起,没有给出配置,无法判断它具体覆盖哪些流量。
最后是运行与应急:Agent 使用临时 Pod,状态保存在 PersistentVolumeClaims(PVCs)和 Git 中;监控关注 API 访问、网络活动、CPU 和内存异常,发现问题后告警、停止 Pod、收紧网络并处理凭据。
这里有两处不能照抄。PVC 会保留状态,也可能保留恶意文件,临时 Pod 不等于清除了持久化风险。原文给出的 kubectl delete token 也不能作为通用的令牌撤销命令直接使用,TokenRequest 签发的令牌并不是这样删除的独立资源。应急流程需要先明确令牌类型及有效的失效机制。
我的判断
最值得借鉴的是把执行、读取、提交和发布拆成不同权限边界。
它让某一层出错时,其他层仍有机会限制后果。相比给 Agent 一个高权限 kubeconfig,再要求它「谨慎操作」,这种设计更容易检查,也更容易追责。
但原文的实测部分只能按作者自述看待:环境是被称为「生产级」的 homelab,连续运行六个月,完成超过 1,000 个编码任务且没有安全事件;六个月审计日志没有受限资源写入尝试,三个月没有白名单外的成功出站连接;作者还称渗透测试未获得宿主内核访问权限。
这些数字有参考价值,却缺少测试方法、攻击覆盖范围和日志细节。「没有写入尝试」也不能验证写入一定被拦截。原文没有给出对照数据,不能替它背书为已经证明安全。
性能数字同样如此。Kata 初始化约 200ms、gVisor 约 50ms,以及后续实验可能降低 30% 延迟,都没有硬件、版本和测量口径。原文还在「每任务延迟」与「VM 初始化延迟」之间切换表述。gVisor 是值得比较的替代方案,但不能据这些数字直接认定它在你的任务中更快,或把两者的安全性排成固定等级。
作者建议每季度审计 RBAC 和网络策略,并提到配合 SELinux 做内核加固,这些可以作为维护方向。原文结尾停在未完成的「Mitigation: Integra」,后续缓解措施没有写完,也没有完整部署清单,因此它更适合当架构检查表,距离可直接复用的实施手册还有差距。
能拿来做什么
- 给负责前端或 Node 仓库的 Agent 设置独立 Git 身份,允许功能分支提交和创建 PR,再实际验证它无法绕过
main的审核与保护规则。 - 做集群排障时,先列出 Agent 必须读取的资源和范围,再配置
get、list、watch;用允许和拒绝两类操作验证权限,不要只看配置名称是否叫「只读」。 - 接入 Remote Control 前,把仓库、模型服务和必要调试服务整理成出口清单,再验证默认拒绝策略是否真正生效,同时检查获准目的地能接收哪些数据。
- 为长期运行的 Agent 演练一次完整停机:终止执行、切断网络、确认凭据失效,并检查 PVC 中保留的文件。隔离方案的选择则用自己的任务测量启动耗时、兼容性和维护成本。