从浮点到四位整数,量化省下什么
文章从浮点数表示讲起,介绍 FP32、BF16、TF32 和 INT4 等精度格式及其内存代价。它以模型权重容量为切入点,讨论压缩权重与激活时的资源收益和质量退化风险。
AI 深度解读
270 亿参数的模型,光 FP32 权重就要约 108 GB,单张 80 GB 的 H100 装不下。换成 4-bit,理论权重体积降到 13.5 GB。量化要解决的,就是如何省下这些显存,同时尽量保住模型能力。
原文从浮点数的位布局讲到 GPTQ、AWQ 和 QLoRA,核心判断是:低精度不一定带来明显退化,关键看如何分配有限的表示空间。但显存账面值、论文指标和实际任务质量,需要分开看。
位数之外,先分清范围、精度和计算方式
浮点数由符号位、指数位和尾数位组成。指数决定能表示多大、多小的数,尾数决定相邻数之间分得多细。在固定的位数预算里,两者需要取舍。
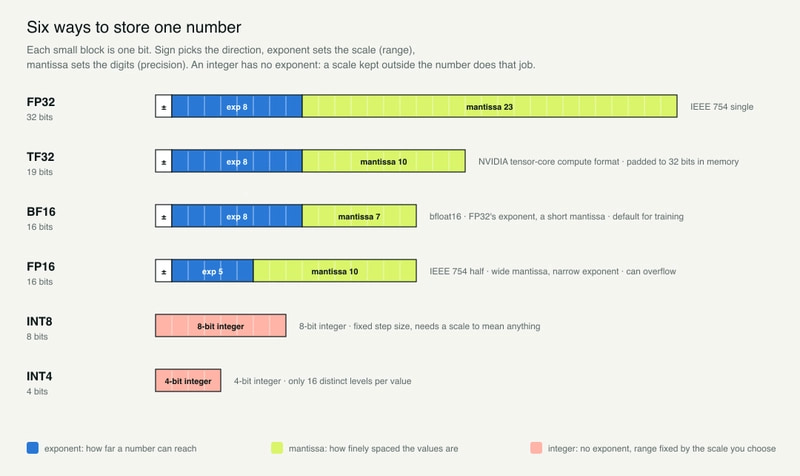
FP16 和 BF16 都占 16 bit,但用途差异就藏在这里。FP16 有 5 位指数、10 位尾数,最大有限值约为 65,504;BF16 有 8 位指数、7 位尾数,最大值约为 3.4×10^38,范围与 FP32 相近。
训练时,激活值和梯度可能跨越多个数量级。FP16 容易遇到上溢或下溢,工程上常用损失缩放(loss scaling)缓解。BF16 牺牲部分细粒度精度,换来更大的数值范围,因此更适合很多大模型训练任务。不过,原文把它写成彻底消除数值问题,语气过满;范围更宽不等于训练一定稳定。
TF32 则属于另一层问题。它是 NVIDIA 在 Ampere 架构、A100 上引入的 Tensor Core 计算模式,有效位包括 1 位符号、8 位指数、10 位尾数,但输入张量仍以 32-bit 保存。矩阵乘法内部降低输入精度,结果用 FP32 累加。
TF32 可以加速部分 FP32 计算,但不会缩小 FP32 权重的存储体积。
原文还称 PyTorch 在 Ampere 及更新 GPU 上默认启用 TF32,却没有限定版本和运算类型。不能据此认定自己的「FP32 基线」必然用了 TF32,比较结果前仍要确认实际配置。
108 GB 降到 13.5 GB,究竟省了什么
权重的基础账很好算:参数量乘以每个参数占用的字节数。按原文的 270 亿参数示例,以十进制 GB 计算:
| 权重精度 | 理论权重体积 |
|---|---|
| FP32 | 108 GB |
| BF16 / FP16 | 54 GB |
| INT8 | 27 GB |
| INT4 | 13.5 GB |
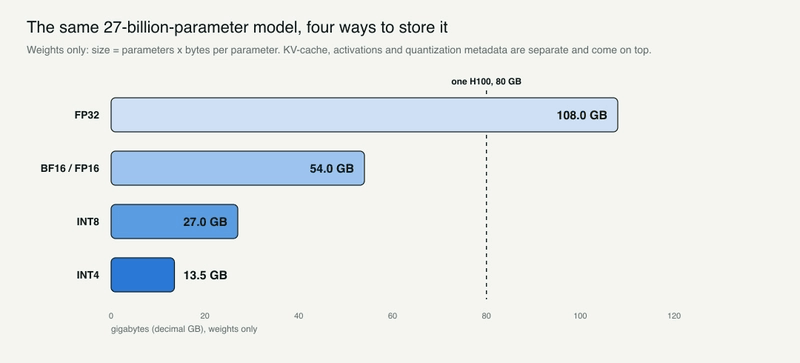
108 GB 超过单张 80 GB H100 或 A100 的容量,需要切分权重;54 GB 能装下权重,但并发和长上下文仍受剩余显存约束。13.5 GB 则让 24 GB RTX 4090 成为值得评估的部署选项。
这里不能直接跳到「整套服务只占 13.5 GB」。原文图表只计算权重,没有包括 KV-cache、激活值和工作区,也没把分组量化所需的缩放参数算进这笔简单账。QLoRA 冻结的 4-bit 基座之外,也还需要适配器训练空间。
量化具体做的是:把浮点数映射到数量有限的编码,再通过缩放因子 scale 和零点 zero-point,恢复出近似数值。INT8 的有符号范围是 −128 到 127,无符号范围是 0 到 255。对称量化常用零点为 0、范围为 [−127, 127];非对称量化保留偏移,更适合偏斜的数据分布。
原文把 ReLU 和 SiLU 输出放在同一类例子里,需要区分:ReLU 输出非负,SiLU 可以输出负值。是否采用非对称量化,要看实际分布。
4-bit 最难的地方,是少数异常值挤占了刻度
如果整块权重只共用一把刻度尺,一个特别大的值就可能拖累其余数值。
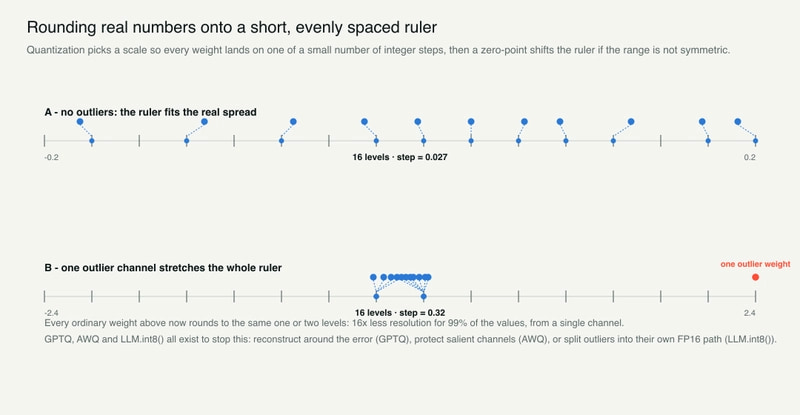
原文示意图中,异常值是普通值的 12 倍。为容纳它,量化步长也扩大 12 倍,普通权重只能挤进零附近的一两个编码,原有差异随之丢失。
作者引用 Dettmers 等人在 2022 年的研究:所研究的 Transformer 超过约 67 亿参数后,会出现幅值高出其他通道 50 到 100 倍的异常激活特征。这是特定研究中的观察,不宜当成所有架构必然遵守的分界线。
应对办法首先是缩小刻度尺的管辖范围:per-tensor 给整个张量一套参数,per-channel 给每个输出通道一套,per-group 则把一行拆成 32、64 或 128 个权重的小组。分组会增加元数据,却能减少局部异常值对其他权重的影响。
几种算法进一步采用不同策略:
- LLM.int8()(2022)把约 0.1% 的异常坐标维度留在 16-bit,其余约 99.9% 走 INT8,再合并结果。
- GPTQ(2022)逐层量化,利用二阶曲率信息,在舍入一个权重后调整剩余权重,补偿输出误差;原文列出的常见分组大小是 128。
- AWQ(2023)利用激活值识别重要通道,量化前放大重要权重,同时缩小对应输入。原文强调保护最重要的约 1% 通道,以减少低精度造成的损失。
- QLoRA 使用的 NF4(2023)采用非均匀编码,把更多表示位置放在权重密集的零附近;双重量化再将块缩放常数量化为 8-bit。
NF4 也提醒我们:4-bit 不等于均匀 INT4。两者都只有 16 种编码,但数值如何对应这些编码,可以完全不同。
我的判断
原文最有用的部分,是把存储精度、计算精度和量化算法拆开讲。看见「4-bit」标签,仍然需要追问采用什么格式、怎样分组、哪些部分保留高精度,以及运行时是否支持相应计算。
它的证据展示却不够完整。所给文本出现了「已发表基准结果」的标题,却没有具体表格、模型、分数或完整实验配置,也没有作者自己的对照实测。因此,「几乎无损」只能视为作者对既有研究的概括,不能当成任意模型和任务都成立的承诺。GPTQ「几小时完成」同样缺少硬件和模型规模条件。
相比直接舍入的 RTN,这些方法至少明确处理了误差、异常通道或权重分布,设计理由成立。但 GPTQ、AWQ 和 NF4 谁更合适,给出的材料不足以排出统一名次;NF4 的分布优势也依赖权重接近相应假设。
能装进显存,只证明部署有了起点;质量和速度仍要分别验证。
原文最后的提醒尤其适合程序员:WikiText 困惑度接近,不代表严格 JSON、多步数学推理或冷门代码语法也能保持质量。它也没有提供延迟、吞吐量对照,不能把体积缩小的倍数直接当成加速倍数。
能拿来做什么
- 评估本地代码模型时,先按参数量计算权重体积,再为 KV-cache、上下文长度和并发留空间;不要只凭「13.5 GB 小于 24 GB」就确定部署方案。
- 给前端或 Node 服务选择量化检查点时,记录具体格式、分组大小和运行时支持情况,并在目标硬件上测延迟与吞吐量。
- 为日常 AI 编程准备固定验收样例,覆盖代码能否通过语法检查、JSON 是否符合 schema,以及项目常用语法是否正确;用同一批输入比较原始版本和量化版本。
- 尝试 QLoRA 微调时,把 NF4 和双重量化当作节省基座存储的手段,单独估算其余训练开销,并用目标任务验证微调结果。