用驱动技能串起规格到交付的开发流程
文章认为,规格驱动开发的薄弱点在于人工衔接步骤,容易遗漏审查、测试和规格偏移检查。作者用驱动技能协调规格、TDD 和端到端测试等能力,通过 /ship-feature 分层推进并提交代码。
AI 深度解读
给 AI 一份规格说明,它仍可能在后续开发中漏掉审查、夹带无关修改,或者没跑测试就提交。作者认为,规格驱动开发(SDD)的薄弱处往往在步骤交接:规则写好了,却没人确保每一步都执行。
他的做法是在现有技能上加一个驱动器,用 /ship-feature 串起开发流程,在阶段之间检查指标,遇到问题就停下来处理。这个方案值得看的地方,是把「记得检查」变成了「检查通过才能继续」;但它能约束流程,不能替人判断需求是否正确。
为什么写好了规格,开发还是会跑偏
作者先列出了一条常见的手动流程:
write spec → review spec → plan tasks → implement → review code → run QA → push
这段流程解决的是从规格到提交的完整推进。要留意相邻步骤之间的箭头:原文中的 7 个步骤,每次切换都依赖人记住下一步、检查上一步,再决定是否继续。
问题就藏在这些切换里。到了第 4 次提交,可能没人重新检查代码是否偏离规格;看到 diff 感觉还行,审查也可能被跳过。作者据此提出,继续打磨规格格式,未必能解决流程中断的问题。
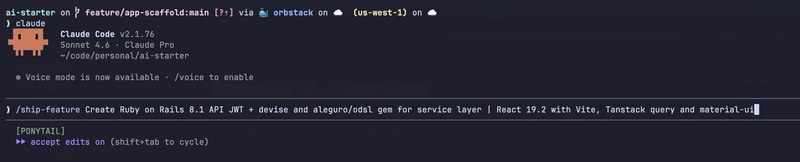
他在自己的 ai-project-boilerplate 模板上增加了 driver skill,也就是负责调度的技能。它协调 spec-driven-development、tdd-loop、e2e,各个技能仍然可以单独使用。
入口只有 /ship-feature。驱动器把功能映射到 5 层,每层形成一个独立、整洁的 commit。不过,没有后端契约或者没有 UI 的功能,会跳过对应层,并非每个小需求都必须凑齐 5 次提交。
真正起作用的是阶段之间的检查
驱动器在从 api 到 app、从 app 到 qa,以及进入 stats 前运行同一个报告命令:
scripts/metric-logger.sh report
它解决的是阶段切换前的检查。关键看报告中的 alerts 字段:出现指定告警,驱动器就停止推进,而不是只把报告留给人看。
原文重点讲了两种告警。
第一种是 ai_blob_score 过高。它通过 diff 中「40 行以上且没有测试的函数」等线索做启发式判断。触发后,驱动器立即调用 /ponytail-review 做重构,再次检查,直到告警解除。原文没有给出完整计分公式和具体阈值,不能把它当成通用的复杂度标准。
第二种是 spec_drift: check manually,用于提示修改了规格任务清单没有覆盖的文件。驱动器会读取任务拆分,逐个核对被修改的文件,防止无关改动顺便混进提交。
这些规则原先已经写在 CLAUDE.md 中。改变在于执行时机:从等待最后审查,变成开发途中必须通过的关卡。
规则写进文件只是起点,让流程依据检查结果停下来,才形成约束。
唯一强制保留的人工检查点在第 1 层结束时。驱动器展示规格后,直接结束当前轮次并等待批准;批准之后,剩余流程才连续执行。它不是给自己弹一句提示,再自行判断「可以继续」。
实际案例证明了多少
作者给出的案例是 App Scaffold — ai-starter#3:包含 5 个任务,使用 Rails 8.1 API 和 React 19.2 两套技术栈,全部 Docker 化,打通注册、登录、退出,并使用 Playwright 验证端到端流程。
他报告的结果是:5/5 个任务交付,blob score 为 3/20,没有触发重构,没有失败测试。PR 正文由 stats 层根据会话指标生成,数据来自阶段检查所用的同一份报告。
这些结果能说明这套流程至少跑完过一个具体功能,但不能据此推出普遍的提效比例。作者自己的知识库对比笔记给出的人工估时是 17 小时,覆盖这 5 个任务;然而会话计时器只记录内部的一段时间,并非可靠的实际经过时间。作者因此没有公布所谓效率倍数。
这个克制很重要:人工估算和内部计时,不能直接组成可信的速度对照。
我的判断
我认可作者把注意力放在交接环节。日常 AI 编程里,规格、测试和审查可能都存在,缺少的却是明确的推进条件。比起继续往 CLAUDE.md 追加要求,驱动器提供了一个更具体的执行办法。
但案例中的交付数字仍是作者自述,没有同类任务的对照数据。它证明了一次运行结果,尚未证明比手动串联技能、现有 CI 检查更快或更可靠。
两者的差别主要在检查时机。CI 通常在提交或推送后执行;这里的关卡放在开发阶段之间,能更早要求处理问题。是否值得增加这层调度,要看团队现有检查是否已经覆盖这些环节。
局限也很明确。行数只是代码复杂度的粗略代理;文件在任务清单里,也不代表业务逻辑就正确。作者同样承认,错误的业务决策完全可能被实现成整洁、通过测试的代码。
第 1 层的人审负责确认方向,后续自动检查负责约束执行,两者不能互相替代。
能拿来做什么
- 给现有 AI 编程流程增加明确的阶段关卡,先从检查任务清单与实际修改文件是否一致开始,遇到未覆盖的改动就暂停核对。
- 在 React、Node 等项目里尝试函数行数告警时,把它作为触发审查的线索,并结合测试判断,别直接套用为代码质量评分。
- 让 AI 展示规格后真正暂停,确认需求边界和任务拆分,再授权连续实现,避免错误方向一路自动跑完。
- 让 PR 正文引用实际测试和检查结果;如果要统计提效,先统一计时范围,不要用人工估时除以口径不明的会话时间。