AI代码审查应看缺陷拦截效果
文章指出,评论数量、审查次数和运行时延只能反映 AI 审查工具的活跃程度,无法证明代码质量改善。评估应围绕是否减少有问题的合并展开,以判断审查工具是否真正有效。
AI 深度解读
AI 审查接进 CI,每个 PR 都有评论,就算上线成功了吗?作者 Honey Kiran 的答案是:运行成功和审查有效是两回事。真正要验证的是,它有没有减少带着问题合并的代码,而不是一周写了多少条建议。
这篇文章给出了一套从日志、抽样到规则调整的 30 天方案。对已经使用 AI Code Review 的前端和全栈团队,最有价值的是把「感觉它挺有用」变成可以检查的证据。不过,文中的表格是示例,并非经过对照实验验证的收益报告。
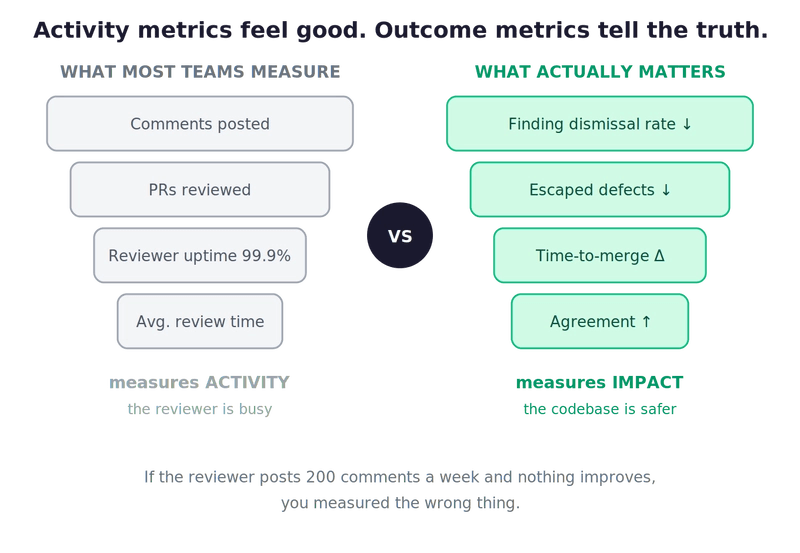
评论越多,为什么可能越没用
作者举了一个很直接的例子:AI 每周发出 200 条评论,工程师忽略了其中 190 条。此时,评论数越好看,通知噪声可能越严重。
PR 覆盖量、审查耗时、任务在线率仍然能帮助排查基础设施问题,但它们只能证明工具运行过,不能证明代码更安全。作者建议用五项指标检查实际效果:
| 指标 | 要回答的问题 |
|---|---|
| 发现项驳回率及原因 | 哪些建议没人处理,为什么? |
| 逃逸缺陷 | 哪些真实问题仍然进入了合并后的代码? |
| 信号比例 | HIGH 级发现占全部发现的比例如何变化? |
| 合并时间差 | 有问题和无问题的 PR,分别增加了多少等待? |
| AI 与人工一致率 | 双方分别发现了哪些对方漏掉的问题? |
驳回原因尤其关键。false-positive 是判断错了,wont-fix 是决定不修,already-handled 是已有其他措施处理,not-applicable 则是规则不适用于当前服务。四种情况需要四种处理方式。某条规则被以「不适用」为由驳回 30 次,继续优化提示词未必有用,先缩小适用范围更合理。
逃逸缺陷不能只从 AI 评论里找。作者建议每周抽查 5–10 个已合并 PR,尤其检查那些「AI 提醒过,人工驳回了」的变更。如果问题确实存在,说明模型判断和团队处理流程出现了脱节。
人工对照则每月做一次,抽取 10 个 PR,让人工先独立记录问题,再与 AI 结果比较。先独立审查很重要,否则人看过 AI 评论后,容易被它带着走。
审查工具的成绩单应该记录问题有没有被处理,而不是它有没有开口。
先把发现项记下来,才有资格谈调优
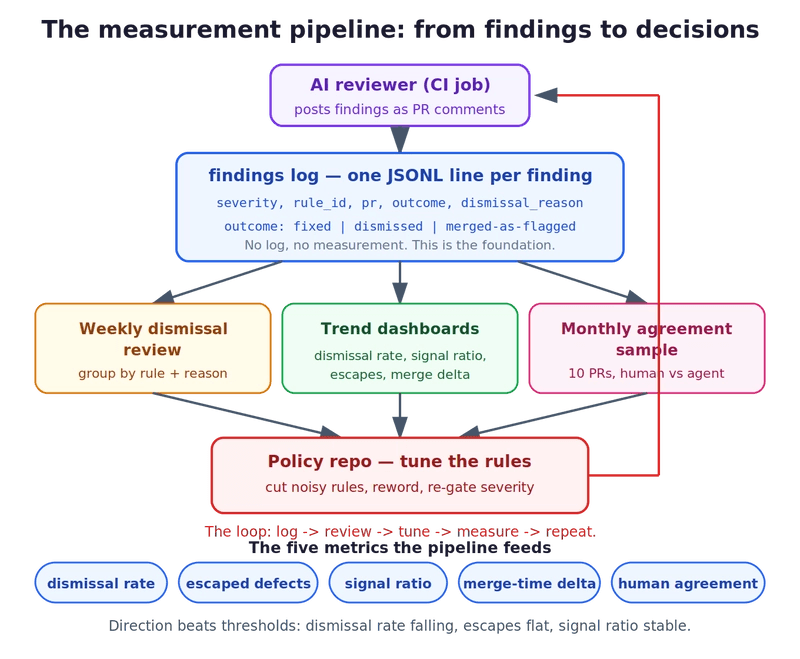
作者没有要求先建设复杂平台,而是建议使用 JSON Lines:每行一个 JSON 对象,记录一条发现及其处理结果。
下面这条日志把规则、严重度、PR 和驳回原因关联起来,后续才能按规则统计噪声:
{"ts": "2026-09-20T14:02:11Z", "rule_id": "tf-no-public-s3", "severity": "HIGH", "pr": 4821, "file": "modules/storage/main.tf", "outcome": "dismissed", "dismissal_reason": "not-applicable"}
要看清这一行里的 outcome 和 dismissal_reason:前者记录结果,后者解释为什么这样处理。只有发现内容,没有最终结果,仍然无法判断审查效果。
作者重点强调五个字段:rule_id、severity、outcome、dismissal_reason、pr。其中,outcome 使用 fixed、dismissed、merged-as-flagged,分别表示已修复、已驳回、带着标记合并。驳回原因使用前述固定词表,避免自由文本难以聚合。
如果当前 AI 只会发布 PR 评论,第一周可以用一个小任务,每晚将评论整理成这种结构。作者重视的是先固定记录格式。
但原文没有交代一条发现从提出到修复,如何持续关联。同一 PR 可能更新多轮代码,评论也可能过时。实际落地时,需要补上稳定的发现标识和状态更新方式,否则同一个问题可能被重复统计。这是文章方案里尚未展开的工程细节。
30 天里,先删掉最吵的规则
作者把第一个月分成四段。
第 1–7 天建立日志,要求每次驳回都填写原因,同时记录调优前的合并时间基线。第 8–14 天按规则和原因复盘,发现明显不适用的检查就立即处理。第 15–21 天调整规则措辞、范围和严重度门槛,再做一次人工对照。第 22–30 天比较前后半月的趋势,写下继续使用、继续调整或停用的决定。
文章给了一组明确标注为示意的数据:一周大约 200 条发现,其中几条规则如下。
| 规则 | 发现数 | 驳回数及比例 | 调整建议 |
|---|---|---|---|
tf-require-tags |
41 | 38,93% | 测试夹具不适用,限定到非测试路径 |
go-ineffectual-assign |
22 | 3,14% | 工程师愿意修复,保留 |
tf-no-public-s3 |
9 | 1,11% | 保留,有争议也值得讨论 |
md-line-length |
34 | 34,100% | 团队决定不修,删除 |
k8s-latest-tag |
18 | 12,67% | 已由基础镜像固定,改查渲染后的清单 |
这张表展示了「驳回率加原因」的用途。测试夹具被误扫,需要改范围;团队不接受的格式建议,需要删规则;上下文已经处理的问题,需要改变检查对象。统一降低严重度解决不了这些差异。
作者用「15 条精准规则胜过 50 条嘈杂规则」概括调整方向,并用删掉其中 35 条作说明。这些数字表达的是取舍思路,不能当成通用配额,也不能直接照着示例删除自己项目里的规则。
第一个月之后继续按月复盘。代码、模型和策略都会变化,一次调好不代表长期有效。文中的 90 天示意图描绘了理想趋势:驳回率下降,信号比例保持,逃逸缺陷没有增加;它没有提供真实团队的完整时间序列。
我的判断
我认同作者把注意力从「评论产量」转向「处理结果」。尤其是记录驳回原因,比笼统问一句「AI 好不好用」更容易指导调整。
但这套方案属于经验性方法,原文没有给出上线前后的真实对照数据。「10 个 PR 足以看出轮廓」可以作为启动抽样的建议,不能据此证明覆盖率;「逃逸缺陷为零,可能是查得不够」也只能作为提醒,不能反过来认定团队一定漏查了。
几个指标还需要结合上下文解释。
HIGH 占比升高,可能是删掉了无用建议,也可能只是把严重度调高;驳回率下降,可能是准确率提高,也可能是工程师不再逐条反馈。文章对信号比例的描述也有一点不一致:先谈未被驳回的发现,随后又使用 HIGH 除以全部发现。团队应先固定分母,再比较趋势。
合并时间同样受 PR 大小、排队和人工审查影响。所有 PR 都变慢,不能直接归因于 AI;没有明显变慢,也不能证明 AI 没有发挥作用。更可靠的做法是结合具体发现,解释时间花在了哪里。
和 ESLint、类型检查等确定性工具相比,AI 应该证明自己在上下文判断上有额外价值。作者最后用「有没有抓到人工漏掉的真实问题」追问价值,这个方向成立,但不能因此否定 linter 本身的价值。重复发现也可能提供及时提醒,是否值得保留,还要看成本和团队的处理方式。
这套方法适合用来发现审查流程的问题,尚不足以单独证明 AI 提高了代码质量。
能拿来做什么
- 已经给前端或 Node 仓库接入 AI 审查的团队,可以先整理最近一周的发现,为每条补齐规则、严重度、PR 和处理结果,并将驳回原因限定为固定词表。
- 每周抽查 5–10 个已合并 PR,既看 AI 提醒后被驳回的问题,也检查其他漏网问题;不要把「没有评论」直接记成「没有缺陷」。
- 每月选取 10 个 PR 做独立人工对照,把 AI 独有发现和人工独有发现分别记录下来,用后者寻找规则覆盖缺口。
- 调整规则时优先检查高频驳回项,每次写清是删除、缩小范围还是改检查对象;到第 30 天结合趋势和具体案例,记录继续使用、调整或停用的理由。