cortiq CUDA 实测:长上下文的速度取舍
Rust 推理引擎 cortiq 0.8.67 新增原生 CUDA 后端;作者在 A40 上测试同一量化模型,4000 token 输入下生成速度为 111.5 token/s,高于 Vulkan 的 80.2。64000 token 测试显示首 token 延迟与解码速度存在取舍,CUDA 峰值显存为 8.2GB,不能用解码时的 3.9GB 推断最低显存需求。
AI 深度解读
同一个 Spark 模型文件,换成 CUDA 后能快多少?cortiq 0.8.67 给出了作者在 NVIDIA A40 上的一组结果:4,000-token 输入后,生成速度从 Vulkan 的 80.2 提升到 111.5 tokens/s,首 token 等待也缩短了。
更有意思的是长上下文:Turbo 用近似表示压缩远处的历史,让持续生成更快。但首 token、显存峰值和信息保真度需要分开看。这组实验值得参考,却还不能当作通用性能结论。
同一张 A40,为什么还要分两种速度看
cortiq 是社区开发者 infosave(Oleg Kirichenko)开发的 Rust 推理引擎,从单个 CMF 文件运行 Spark-X2.6-4B。0.8.67 新增原生 CUDA 后端,Spark 是首个支持的模型。
短输入测试使用同一个 4-bit 文件。4,000-token 提示词之后,CUDA 为 111.5 tokens/s,Vulkan 为 80.2;首 token 时间分别是 0.66 秒和 1.06 秒。
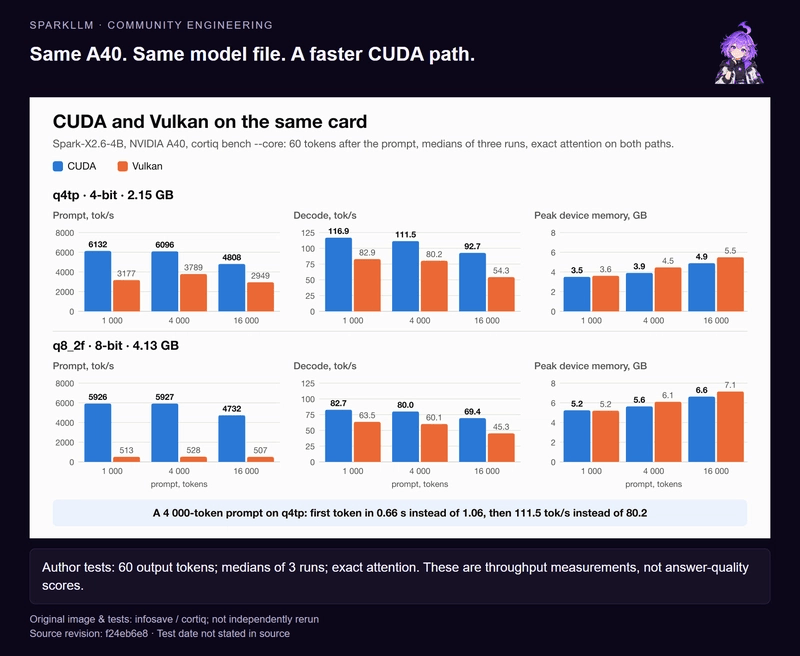
到 64,000-token 输入,结论开始分叉:
| 路径 | 首 token 时间 | 后续生成速度 |
|---|---|---|
| CUDA Turbo | 42.3 秒 | 100.7 tokens/s |
| Vulkan | 60.3 秒 | 85.9 tokens/s |
| CUDA 精确注意力 | 29.8 秒 | 53.4 tokens/s |
后续速度测的是生成 500 tokens。精确注意力最先开始回答,Turbo 则生成得更快。只需要一句结论和需要一篇长报告,适合的路径可能不同。
首 token 时间和持续生成速度,必须分开评估。
测试环境是 Ubuntu 24.04、驱动 595.91、CUDA 12.8 库。短测试生成 60 tokens,取三次运行的中位数;长生成及其显存数字,每条路径只有一次 500-token 运行。这些是作者实测,并非 SparkLLM 新一轮官方基准,重复性证据仍有限。
Turbo 压缩了历史,为什么显存峰值还会增长
CUDA 后端用 cuBLAS 处理提示词,用专用内核逐 token 生成,模型文件在不同后端之间保持不变。
超过 8,192 tokens 后,Turbo 保留选中的精确注意力行,把更远的上下文汇总成固定大小的 far field。可以把它理解为:较远的信息不再全部逐项保留,而是用压缩表示参与后续计算。这部分注意力是近似的。
但 CUDA 会先用精确注意力读完整个提示词,再固定这份远场表示。因此,生成阶段占用可以稳定,读取长输入时的峰值仍会增长。
64,000-token 测试中,CUDA 生成阶段显存为 3.9GB,整次运行峰值却是 8.2GB。不能据此推断 3.9GB 显卡就能跑通。
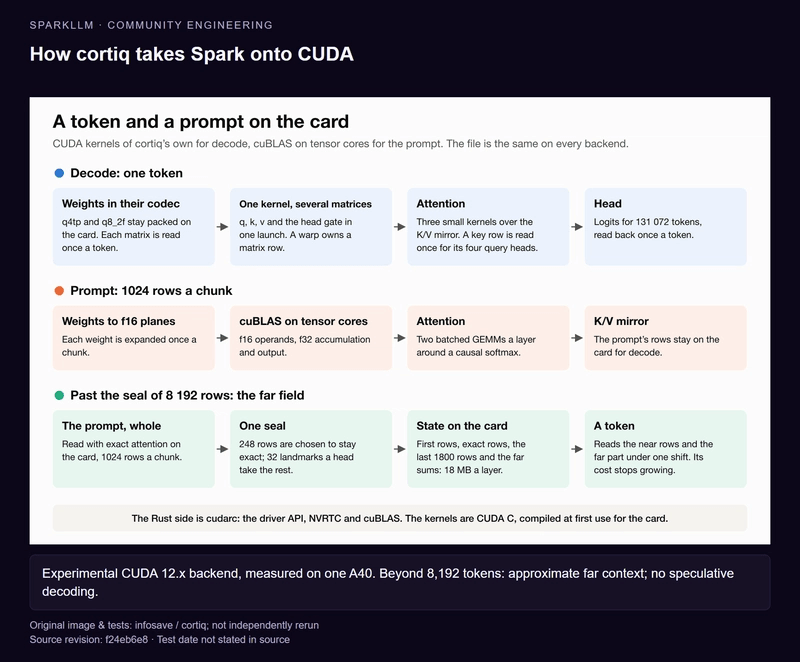
这条路径还有两个边界:远场固定后,新增一轮对话会重新读取会话;当前 CUDA 后端不支持推测解码(speculative decoding)。所以,单次长文生成的成绩,不能直接代表多轮聊天体验。
作者此前在 RTX 2000 Ada 16GB 上用 Vulkan 测过 Turbo:64k 输入下,Turbo 与标准路径分别为 56.2 和 18.5 tokens/s,峰值显存为 4.2 和 7.9GB。不过,短提示词的首 token 并非总会更快。那套 Vulkan/Metal 提示词处理策略也不同,不能拿旧图解释 A40 的 CUDA 实现。
跑得快,是否还能找回长文里的细节
远场是近似表示,就要把质量证据摆在速度旁边。
早期 Turbo 讨论中的植入密码检索,报告成绩为 6/8;新版 CUDA 模型卡在各自规定的设置下,对 60k、120k、240k 字符输入均报告 8/8。这里的单位是字符,并非 token。
结果有参考价值,但样本很小,而且版本和设置不同,不能当作受控的质量提升对照,更不能推出长文事实都能完整保留。
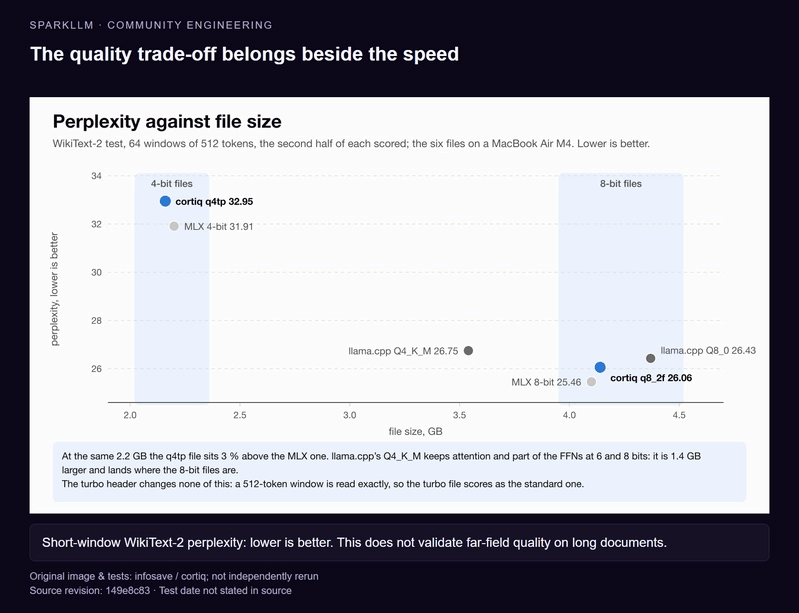
早期模型卡还测了 WikiText-2 困惑度:4-bit cortiq 文件为 32.95,体积相近的 MLX 文件为 31.91,越低越好。但测试窗口只有 512 tokens,使用精确注意力,没有覆盖长上下文远场质量;文件大小和量化方案也不同。
跨引擎比较同样要谨慎。提示词处理和持续生成可能分别由不同引擎领先;Mac Activity Monitor 的 footprint 与驻留集对映射文件页的统计不同,这些进程内存数字也不是 CUDA 显存需求。作者测试的 CPU 服务器上,llama.cpp 在部分条件下更快,Turbo 在 CPU 上则按标准文件运行。
我的判断
我认可这篇文章把收益和代价放在一起:同卡、同文件比较 CUDA 与 Vulkan,比混用模型文件的横向排名更容易解释。
但最有吸引力的长上下文结果,每条路径只跑了一次,质量探针也不足以覆盖真实任务。它支持的是「值得拿自己的文档试」,还不足以支持「可以放心替换现有引擎」。
相较精确注意力,Turbo 用远处上下文的近似表示换取持续生成效率。如果任务依赖分散在全文中的精确细节,检索密码成功只是起点。相较先检索片段再交给模型的做法,原文没有提供对照,不能认定整篇输入更划算。
选型应该比较完整任务的等待时间和事实保留情况,而不是只比 tokens/s。
能拿来做什么
- 有 NVIDIA 环境时,可以按下面的原始命令试跑。需要 cortiq 0.8.67 或更高版本、NVIDIA 驱动和 CUDA 12.x 运行库;预编译发行版不包含这个后端。
下面这组命令完成 CUDA 功能安装、模型下载和文件提示词推理:
cargo install cortiq-cli --features cuda
hf download infosave/Spark-X2.6-4B-turbo-CUDA-cmf spark-x2.6-4b-q4tp-turbo.cmf --local-dir .
CMF_GPU=cuda CMF_MAX_SEQ=131072 cortiq run spark-x2.6-4b-q4tp-turbo.cmf --prompt-file report.txt --greedy --no-think
重点看第三行的 CMF_GPU=cuda;运行前还要检查 cortiq gpu,缺少 CUDA 库可能导致回退到 CPU。
- 用自己熟悉的项目文档或技术报告做测试,提前列出必须保留的事实,再同时记录首 token 时间、峰值显存、生成速度和回答准确性。
- 分别测试短回答、长回答和追加一轮追问。若准备接入 Node 服务,这三种请求应分别记录耗时,避免用单次长生成成绩估算全部接口体验。