AMD 推出本地企业编程 AI 平台
AMD 与 Spectro Cloud 推出 Instinct Coder 355,基于八张 MI355X 加速卡在本地部署 GLM-5.3,配套推理管理软件。官方称单节点最多服务 85 名开发者、支持 50 人并发,并宣称可达到前沿模型 98% 的性能。
AI 深度解读
AMD 和 Spectro Cloud 推出的 Instinct Coder 355,想把企业 AI 编程助手需要的模型推理搬进本地机房。它支持部署 GLM-5.3,默认使用本地算力,并宣称能达到前沿模型 98% 的性能。
对程序员来说,看点不只是硬件有多强,而是团队能否集中提供 AI 编程服务。不过,原文没有交代「98%」的测试口径,也没有价格、延迟和实际编程任务表现。这是一条产品发布消息,还不足以证明本地方案已经能替代云端服务。
它把哪些 AI 编程能力放到了本地
据原文报道,AMD 于当地时间 11 月 9 日宣布与 Spectro Cloud 合作推出 Instinct Coder 355,IT之家于 11 月 11 日报道。它面向企业,支持 GLM-5.3 推理部署。这里的「推理」就是运行已有模型,让模型根据输入生成回答或代码,原文没有涉及模型训练。
Spectro Cloud 提供配套的 PaletteAI Inference Launchpad 管理软件,系统默认调用本地算力,而不是云端 API。这个设计把模型服务的运行位置放到了企业侧,但原文没有说明它如何接入编辑器、支持哪些编程助手,也没有给出兼容的 API。
本地部署说明模型在哪里运行,不能单凭这一点判断编程助手是否好用。
对前端和全栈开发者而言,生成代码只是工作流的一环。能否读懂项目上下文、配合现有工具完成修改,还需要具体的软件集成信息,而这条消息没有展开。
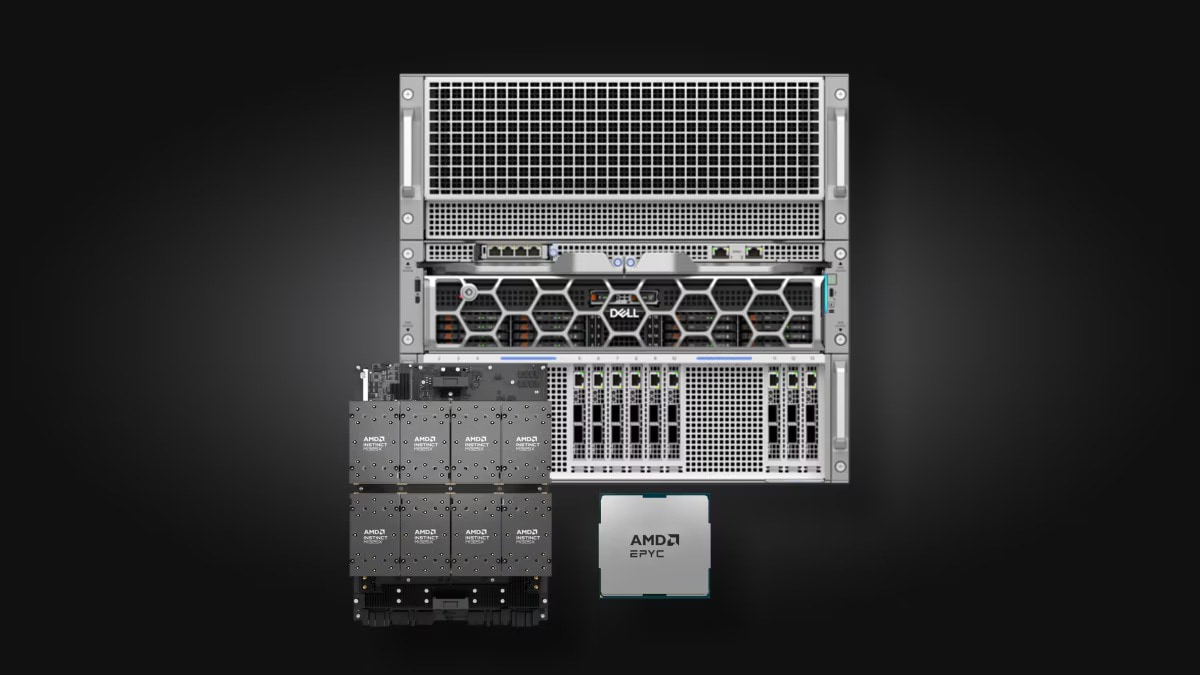
85 位开发者背后,需要多大一套硬件
Instinct Coder 355 的核心配置包括:
- 8 张 AMD Instinct MI355X 显卡加速器。
- 2 颗各有 64 核的 EPYC 9575F「Zen 5」CPU。
- 3TB DDR5-6400 RDIMM 内存。
- 合计 63.36TB 的 SSD 存储。
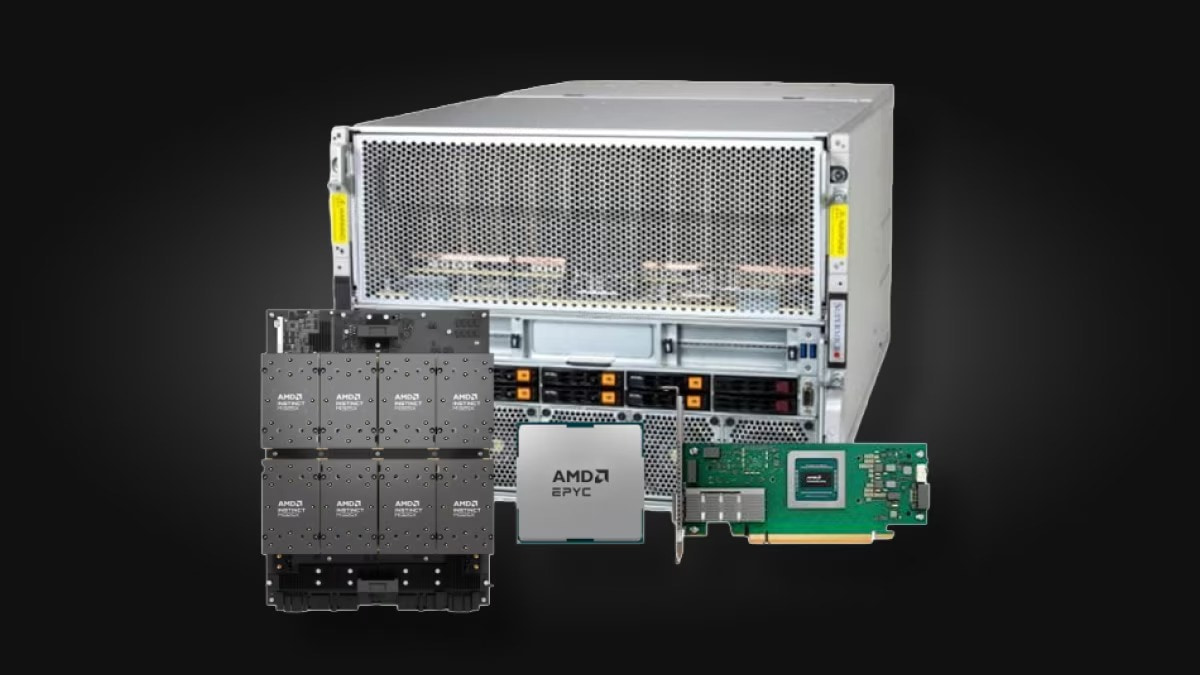
戴尔版本和 Supermicro 版本的其他规格存在差异,原文没有列出具体差别。这套配置显然面向团队共享的模型服务,普通开发者很难直接照搬到个人电脑上。
原文给出的容量是:每个节点最多满足 85 位开发者的需求,其中并发为 50 位。两个数字不能混着看。85 位是所称的服务人数,50 位才是所称的同时使用规模;但「并发」究竟按在线会话、同时请求还是其他方式统计,原文没有说清。
容量也不能脱离任务负载理解。短代码补全、长上下文问答和持续生成代码,对服务的压力并不一样。缺少请求长度、输出长度和响应时间,就无法据此推算自己团队的使用体验。
我的判断
这套产品有价值的方向,是把本地模型部署、集中算力和管理软件组合起来。对正在考虑自建 AI 编程服务的企业,它提供了一个可以进一步评估的整体方案。
但最吸引眼球的「前沿模型 98% 的性能」,也是最需要追问的部分。「性能」指代码正确率、某项基准得分,还是推理速度?对照的是哪个模型?使用什么精度和配置?原文均未交代。
「98%」目前只能作为产品宣称引用,不能当作已经验证的编程能力结论。
这条报道没有作者实测,也没有团队使用记录或对照数据,甚至不足以构成经验判断。与调用云端 API 相比,本地方案让企业直接承担算力部署与运维;与自行组装推理服务相比,它提供了配套管理软件。两种比较都还缺成本、维护工作量和实际效果的数据,暂时不能判断哪条路线更划算。
另外,「默认本地运行」没有回答全部数据处理问题。日志、管理服务和其他组件如何处理数据,仍需看完整技术说明。
能拿来做什么
- 如果团队正在评估本地 AI 编程服务,可以把这套配置作为询价和容量测试的参考,并要求供应方解释 85 位开发者、50 位并发对应的负载条件。
- 用现有前端或 Node 项目的真实任务做验证,例如组件修改、接口排错和跨文件调整,同时记录结果正确性与响应时间,避免只看模型基准分数。
- 在采购前确认 GLM-5.3 的部署配置、编辑器接入方式、API 兼容性和 PaletteAI Inference Launchpad 的管理范围;这些直接影响开发者能否顺利用起来。