限制 AI 爬虫要靠站点访问控制
文章援引 RFC 9309,说明 robots.txt 的规则依赖爬虫自愿遵守,服务器仍可能收到请求。文中还区分了收集训练数据、建立搜索索引和响应用户请求的抓取行为。
AI 深度解读
如果你想让技术博客出现在 ChatGPT 的搜索答案里,同时明确拒绝内容被用于模型训练,可以分别给搜索爬虫和训练爬虫设置规则。原文讲的是这两种用途怎么区分,以及什么时候单靠改 robots.txt 已经不够。
对维护文档站、博客或产品官网的开发者,最实用的是把两个问题分开处理。你希望平台怎么使用公开内容,由 robots.txt 表达。你允许哪些请求真正拿到页面,则要由 CDN、源站或应用决定。
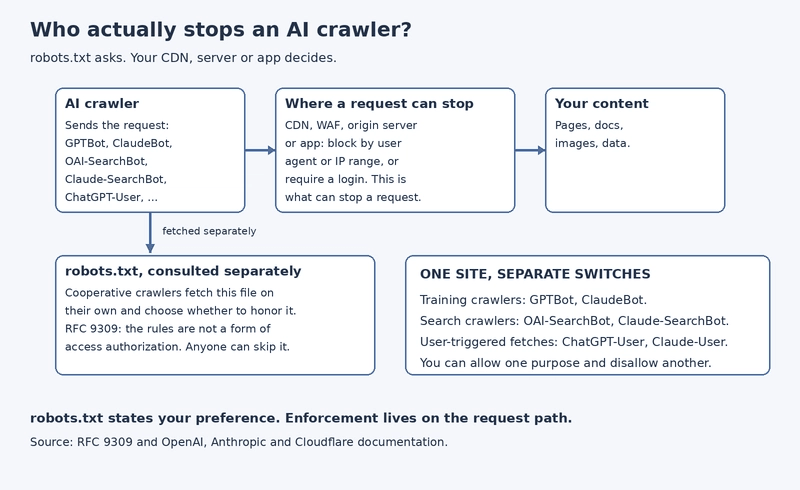
为什么写了 Disallow,请求还是能进来?
IETF 在 2022 年通过 RFC 9309 将爬虫排除协议(Robots Exclusion Protocol)标准化。规范明确说明,这些规则不构成访问授权。配合协议的爬虫会单独读取 robots.txt,再根据规则决定是否抓取页面。任何客户端都可以跳过这一步,直接请求目标 URL。
所以,Disallow 能给遵守协议的爬虫传达限制,却没有给页面加上权限检查。假如一套内部文档部署在公网,打开链接就能读,给它加一条 Disallow 也不会改变服务端返回正文的行为。
拒绝模型训练,还能保留 AI 搜索曝光吗?
按原文引用的平台文档,可以把训练、搜索和用户触发的读取分开设置。OpenAI 和 Anthropic 都为这三类用途公布了独立的爬虫标识。
| 用途 | OpenAI | Anthropic |
|---|---|---|
| 收集可能用于模型训练的网页内容 | GPTBot |
ClaudeBot |
| 为 AI 搜索发现网页或改善搜索结果 | OAI-SearchBot |
Claude-SearchBot |
| 响应用户问题,按需读取网页 | ChatGPT-User |
Claude-User |
例如,维护开源组件文档时,你可以对 GPTBot 和 ClaudeBot 声明 Disallow,同时允许搜索爬虫访问。OpenAI 表示,拒绝 OAI-SearchBot 后,站点不会出现在 ChatGPT 的搜索答案里,但仍可能作为导航链接出现。更新 robots.txt 后,搜索侧可能需要约 24 小时才会调整。至于 ChatGPT-User,OpenAI 说明这类访问由用户发起,robots.txt 规则可能不适用。
Anthropic 表示它的爬虫遵守 robots.txt,支持非标准扩展 Crawl-delay,并要求在每个需要覆盖的子域名上单独设置规则。按原文所述,自 2026 年 10 月 30 日起,Anthropic 开始逐步识别一种基于 IETF 草案的机器可读信号,用来表达拒绝 AI 训练的偏好。显式针对 ClaudeBot 的规则优先于这项通用信号。
真要挡住请求,应该在哪一层动手?
请求必须经过 CDN、WAF、源站或应用。只要其中一层有匹配的拦截规则,请求就可以在返回正文之前被挡下。以原文介绍的 Cloudflare AI Crawler and Agent 访问策略为例,Search、Agent、Training 可以分别配置,Block 会在边缘拦截匹配的请求。新域名的三类行为默认都是 Allow。
容易看错的是 Training 下的 Disallow。这个选项只写入 robots.txt 指令。要在边缘实际拦截训练爬虫,还得开启额外的边缘封锁选项。
用自己的服务器也能按 User-Agent 拒绝请求,或按平台公布的 IP 段过滤。OpenAI 为每个爬虫分别发布 JSON 格式的 IP 列表。Anthropic 则提醒,封锁它的爬虫 IP 可能连 robots.txt 也一起挡住,因此仅靠封 IP,未必能持续传达退出训练的偏好。内容本身需要限制访问时,可以在应用层要求登录,再向有权限的用户返回正文。
如果希望助手读懂文档,llms.txt 能做什么?
llms.txt 提议在站点上放一份 Markdown 文件,用简明的专业说明和页面的 Markdown 版本链接,帮助手找到适合读取的资料。这个提案于 2024 年首次发布,2026 年更新到 v2,目前仍是提案。原文援引提案称,已有数千个站点发布这种文件,OpenAI、Anthropic 和 Gemini 也发布了各自的版本。
对文档站来说,可以把它理解成一份面向助手的阅读入口。比如,组件库可以把安装说明、版本对应的 API 文档和迁移指南组织在一起,减少助手从页面导航里找入口的工作。
我的判断
按用途管理爬虫有实际价值。训练、搜索和按需读取能分别配置,维护者就可以先决定文档要在哪些场景里被访问,再写规则。文章依据规范和平台文档解释这些开关,但没有给出部署前后的抓取日志,也没有对照数据说明开放搜索爬虫后,页面实际被引用的频率会怎样变化。允许抓取只解决访问条件,引用还要看平台如何选取结果。
执行上,按 User-Agent 拦截适合处理能识别的流量,请求方也可以自行填写这个字段。IP 规则依赖名单的覆盖范围和更新情况。对于只应向部分读者开放的文档,登录后的权限检查能直接按读者身份做决定。至于 llms.txt,原文没有比较它与现有文档入口对回答准确率的影响。作者关于加一份文件有助于助手读懂产品的建议,属于经验判断。
能拿来做什么
- 给公开博客或组件文档梳理一遍训练、搜索和按需读取的访问意图,再为对应爬虫分别写
robots.txt规则。文档放在独立子域名时,也检查那个子域名实际返回的文件。 - 使用 Cloudflare 时,核对
Training下选的是Disallow还是Block。如果目标是在边缘拒绝访问,到请求日志里确认匹配流量实际被拦截。 - 检查需要登录的前端文档页时,同时验证页面 URL 和返回正文的 Node API,确认未登录请求无法从任一入口拿到文档内容。
- 如果公开文档已经提供 Markdown 版本,可以先用一份短
llms.txt收录安装、API 和迁移入口,再用同一组常见问题观察助手能否找到对应资料。