Cloudflare 开放两款结构化抽取模型权重
Clairic 和 Clairic-flash 以 Apache 2.0 许可发布权重,可按调用方指定的结构从文本、图片和 PDF 页面抽取数据,也可通过 Workers AI 调用。Cloudflare 自测中,两款模型在新文本字段抽取上的中位延迟分别为 358 和 155 毫秒。
AI 深度解读
Cloudflare 在 2026 年 11 月 18 日开放了 Clairic 和 Clairic-flash 的权重。这两个模型专做结构化抽取:你给它文本、图片或 PDF 页面,再指定要哪些字段,它就按字段返回带类型的值、置信度和定位信息。新版 Clairic 有 270 亿参数,Clairic-flash 有 90 亿参数,主打低延迟。
Cloudflare 自测中,新版 Clairic 在 336 个新文本字段里答对了 335 个,Clairic-flash 答对 328 个,端到端延迟中位数则从 358 毫秒降到 155 毫秒。对要接票据、工单或合同的团队,这组数据可以用来选试点模型。生产验收还得看自家文档上的错误分布,以及置信度能拦住多少错。
抽取接口能给业务代码什么
请求由 state 和 schema 组成。state 可以是文本或 JSON,也可以附带图片。schema 把字段名映射到字段规格,由调用方决定要抽什么。响应逐字段返回带类型的值、置信度分数、字符区间和概率,同时报告输入是否被截断以及 token 用量。字符区间可以把文本字段定位回原文,前端做审核界面时就能让审核人直接看出处。
一条请求最多带 4 张图片或 4 页 PDF。商品明细按行返回,描述、数量和价格保持在同一行,业务代码可以直接按行处理。接入任意长度的 PDF 则多了一步:超过 4 页要先拆分,最好先识别页面类型或字段所在页,再决定哪些页一起送进去。合同正文、附表和附件的位置不固定,按页码机械切块可能把需要一起看的内容分开。
每个字段单独生成,为什么还能一起跑
预览版用一次前向计算解出所有请求字段。新版 Clairic 改成并行槽位自回归生成(parallel slot autoregressive generation)。每个字段占一个槽位,根据自己已生成的 token 继续写,遇到自己的结束标记就停。服务端在同一批次里同步推进各字段,所以长字段可以多写几步,短字段也能先结束。Cloudflare 报告称,这项改动带来了少量延迟开销,同时提高了文本和图片的抽取准确率。
模型还给估算、预测、时长、日期推算和显式算术配了专用输出头。这让「抄出租约起始日期」和「按租期推算结束日期」成为不同的输出任务,推算结果也有自己的置信度。原文没有给出算术错误的分类统计,无法从现有结果判断模型在哪些日期规则上容易算错。
准确率和延迟分别测出了什么
Cloudflare 公布了四组字段级评测。表里的分子是正确项数,分母是该组总项数。客户断言覆盖的是 139 种请求形态。
| 评测集 | 预览版 | Clairic | Clairic-flash |
|---|---|---|---|
| 新文本字段 | 295/336 | 335/336 | 328/336 |
| 内部混合输入字段 | 207/226 | 221/226 | 213/226 |
| 跟踪的客户断言 | 1,033/1,263 | 1,263/1,263 | 1,263/1,263 |
| 文本和图片中的合成票据字段 | 369/576 | 576/576 | 576/576 |
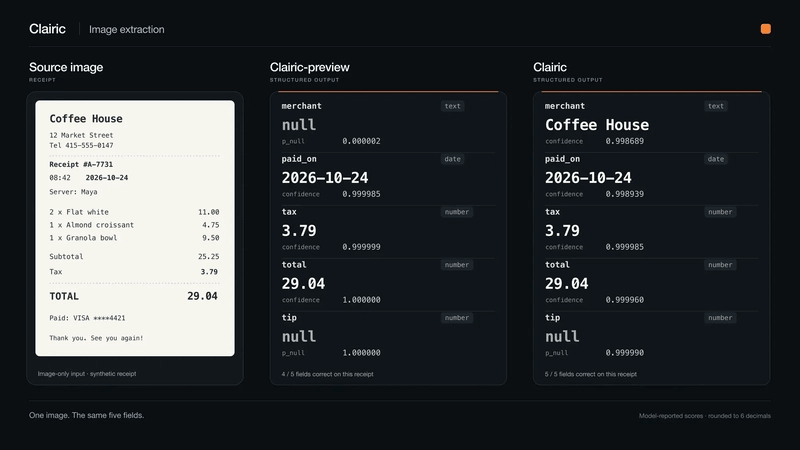
合成咖啡店小票给了一个具体例子。预览版把商家名称返回为 null,新版识别出了 Coffee House,5 个字段全部答对。这个例子能看出新版修正了哪类漏抽,复杂扫描件的表现还需要单独测。
延迟测的是自托管服务器返回全部字段的完整 HTTP 响应。p50 是中位数,p95 是 95% 的请求能在其以内完成的时间。
| 评测集 | Clairic p50 / p95(毫秒) | Clairic-flash p50 / p95(毫秒) |
|---|---|---|
| 新文本字段 | 358 / 736 | 155 / 328 |
| 新图片字段 | 453 / 976 | 305 / 605 |
| 商业租约 | 691 / 803 | 379 / 519 |
| 贷款定价 | 395 / 407 | 188 / 192 |
| 流量预测 | 532 / 585 | 243 / 261 |
| 费用审计 | 632 / 742 | 393 / 512 |
Clairic-flash 在多数测试集上的 p50 接近大模型的一半,图片字段的差距小一些。原文没交代测试批大小,也没公布并发吞吐。要估算一晚能清完多少份积压文档,还缺并发条件下每秒能处理多少请求的数据。
托管和自部署各有什么接入条件
Workers AI 的端点分别是 @cf/cloudflare/clairic 和 @cf/cloudflare/clairic-flash。已经指向预览端点的应用会原地收到新版。托管定价分别是每百万输入 token 0.24 美元和 0.10 美元,原文称截至 2026 年 12 月 1 日,两者都按 0.10 美元计费。输出 token 免费。
两款模型的权重都以 Apache-2.0 许可发布在 Hugging Face。模型卡标注的基座分别是 Qwen3.8-27B 和 Qwen3.5-9B,仓库还提供分词器、处理器文件和 Python 辅助代码,可以用 Transformers 本地推理。对文档必须留在自有基础设施的团队,这给了实际的部署选项,GPU 选型和容量仍需自行验证。
我的判断
Clairic 最值得试的是字段契约。通用模型配提示词和解析器也能产出结构化数据,适合顺带做摘要或解释。固定字段的文档流水线则更看重每次响应能否按同一规则验收。Clairic 把值、出处和不确定性一起交给调用方,业务流程可以逐字段决定自动入库、规则复算还是转人工。
准确率表能说明新版在 Cloudflare 自己的用例上进步了。原文称抽取领域还没有公开基准,Liquid AI 的 D1.2 搭配 Apple Vision 做 OCR,以及 ScaleDown 的 Extract,也都用 Cloudflare 的请求形态和测试框架打分。横向结果只能作方向参考。「专用模型比通用模型更便宜」在这里仍是经验判断,原文没给出同一批真实文档上的总成本对照,人工复核也会影响账单。
上线前尤其要补三类数据。歪斜扫描、盖章和手写的效果缺少分项结果;置信度没公开校准曲线,0.8 分对应多少正确率要用自己的样本测;算术输出也没有错误明细。对租约结束日这类算错后很难察觉的字段,可以先让模型抽取起始日和租期,再用业务规则核算结果。
能拿来做什么
- 从实际收到的小票、工单或合同里挑一批代表性样本,人工核对字段答案。同批跑 Clairic 和 Clairic-flash,按字段记录错值和漏填,看看大模型的额外开销换回了哪些关键字段。
- 在前端审核页保留字段置信度和可用的字符区间,让审核人能跳回原文。用测试集扫一遍不同阈值,统计每个阈值会漏掉多少错值、额外送审多少正确值。
- 在 Node 接入层处理超过 4 页的 PDF,先确定字段可能落在哪些页,再分批请求。把输入截断和关键字段缺失纳入处理流程,避免整次请求成功后直接把不完整的数据写入库。
- 用实际图片比例和目标并发跑一轮完整导入,记录端到端 p95、吞吐量和输入 token 用量,再决定批处理用哪个模型。