从三维渲染到手绘首尔:城市地图实战
作者用 three.js 和开放地图数据构建首尔,再以 33 对渲染与绘画样本微调图像模型,在 10 张 A100 上用 51 分钟重绘 6394 块瓦片。地图叠加车辆、行人和昼夜变化,部分地铁线路接入真实运营数据,文章还复盘了实施中的问题。
AI 深度解读
把首尔画成一张手绘地图,只是 HypeSeoul 的一半。作者还在画面下面保留了一座 three.js 城市,让汽车、行人和列车沿着真实空间运动,再把部分地铁接上运营数据。覆盖 603 km² 的 6,394 张瓦片,最终由 10 张 A100 在 51 分钟内完成重绘。
真正值得读的是它的工程取舍:生成模型负责画风,地图数据约束位置,传统图形算法修补接缝和遮挡。项目踩过的坑,也说明了为什么「每张图都好看」距离「整个产品能用」还很远。
让画面和城市对齐,比选模型更早决定成败
HypeSeoul 参考了 isometric.nyc 公开的方法,但作者说明没有复用其代码。底层融合 OSM、Overture Maps、韩国国土交通部 MOLIT 建筑数据和 DEM 地形,烘焙成约含 585k 栋建筑的 seoul.bin,再由 three.js 渲染。
所有环节共用固定正交相机,yaw 为 −0.42,pitch 为 0.56 rad。世界坐标到绘画像素之间因此可以用统一的仿射变换计算。汽车该出现在哪里、窗户该亮在哪里、模型有没有把河画错,都靠它对齐。
这张画能成为可交互地图,前提是每个像素仍然对应可计算的空间位置。
Playwright 按 1024×1024 截图,比例为 0.3 m/px,步长 768 px,相邻重叠 256 px。最后输出 768 px 的 RGBA WebP 瓦片,构建 z0–8 金字塔;透明边界来自首尔行政区轮廓,并经过 160 px 羽化。
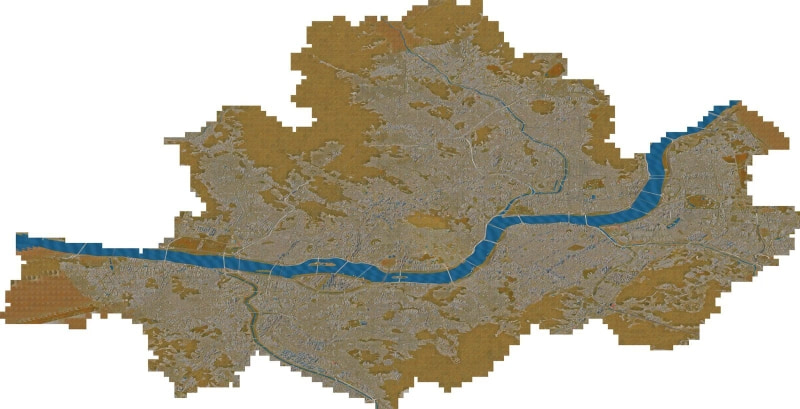
相机固定也限制了交互自由:这套绘画层适合平移、缩放,不能直接支持任意旋转视角。作者后续大量修补能够成立,都依赖这个约束。
51 分钟重绘的背后,是先清理训练数据
最初作者用 GPT 图像生成逐块重绘,但模型会移动汉江、凭空加池塘、在公园里造楼。他使用的套餐一天生成约 348 张便触及限制,而全城需要约 6,000 张,还没算夜景。
随后改用 FLUX.2 klein 4B,训练「引擎渲染图 → 绘画」的编辑 LoRA。麻烦先出在样本:输入缺楼,目标图却把空地补成森林;后来引擎增加占位建筑,输入与目标又不一致。pairscore.py 只保留输入漏楼低于 6%、目标虚构区域低于 20% 的样本,最后剩下 33 对。
训练和推理也必须匹配。用基础模型训练的 LoRA 接到快速蒸馏模型上,四个随机种子都会把宽路画成运河;换回 FLUX.2-klein-base-4B,问题消失。
最终配置是 rank 64、linear_alpha 32、1,500 steps、batch_size 1、学习率 0.0001,使用 adamw8bit、bf16 和 flowmatch。rank 32 到 1,500 steps 仍有虚构水体,rank 64 才稳定;16 张留出瓦片未发现虚构水体,另测 3 张×2 个种子,结果为 0/6。
T4 上固定在第 3 步 OOM,也不是单纯显存参数没调好。训练器把编辑参考图按 1024 px 输入,而目标只有 512 px,参考图 token 数达到同分辨率输入的 4 倍。将参考图降至 512 px 后,训练以 27 s/step 跑通。
正式推理采用 8 steps、guidance 1,关闭 classifier-free guidance,同样步数下单张耗时减少一半以上。10 个 A100 容器以约 4.9 s/张并行处理,51 分钟完成全部 6,394 张,没有报错、OOM、NaN 或缺图。
但 51 分钟只是转换阶段。截图从 01:01 开始,转换容器到 02:37 才启动。截至那时 Modal 累计用量为 $35.88,含 $30 免费额度;作者此前估算为 $31,差额包括各容器加载模型的开销。
独立生成的好图片,还要修成连续的地图
模型小样通过,不代表全城通过。949 张含水瓦片里,194 张至少有 80% 是水,其中 176 张未通过水体检查。原因很具体:训练集没有纯水面样本,模型遇到看不见河岸的汉江中央,就画成秋季森林。
检查规则利用了底层几何:引擎标记为水的像素,至少 85% 应满足 B > R + 30 且 B > G。修复则组合全城统一蓝色、跨瓦片连续的亮度场,以及保留或程序生成的波纹。
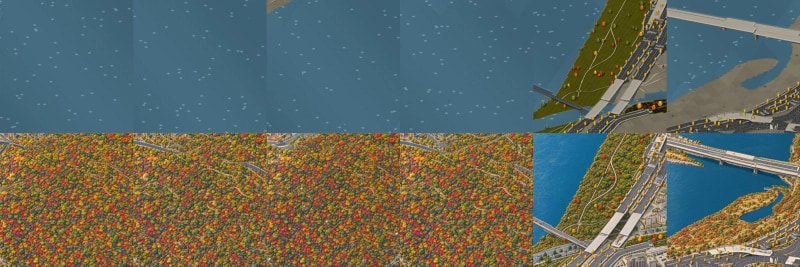
接缝需要另一套办法。作者以每张瓦片、每个通道的 3×3 控制点对数增益为未知量,在 1/8 尺度用 lsqr 求稀疏最小二乘,使重叠区域色彩接近,同时约束增益幅度与平滑性。重叠差异降至约四分之一。
建筑重影不能靠扩大混合区域解决。原来的 256 px 全宽渐变会把两种楼体轮廓叠出来,后来改成每张瓦片拥有中央 768 px 单元,只在边界附近 96 px 内混合。
桥梁更难:相邻瓦片里的同一座桥能错开 40 多像素,桥宽和车道设计也不同。最终 24 处跨河桥梁按两岸整体重绘,其中 15 座长桥分两段延续,共生成 37 张图。地标局部重绘后,再通过 ECC 仿射配准贴回,误差维持在约 0.6 px 以内。
还有一类「模型画错」其实是数据错。约 585k 栋建筑最初只有 92k、即 16% 带真实高度,错误估高让市场和学校变成公寓塔楼。接入 MOLIT 后,作者要求轮廓双向重叠均达到 50%,保留已有 OSM 真实高度,为 204k 栋建筑补充官方高度,再重绘墙面积变化超过 4% 的 1,747 张瓦片。
生成模型会忠实放大输入里的错误。
动态效果靠深度遮挡,实时数据靠缓存和推算
绘画盖住静态城市后,汽车既要出现在路面上,又要被前方建筑挡住。作者将运动物体再渲染成白色遮罩,共享主通道的深度纹理,开启深度测试、关闭深度写入。被建筑挡住的汽车,在遮罩里也不可见。
合成时,下面这段代码只在没有运动物体的位置覆盖绘画:
// POST_FS: the painting covers only where the mask is empty
vec4 p = texture2D(tPaint, vUv);
float mv = texture2D(tMove, vUv).r;
c = mix(c, p.rgb / max(p.a, 1e-3), p.a * (1.0 - mv));
c += texture2D(tGlow, vUv).rgb;
关键是 (1.0 - mv);灯光最后单独相加,避免探照灯经过时把绘画挖穿。运动物体仍来自主渲染通道,因此共享像素尺寸、轮廓、AO 和昼夜色调。
夜景也没有重新生成全城图片。浏览器压暗绘画,lights.py 根据建筑几何计算窗灯,生成 9,704 张瓦片,本地耗时 6 分钟,云端费用为 $0。但绘画修过之后,相关灯光数据也要同步修正。
底层城市仍会消耗 GPU。作者将实例预分到 400 m 地面网格,只上传可见单元。在同一汝矣岛视角,实例从 1.7M 降到约 5k,JS 内存从 2.2 GB 降到 0.75 GB,帧率从 46 提升至 73 fps。用 Node 预烘焙停车、行人和行道树位置,又将城市构建从约 7 秒缩至 1.25–1.5 秒。
地铁的「实时」则有明确边界。首尔 API 只返回车次、站名、方向、状态和时间戳,不提供坐标。作者为 1、2、3 号线及 Gyeongui–Jungang 接入数据,其他线路继续模拟。
每个 key 每天限 1,000 次调用。浏览器每 5 分钟访问 /api/subway,Vercel CDN 缓存 10 分钟,响应头为:
// api/subway.js (simplified)
res.setHeader('cache-control', 'public, max-age=60, s-maxage=600, stale-while-revalidate=300');
注意 s-maxage=600:单区域每天约需 576 次上游调用,多区域缓存会增加总量。key 只放服务端环境变量。
作者从原始 OSM .pbf 提取 524 个站点,用相隔两分钟的两次快照、共 8 次调用,采集 97 列移动列车以推断方向。报告间隔内按 11 m/s 外推,新位置用 6 秒平滑衔接。它是运营数据约束下的估计位置,并非实时定位。
我的判断
我更认同这篇的职责划分:模型提供画风,几何数据提供位置,检测和后处理维持连续性。对地图这类结构明确的产品,水体阈值、空间匹配、配准和缓存都比反复修改提示词更容易验证。
但它没有证明「33 对样本就足够」。样本来自同一城市、同一相机和同一引擎,任务范围很窄;16 张留出瓦片的结果,也不能覆盖后来暴露的纯水面缺口。样本数量与效果之间缺少系统对照,仍应视作项目经验。
同样,$35.88 不是完整产品成本,51 分钟也不是从数据准备到上线的耗时。微调、通用模型生成、程序化材质之间没有同条件比较。原文末尾还在列车部署结果处截断,无法据此判断长期运行表现。
能拿来做什么
- 做 three.js 与生成图片结合的场景时,先固定相机和坐标映射,再制作素材,并验证动画、遮挡和局部替换能否对齐。
- 批量生成前,先算清图片数量、单张耗时、调用配额和模型加载成本;测试集应包含纯水面、长桥等容易遗漏的极端输入。
- 对大规模 InstancedMesh 场景,检查实际提交的实例数量,参考空间分桶与可见实例压缩;静态位置计算可以前移到 Node 构建阶段。
- 接入限额 API 时,由服务端保管 key,结合 CDN、最后成功数据和客户端降级,并明确告知哪些位置来自报告、哪些来自推算。