实测房产接口返回如何挤占智能体上下文
作者通过 18 次房产 API 调用测量智能体需要读取的数据量,其中一页 25 条房源返回约 6.9 万字符,粗估占用 1.7 万个 token。案例揭示将原始接口响应直接交给 MCP 智能体时的上下文成本。
AI 深度解读
一次查询 25 套迪拜出租房,返回的 JSON 就可能占掉约 17,000 tokens。让 AI 比较三个片区、两个房产平台,还没开始写答案,六页搜索结果已经消耗约 105,600 tokens。问题出在工具把整份接口响应交给了模型。
作者用 18 次 API 调用拆解了这笔开销:工具定义有固定成本,搜索结果里还有大量图片地址、多语言字段和联系人信息。把结果裁成任务需要的字段后,六页数据降到约 11,250 tokens。对正在接 MCP、做 AI 数据查询的程序员,这比单纯换一个大上下文模型更值得先检查。
接上 MCP,为什么还没回答就读了十万 tokens
作者在 2026 年 11 月 3 日测试了三个接口服务:Bayut API、Property Finder API,以及用一个 key 接入两个平台的 UAE Real Estate API。
问题很具体:Dubai Marina、Jumeirah Village Circle 和 Business Bay 的一居室租金分别是多少?测试包括两个平台的位置查询、各片区的一页租房搜索、Property Finder 的租赁成交记录,以及完整房源和聚合接口的补充调用,共 18 次。
这些端点都能通过 RapidAPI 的 MCP gateway 调用,一个端点对应一个工具。作者测量的是紧凑 JSON 的字符数,再按每 4 个字符约 1 token 估算。文中的 token 数是统一口径的估算值,不是模型 tokenizer 的精确计数,也不是实际账单。
开销分两层。
第一层是工具定义。作者按 OpenAPI 文件生成工具名称、说明和输入 schema。Property Finder 的工具平均约 1,327 字符,Bayut 约 1,049 字符;Property Finder 的参数说明占了 48.3%。允许值、默认值和示例都有助于模型正确调用,不能只为省 tokens 就删掉。
作者给出的另一条路是他们维护的 Free Live Data MCP:把 48 个 API 放在 search_apis、search_endpoints、describe_endpoint、call_endpoint 四个工具后面,初始定义共 2,146 字符,约 536 tokens。模型先发现接口,再读取需要的参数,代价是每个任务多一两次往返。
第二层才是大头:工具结果。
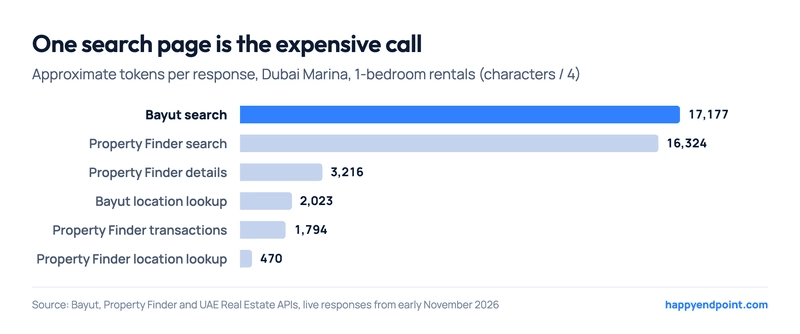
Dubai Marina 的 Bayut 搜索页约 17,177 tokens,Property Finder 约 16,324;后者的完整房源约 3,216,租赁成交记录约 1,794,位置查询只有 470。Bayut 位置查询约 2,023,因为返回了 25 个带完整路径的候选位置,Property Finder 返回的是 20 个较短候选。
三个片区的搜索页大小也接近:Bayut 为 17,098 至 19,527 tokens,Property Finder 为 16,324 至 18,126。可见开销主要跟响应结构有关,换个片区不会自然变小。
模型需要租金,接口却塞进了整棵位置树
Bayut 每条房源约 2,700 至 3,100 字符,其中 location 占 28.3%。它包含从 UAE 到楼栋的四至六级位置树,每级还有 name、阿拉伯语 name_l1、中文 name_l2、俄语 name_l3。category 同样包含多语言分类,占 16.8%。
Property Finder 的主要负担不同:images 占 37.8%,里面是带长版本字符串的图片 URL;location_tree 和 address 分别占 9.0%、7.2%。
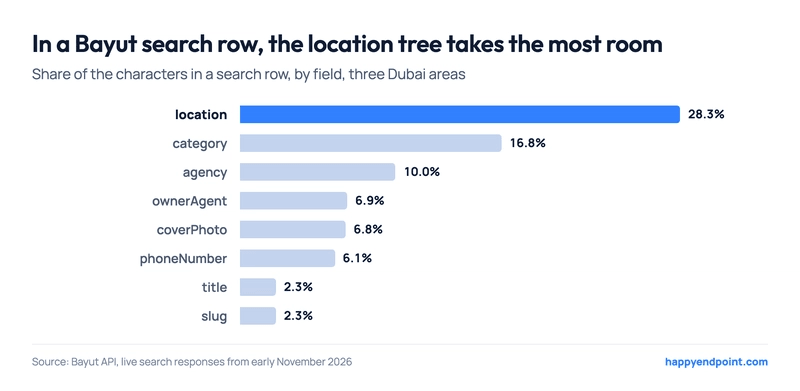
这些字段对房产网站页面有用,但回答租金问题用不到那么多。联系人数据也是如此:Bayut 的 ownerAgent、phoneNumber、contactName 合计占 14.1%,Property Finder 的 agent_details 占 14.7%。原样转发还会让姓名和电话进入模型上下文,以及可能记录响应的日志。
作者为 Bayut 保留了九个字段:
def trim(row):
    """租金问题需要的九个字段,使用扁平结构,并在键名中写明单位。"""
    return {
        "id": row["externalID"],
        "title": (row.get("title") or {}).get("en"),
        "rent_aed": row.get("price"),
        "per": row.get("rentFrequency"),
        "beds": row.get("rooms"),
        "baths": row.get("baths"),
        "area_sqm": round(row["area"], 1) if row.get("area") else None,
        "furnished": row.get("furnishingStatus"),
        "building": (row.get("location") or [{}])[-1].get("name"),
    }
要看的是 area_sqm 和 per:前者把面积单位写进字段名,后者保留租金周期。只留下一个价格数字,模型仍可能把不同口径的数据混在一起。代码也假定 externalID 存在,并取位置数组最后一级作为楼栋,接入其他数据源时需要检查这些前提。
作者通过 /search-property,使用 purpose="for-rent"、location_ids="5003"、rooms="1"、page=1 查询 Dubai Marina。25 条结果从 68,709 字符、约 17,177 tokens,降到 4,907 字符、约 1,227 tokens。首条仍能表达 Marina Diamond 4 的带家具一居室,年租 AED 70,000,面积 62.6 平方米。
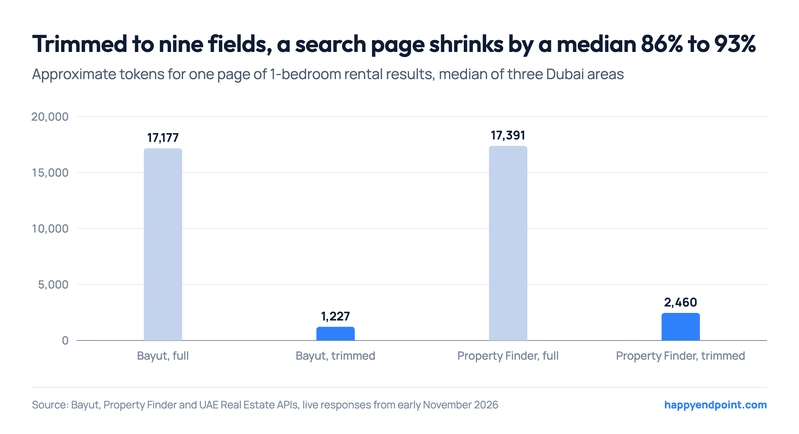
三个片区的中位数结果中,Bayut 缩减 92.9%;Property Finder 从约 17,391 降到 2,460 tokens,缩减 85.5%。后者保留了用于展示来源的长房源 URL,所以体积更大。
裁剪可以放在自有 agent 的工具调用外层;控制不了 gateway,就用一层薄 MCP server 调用 API、整理结果后再返回。关键是模型读取之前完成裁剪,读完再让模型提取字段,已经省不下输入成本。
比字段太多更危险的,是字段看起来能直接比较
作者遇到的几类数据问题,比 token 开销更容易影响答案。
首先是单位。Bayut 的 area_min、area_max 筛选参数使用平方英尺,返回的 area 却出现 62.6 这类带十四位小数的值。作者据此判断它应是平方米,原文没有给出接口文档的明确确认。Property Finder 则直接返回 {"value": 592, "unit": "sqft"}。用 area_sqm、area_sqft 能让差异显式化,但接入时仍要核实来源单位。
其次是类型和时间格式。Bayut 的 rooms 是数字,Property Finder 的 bedrooms 是字符串 "1";前者 createdAt 是秒级 Unix 时间戳,后者 listed_date 是 ISO 字符串。统一转换一次,比每次依赖模型理解更可控。
最容易污染租金判断的是混入的新盘卡片。Property Finder 三次租房搜索共返回 113 条,其中 14 条没有 price.value,12 条却有表示售价的 price.from,例如 {"from": 1000000, "down_payment_percentage": 20}。不提前排除,模型可能把百万迪拉姆售价当成租金。
位置 ID 也不能跨平台复用。Dubai Marina 在 Bayut 是 5003,在 Property Finder 是 50。传错可能照样返回结果,只是片区错了。应分别查询,或维护带平台归属的映射。
此外,Bayut 的 75 条搜索结果中,description 全是 {"en": null},需要正文时还得取完整记录。租金问题通常用不到这一步。
序列化也有成本。相同的 18 份响应,用两个空格缩进后,字符数增加了 52.4%。作者使用 separators=(",", ":") 输出紧凑 JSON;这里实测的是字符增长比例,不能直接当成所有模型的 token 增长比例。
我的判断
作者最有价值的提醒,是给工具结果定义任务边界。普通业务页面需要照片、联系人和多语言位置树,租金查询 agent 需要的是可比较的房源记录。两者直接共用响应,省了接入代码,却把成本和解释负担留给了模型。
不过,这组实验验证了数据能压缩多少,没有验证答案能准确多少。原文没有裁剪前后的回答质量、延迟、实际费用对照,也没有证明一页挂牌数据足以代表片区租金。作者虽然拉取了租赁成交记录,却没有展示如何结合挂牌价、成交价完成统计。
九字段也只适合当前任务。要展示来源,需要 URL;要分析租金分布,可能还需要去重和样本筛选。按任务保留字段是合理方向,固定套用九字段则未必合适。
发现式连接器也有取舍。单平台场景下,作者估算工具定义约 4,500 至 6,000 tokens,裁剪后每页约 1,200 至 2,600 tokens,直接接入已经可能够用。多来源场景才更能体现约 500 tokens 初始定义的优势,但额外往返会增加链路复杂度。作者维护该连接器,文末也提供相关服务;原文没有同条件性能对照,这部分应作为方案经验参考。
能拿来做什么
- 给现有 AI 查询链路增加一次响应体积检查,分别记录工具定义、原始结果和裁剪结果,先找到真正占上下文的字段。
- 在 Node 工具适配层为租金查询定义明确的返回结构,统一金额、周期、面积单位和类型,并在交给模型前排除缺少有效租金的新盘卡片。
- 前端需要展示来源时保留房源 URL,需要详细描述时再取完整记录;把每一步返回的数据控制在当前任务需要的范围内。
- 接入多个平台时,为位置 ID 标注平台归属;只有接口数量带来的固定开销确实明显时,再评估发现式工具调用的额外往返是否划算。