语音翻译应用上线遇到的跨端与体积限制
独立开发者分享用 Expo、Whisper 和 Google TTS 构建双向语音翻译应用的经验。重点问题包括共享音频格式差异、Android 临时 URI 权限、后台限制,以及音频和 base64 数据触及服务端请求体积上限。
AI 深度解读
把 WhatsApp 语音翻译成中文,只解决了听懂的问题;要继续聊天,还得把自己的回复变成对方能听懂的语音。印度独立开发者做的 ReplyLingo,把这两步串成了一个手机应用,并上架了 App Store 和 Google Play。
这篇最有参考价值的地方,是作者交代了产品落地时的具体麻烦:接收分享文件、处理上传限制、避免重复扣费,以及让用户先体验结果再付费。模型只是其中一环。
翻译语音,为什么需要两条处理链路
ReplyLingo 的入口是聊天软件的分享功能。用户在 WhatsApp、Telegram 或 iMessage 长按语音,选择分享,应用通过 iOS share sheet 或 Android share intent 接收音频。
收到的语音先转写,再翻译成用户的语言,以文字返回。回复时则多一步:用户用自己的语言录音,后端完成转写、翻译和语音合成,生成对方语言的音频,再由用户分享回聊天窗口。
它没有把整个过程自动塞进聊天软件,最后仍需要用户主动分享。
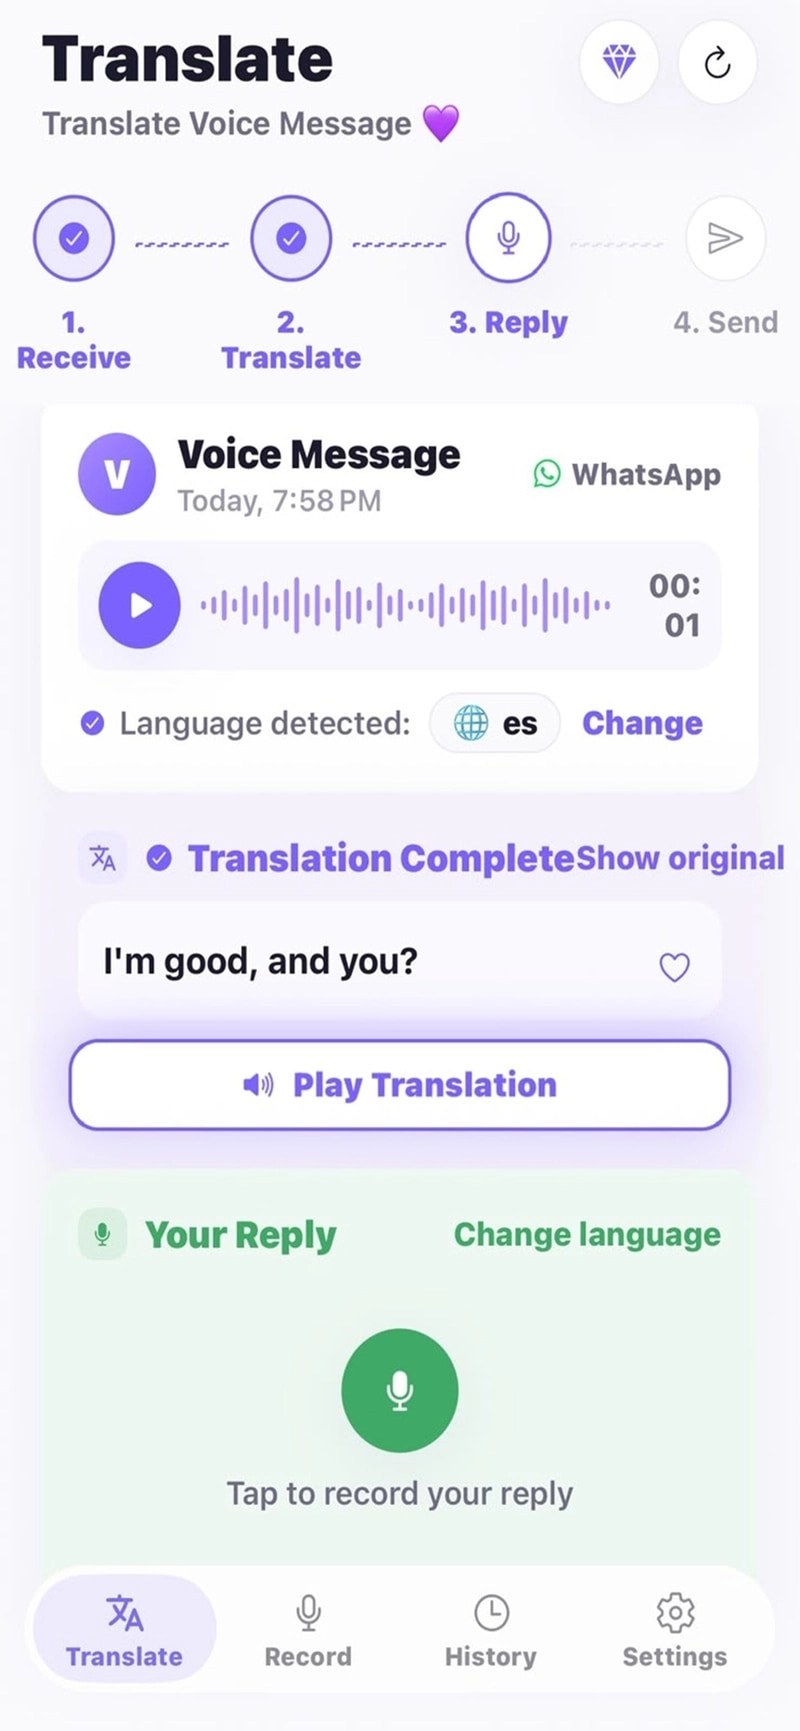
技术栈分工很清楚:客户端用 React Native 和 Expo,通过 EAS builds 构建;分享接收和原生模块需要 dev build,不能依赖 Expo Go。Firebase Authentication 提供 Google、Apple 登录及访客模式,RevenueCat 处理双端订阅。
后端是部署在 Vercel 的 Node.js,数据库用 MongoDB。OpenAI Whisper 负责转写并自动检测语言,翻译交给一个未注明具体型号的 OpenAI chat model,语音合成使用 Google Cloud TTS,在可用语言中选择 Chirp 3 HD voices。
最难的环节,为什么发生在模型调用之前
作者认为,最难的是把聊天软件分享出来的音频可靠地接进来。
Android 上,WhatsApp 会分享 .opus/.ogg 文件;iOS 又有不同格式。Android 返回的 content:// URI 可以理解为临时文件访问入口,需要在权限过期前读取。部分 Android 系统还会限制后台应用,作者特别提到了 MIUI。
因此,只验证「应用已经打开时能接收文件」不够。应用关闭时能否被唤起、能否及时读取音频,都要跨手机测试。
文件进入后端后,还有大小边界。作者遇到的 Vercel functions 请求和响应体限制约为 4.5 MB。高质量长录音可能超限,生成的长回复作为 base64 返回也可能超限。
他们采用了三种处理:降低回复录音的码率,把生成的 MP3 编码为 64 kbps mono,以及将长 TTS 文本分块合成后拼接音频。最后一项针对的是 Google TTS 单次请求的字节限制,原文没有给出具体阈值。
一次排障尤其典型:界面提示「音频太长」,实际是平台因文件体积返回 HTTP 413。失败日志应同时记录 HTTP 状态码和文件大小。 否则,文案会把排查方向带偏。
自动重试,为什么会变成重复扣费
移动网络容易中断,作者加入了带退避的自动重试。但客户端没收到结果,不代表服务端没完成处理:再次上传,可能让同一个操作扣两次积分。
解决办法是幂等性(idempotency):客户端为每个操作生成一个 idempotency key,上传时携带;服务端保存它,并建立唯一索引,让同一操作只扣费一次。
这里的关键是重试沿用同一个 key。若每次请求都重新生成,服务端仍会把它们当成不同操作。不过,原文没有展示扣费、任务状态与结果保存的实现,不能仅凭唯一索引就判断整条链路已经可靠。
语言能力也需要类似的明确边界。「100+ languages」并不代表每种语言都有合成语音。作者在后端维护统一语言列表,并下发给客户端,标明哪些支持语音回复,哪些只能文字回复,避免用户走到最后才拿到损坏的音频。
先让用户听到结果,再讨论付费
作者第一版过早展示付费墙,有时用户还没听到翻译结果。后来改成用户看过并播放结果之后再展示,作者称效果有明显改善。
他们还加入了 3 天免费试用,以及「结束前 1 天提醒」的说明,称这对 Android 用户帮助最大。但文章没有提供转化率、样本量,也没有交代提醒机制,读者只能把它当作产品经验。
获客部分同样如此。作者说,网站大部分流量来自用户向 ChatGPT 询问如何翻译 WhatsApp 语音。他们采用一页回答一个问题的事实型内容,同时配置 llms.txt 和面向 Bing 的 IndexNow,效果超过社交媒体视频。
原文没有拆分这些措施各自的贡献,不能据此认定加上 llms.txt 就能获得推荐流量。
我的判断
这套方案适合独立开发者参考:用现成服务拼出完整流程,把精力放在文件接收、失败处理和能力边界上。对前端和全栈开发者来说,这些细节比单独跑通一次 Whisper 调用更接近上线要求。
但组合服务也带来了多段网络调用。文章没有提供端到端延迟、单次成本、识别准确率或隐私处理细节,也没有与其他方案做对照。
所以,我认可这些工程问题的处理方向;至于技术栈是否最划算、付费墙调整能提高多少转化、AI 搜索能否复制,现有信息还不足以判断。它是一份落地经验记录,不能直接当作选型结论。
能拿来做什么
- 做 React Native 音频应用时,尽早用 dev build 验证真实分享入口,覆盖应用打开、关闭及不同 Android 系统的情况。
- 在 Node.js 音频接口中分别记录上传体积、返回体积和 HTTP 状态,区分平台限制、TTS 限制与业务错误。
- 给涉及积分或计费的操作分配稳定的 idempotency key,并检查网络重试是否会重复扣费。
- 把语言支持做成后端能力配置,让前端明确展示语音回复或仅文字回复,避免用一个语言总数代替实际能力。