RAG重排如何权衡精度、延迟与成本
文章介绍在初步检索与生成之间加入重排模型,改善相关证据被相似片段淹没的问题。重点讨论交叉编码器、候选池对召回的约束,以及通过独立实验衡量精度收益和额外开销。
AI 深度解读
RAG 明明搜到了相关资料,回答却还是跑偏,问题可能出在证据的排序上:真正能回答问题的片段排在后面,送进模型的却是一堆主题相近、细节不对的内容。原文讨论的 reranking,就是在检索和生成之间增加一次相关性精排。
作者的结论很克制:精排有机会改善答案,但它救不了漏检,也未必值得增加延迟和成本。对正在做知识库问答的程序员,更有价值的是一套判断方法:先找出证据在哪一步丢失,再决定是否增加模型调用。
精排解决的是「搜到了,却没交给模型」
一条典型的 RAG 流程是:接收问题,按需改写查询,执行首轮检索,收集候选片段,精排,选择上下文,最后生成答案。
首轮检索负责快速扩大覆盖范围。可以用 Elasticsearch 中的 BM25,也可以用 FAISS、Pinecone 上的向量检索,或者把关键词和向量结合成混合检索。这里的 top-k,指先取回多少个候选;精排之后的 top-n,才是实际交给 LLM 的片段数量。
两者承担不同任务。前者尽量把证据找全,后者决定有限的上下文空间应该留给谁。
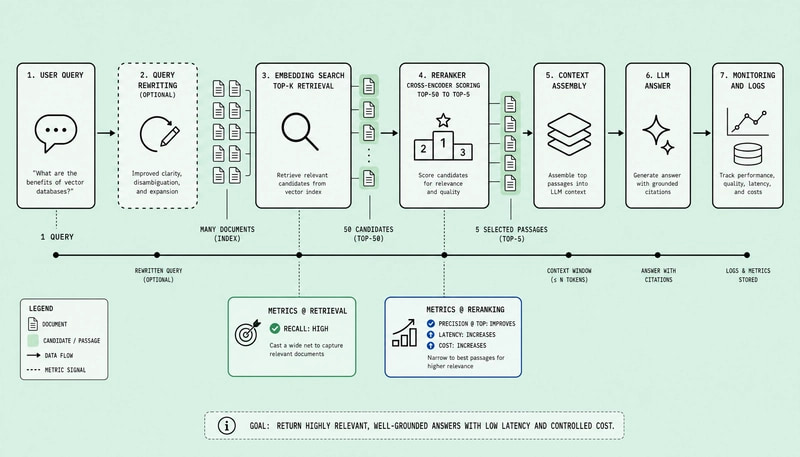
原文举的例子是:用户询问如何取消年度订阅,以及能否退款。首轮取回 top-50,里面可能同时包含取消步骤、退款政策、账单 FAQ 和升级说明。精排要依据完整问题,把能够同时回答取消和退款的片段提到前面,再选 top-5 或 top-8 进入上下文。
精排只能重排候选,不能找回候选之外的证据。
如果首轮只取 top-10,正确片段原本排在第 24 位,后面接入再强的 reranker 也看不到它。此时该检查的是查询改写、分块、元数据过滤、混合检索或候选数量。直接更换精排模型,很可能修错了位置。
为什么一起读问题和片段,比比较向量更细
常见的双编码器(bi-encoder)分别把问题和文档编码成向量,再比较相似度。文档向量可以提前计算,因此适合大规模、低延迟检索。代价是:两个文本分别压缩后,某些具体限制可能不够突出。
交叉编码器(cross-encoder)则把问题和候选片段一起输入,通过联合注意力输出相关性分数。它能在同一次计算里检查:片段有没有回应完整意图,实体是否一致,是否满足时间限制,有没有忽略否定词。
例如,用户要的是「取消订阅的步骤,不要退款政策」。向量检索可能把取消、退款、账单都判断为相关;交叉编码器更有机会识别「不要退款政策」这个限制,把操作步骤排到前面。
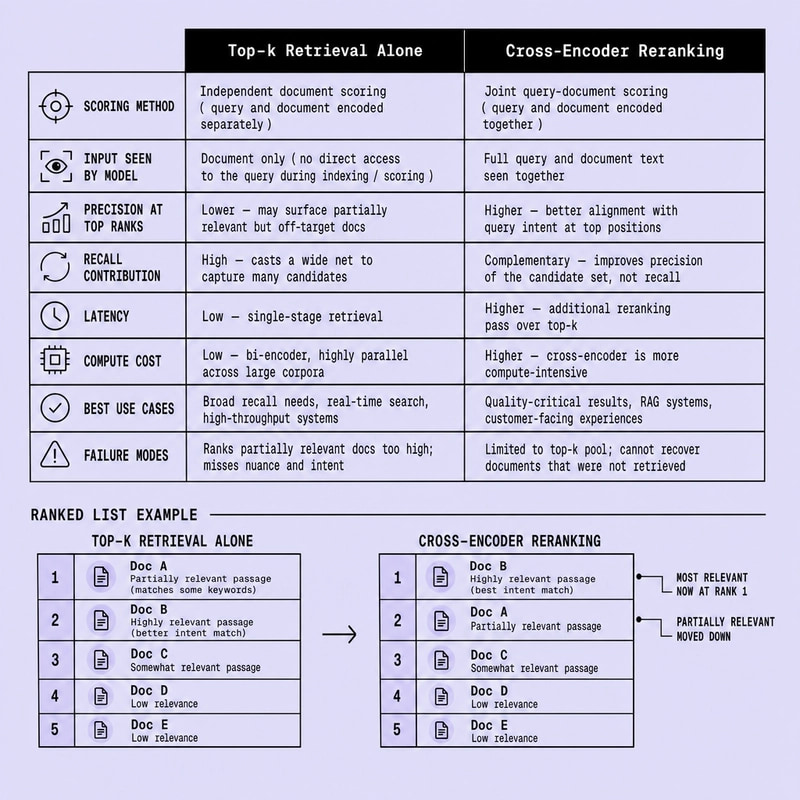
这里的收益首先发生在列表前部。假设相关证据藏在 top-50 深处,而 LLM 只读前 5 或 10 个片段,重新排序才有机会改变答案。若正确证据原本就稳定排在第 1 位,增加精排的收益自然有限。
原文建议通常按 chunk,也就是文档片段评分。生成模型最终消费的是紧凑证据,片段级评分更容易定位具体依据,也能减少无关长文占用上下文。
但更细的判断需要更多计算。候选越多、文档越长、模型越大,延迟和推理成本通常越高。因此 Cohere Rerank、SentenceTransformers cross-encoder 适合处理首轮筛出的有限候选,不适合直接逐篇扫描整个语料库。
批处理和 GPU 推理可以帮助提高吞吐;轻量模型或低流量场景也可能使用 CPU。不过,单请求测试能跑通,并不能说明高峰并发时不会成为瓶颈。
怎样证明它改善了答案,而不只是指标
原文没有给出某个模型提升多少、增加多少毫秒的实测结果,而是提出了一套评测方案。
先准备真实用户问题组成的黄金数据集,尽量同时标注两层结果:哪些片段相关,以及最终答案属于正确、部分正确、缺乏依据还是错误。只看排序指标,容易把「列表更漂亮」当成「系统更有用」。
比较时固定 LLM、prompt、生成设置和答案评估器,只改变是否加入精排。需要观察三组指标:
- 检索质量看 Precision@k、Recall@k、MRR 和 nDCG,分别关注前列结果的相关比例、证据覆盖、首个相关结果的位置,以及整体排序质量。
- 答案质量看准确性、依据充分程度、引用支持情况和人工通过率。
- 系统影响看 p95 延迟、token 数量,以及每次查询的精排成本。
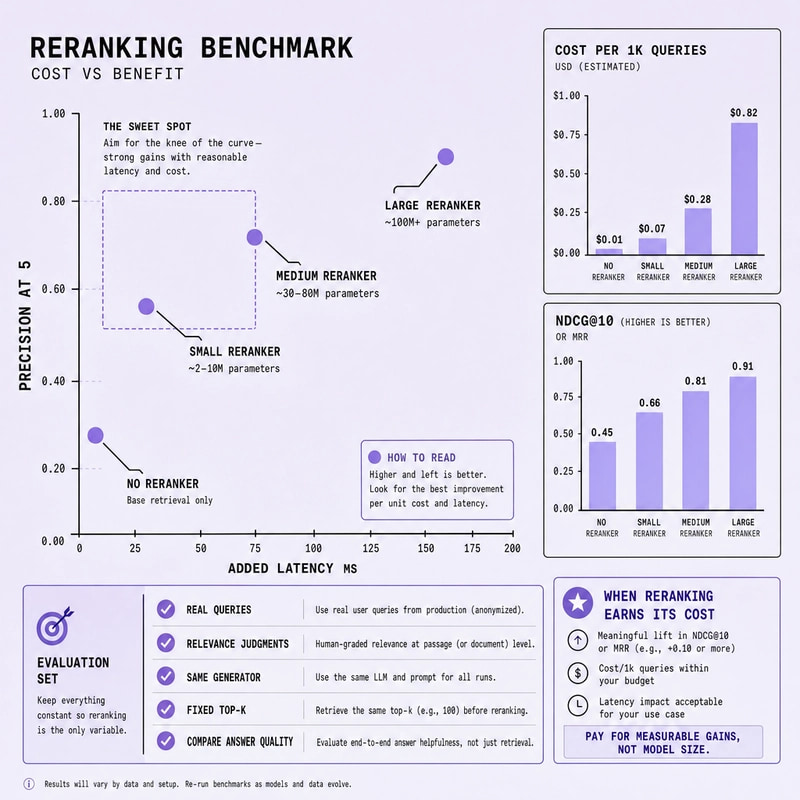
实验变量也要覆盖真实取舍:候选数量比较 top-20、top-50、top-100;进入 LLM 的片段数量比较 3、5、8;模型比较 Cohere Rerank 和 SentenceTransformers cross-encoder 的不同变体,以及 API 和自托管方式;分块则比较较小的语义块与较大的固定窗口。
其中,扩大候选池可能找回原先遗漏的证据,精排再帮助它进入最终上下文。这个过程可能改善系统的有效召回,但不能归功于「重排操作找到了新文档」。
上线门槛应提前设定:答案质量有明确提升,关键问题类型没有退化,p95 延迟增幅在预算内。离线通过后,再用影子流量或 A/B 测试确认。若 MRR、nDCG 上升,答案仍旧薄弱,就要继续检查失败案例,而不是凭排序分数上线。
我的判断
我认可作者把精排放回「可选生产依赖」的位置。它有明确的适用症状:相似但不准确的片段长期压过直接证据,混合检索结果覆盖广却顺序差,或者人工挑选上下文后答案明显改善。这些现象都指向上下文选择问题。
但原文属于方法建议,没有公开数据集、具体模型版本、硬件配置、流量规模或对照结果。因此,「交叉编码器通常更准确」可以作为实验假设,不能直接变成某个团队的收益承诺。
原文认为,小语料、重复表达、接近精确匹配的查询,往往用 BM25、混合检索或较强的向量检索就够了。这也是有前提的经验判断:知识库小,不代表版本、时间和实体约束简单;最终仍要看真实问题上的结果。
和直接增加 top-k、塞入更多上下文相比,精排提供了更有针对性的筛选,但增加了推理步骤。和改进分块、过滤、混合检索相比,它作用的位置更靠后。哪个值得先做,取决于证据是根本没被取回,还是取回后没有进入上下文。
更相关的证据可以降低无依据回答的风险,但不能保证答案正确。
原文关于幻觉的讨论也应停留在这个边界。精排改善的是输入证据,生成模型是否忠实使用证据,仍需要单独评估。
能拿来做什么
- 给现有知识库问答记录候选列表、精排顺序和最终上下文。遇到错误答案时,先确认正确证据有没有进入候选,再区分漏检、排序和生成问题。
- 在 Node 服务接入 reranker 前,用同一批真实问题比较「直接取片段」与「精排后取片段」,固定 LLM 和 prompt,同时记录答案质量、p95 延迟和每次调用成本。
- 如果正确证据经常落在候选后部,按 top-20、top-50、top-100 与最终 3、5、8 个片段开展对照,找出质量收益和延迟预算都能接受的组合。
- 如果产品 FAQ 的 top-5 已稳定包含直接依据,就先保留现有流程;只有新增问题或生产流量暴露出排序缺陷时,再重新评估精排。