生产级 RAG 如何持续同步源数据
围绕增量索引、删除标记、缓存失效和版本追踪,梳理 RAG 检索数据过期的原因与同步策略。还讨论重新生成嵌入的时机、新鲜度 SLA 及同步失败后的恢复。
AI 深度解读
RAG 服务没有报错,向量检索也能命中文档,回答却已经过期。问题可能出在同步链路:源文档更新了,索引没跟上;索引更新了,缓存还在返回旧结果;文档删了,旧切片仍然能被召回。
这篇文章的核心主张是:生产环境里的 RAG 新鲜度,需要靠变更捕获、增量索引、版本管理、删除传播和故障恢复共同保证。它没有给出性能实测,但梳理出了一套实用的工程检查框架,适合用来排查「知识库明明更新了,AI 为什么还在答旧内容」。
数据有没有更新,要从用户能否检索到算起
RAG 的数据通常分散在几个地方:业务数据库、文档平台、切片存储、向量数据库、元数据索引和缓存。它们更新的时间不同,任何一环落后,都可能让用户拿到旧答案。
作者把常见原因分成三类。
第一类是变更没及时进来。轮询间隔太长,webhook 静默失败,或者 CDC(变更数据捕获)积压。只监控每分钟处理多少文档,很容易误判系统健康,因为处理量无法说明最新修改是否已经可用。
第二类是删除没有传到底。例如 Confluence 页面已经删除,但旧 chunk ID 仍被缓存引用,元数据也没有标记失效,检索就还能找到它。
第三类是处理规则变了。即使原文没有修改,切片规则、解析逻辑或 embedding model 升级,也可能让已有向量与当前检索方式不再匹配。
新鲜度的终点,是源数据的变化已经体现在用户可检索的结果中。
因此,作者建议用 freshness SLA 约束「源数据变化到可检索」的最大延迟,并按来源和业务重要性分别设定。原文认为政策、价格等高风险内容往往需要分钟级,低频变化的归档可以接受小时级或天级;这些是建议窗口,没有附带实验依据。
监控也要覆盖结果:除了 freshness lag、同步成功率,还应观察过期命中率、删除传播延迟、缓存失效成功率,以及由最新文档版本支撑的回答占比。
CDC、webhook 和轮询,该怎么搭配
作者建议优先使用数据源能支持的事件机制。
对于业务数据库,CDC 从数据库日志捕获行级新增、修改和删除。例如通过 Debezium 把变更送入 Kafka 或其他消息队列,再驱动增量索引。它适合变化频繁、新鲜度要求较高的数据,但也需要维护日志消费和消息处理链路。
对于 Confluence、Salesforce 或工单平台,webhook 更容易接入。不过,通知可能只带部分字段,也可能重复、乱序。作者建议收到事件后重新读取源系统中的权威状态,附带幂等键,再结合 source ID、checksum 和更新时间判断是否写入。幂等的意思是,同一事件重复处理,也不会多生成一批向量。
轮询适合变更少、事件接口不可靠或根本不存在的来源。按夜间或固定间隔扫描,再用 checksum 比较内容,可能已经够用。数据条目很多、编辑频繁时,轮询成本和延迟才会明显暴露。
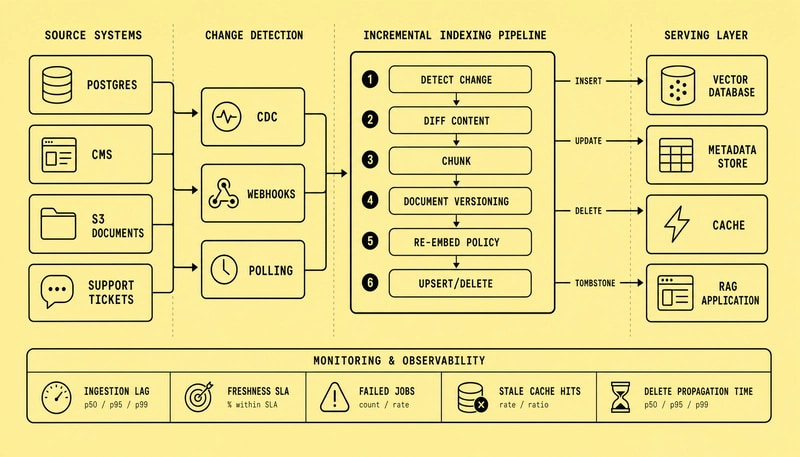
实际系统可以混用:webhook 负责及时触发,选择性轮询负责核实最新状态;事务数据走 CDC,文件存储走轮询。
这里最重要的是约定好同步行为:事件重复怎么办,旧事件晚到怎么办,失败从哪里继续,漏掉的变更如何补齐。作者要求消费者具备幂等性,并监控重试深度、死信数量和故障恢复时间。事件乱序可以拖慢更新,但不能让旧版本覆盖新版本。
增量更新和删除,都需要可追踪的版本
「只更新变化的切片」听起来简单,前提是系统知道哪些向量属于哪个文档版本。
原文建议至少保存这些元数据:document_id、source_id、chunk_id、parent_document_version、source_timestamp、checksum、content_hash、embedding_model_version,以及删除标记或 tombstone。前文还要求记录 chunk schema version;如果编辑导致切片重新排列,则增加 previous_chunk_id 或父子沿袭字段。
这些字段分别回答:内容来自哪里、属于哪个版本、是否改变、用什么模型生成向量,以及它替换了哪个旧切片。缺少这层关系,增量更新容易留下重复切片、孤立向量,或者让一次检索混入新旧版本。
作者给出的更新规则可以整理成四档:
- ACL、标签、标题、所有者或时间戳变化,而正文
content_hash未变时,只更新元数据。 - 文本在现有切片边界内变化,切片数量稳定时,只重新嵌入 checksum 改变的切片。
- 标题层级、表格、顺序或章节长度变化,导致旧切片边界失效时,重新切片并嵌入。
- embedding model、解析逻辑变化,或旧切片沿袭关系不可信时,进行整版切换。
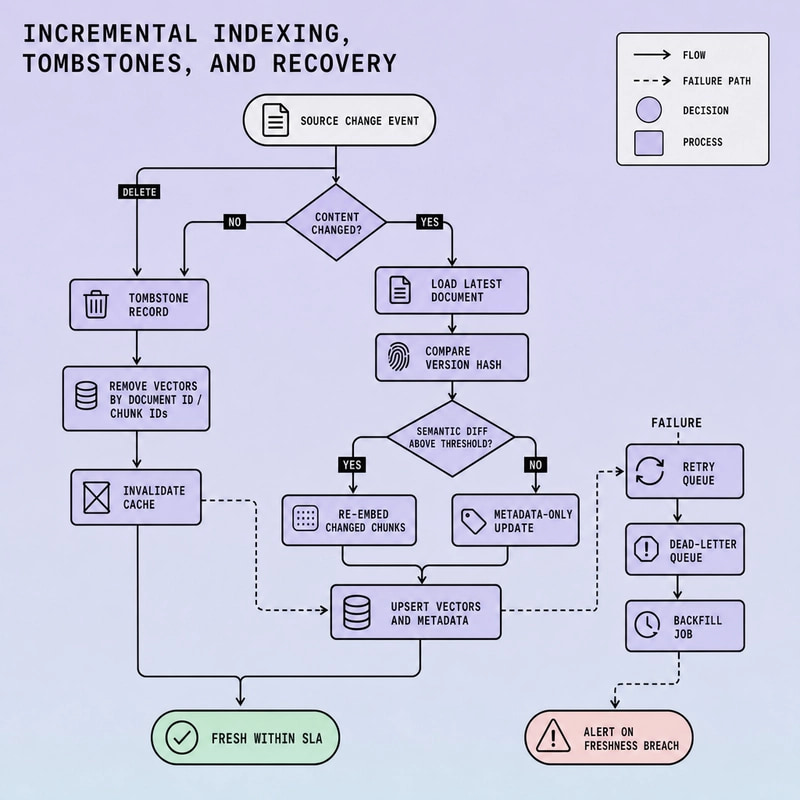
删除则要多走一步。作者建议先写 tombstone(墓碑标记),携带来源、切片 ID、删除时间和版本信息,让下游先屏蔽内容,再延迟清理实体数据。
删除完成的标准,是旧内容已经无法通过检索和缓存返回。
所以,删除还必须触发检索缓存、reranker 特征缓存和答案缓存失效。作者提出版本感知读取:在快速元数据存储中保存最新版本或删除状态,缓存结果中的版本对不上,就拒绝使用。
故障恢复同样依赖版本。事件接收、切片、embedding、upsert 和墓碑应用各阶段保存持久化检查点;失败后从已提交位置恢复;反复失败的消息进入死信队列;缺失部分按 source ID、版本或时间范围回填。同步恢复后,还要与源系统对账,不能只看队列是否消费完。
我的判断
我认同文章把新鲜度看作完整的数据同步问题。对于已经接入多个来源、存在多层缓存的 RAG,这比单纯提高全量重建频率更有针对性。作者强调最终一致性必须配合明确 SLA、事件重放和对账,也很实际:允许短暂落后,需要有办法确认落后范围,并确定性地追上。
但这篇是经验框架。原文没有提供数据规模、更新频率、成本、延迟分位数,也没有展示全量重建与增量同步的对照结果。它提出「全量重建通常太慢、太贵」,不能据此断言小型知识库也必须搭建 CDC 和消息队列。低频更新、允许隔夜生效的资料库,定时重建仍可能更省维护成本。
还有两个实现前提需要补上。
一是「标题变化只改元数据」。这只有在标题未参与 embedding 输入时才成立。如果切片文本带着文档标题,标题修改就可能改变向量输入。原文把标题列入元数据更新,但没有展开这个条件。
二是版本字段不会自动带来一致性。文章提到读取过滤、upsert 和整版切换,却没说明多个切片如何一起发布,以及更新中途查询应看到哪个版本。它也提到了语义差异阈值,却没有给出算法和阈值。真正落地时,这些仍要由团队根据检索方式和业务要求决定。
能拿来做什么
- 给现有知识库补一条端到端测量链路,记录源文档修改、索引可查和缓存更新的时间,并实际查询验证,找出延迟集中在哪一段。
- 在 Node 同步任务中加入稳定文档 ID、版本、内容哈希和 embedding model 版本,用这些字段决定更新范围,并阻止重复事件和旧事件破坏索引。
- 为内部 AI 助手做一次删除演练:删除源文档后,检查旧切片、检索缓存和答案缓存是否仍能返回内容,再验证失败重试后的状态。
- 根据数据源选择同步方式。低频文档先用定时扫描和 checksum 比较;已有 webhook 就增加状态核实与补漏;高频数据库再评估 CDC,同时明确可接受的延迟和恢复流程。