Agent任务成本不能只看Token单价
作者通过Amazon Bedrock与AgentCore演示,讨论模型调用消耗、Agent执行成本和架构选择。示例显示同一句输入在不同模型中的Token计数也会变化,单次调用不足以代表完整任务成本。
AI 深度解读
一次 Agent 任务花多少钱,不能只看模型的 token 单价。作者用两组 Amazon Bedrock 演示说明:同一句提示词,换模型版本后输入计数可能变化;一个用户请求进入工具循环后,又可能累积成多次推理,外加运行环境和会话的费用。
更有用的结论是:应该比较「解决一项任务的总成本」。这篇的价值在于拆开账单,同时标清哪些是演示记录、哪些是估算,以及哪些省钱办法还没有经过验证。
同一句提示词,为什么换版本就要重新算账
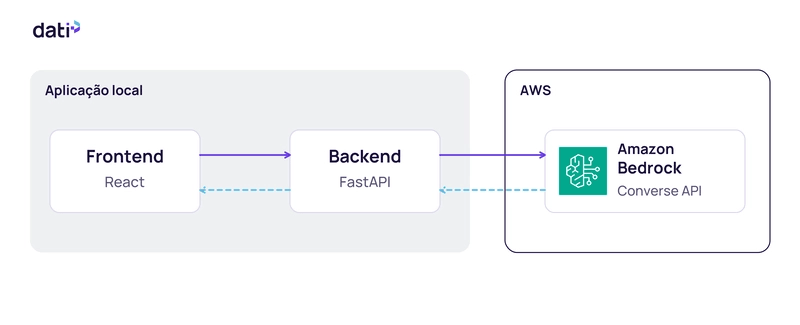
第一组演示没有工具调用,也没有 Agent 循环,只通过 Amazon Bedrock 的 Converse API 提问:用 3 个简短要点解释 RAG(Retrieval-Augmented Generation,检索增强生成)。
作者记录的输入用量分别是:Claude Sonnet 4.6 为 32 tokens,Sonnet 5 为 40,Sonnet 5.5 为 42;比较范围内,从 GPT-5.4 到 GPT-6.1 Sol 都是 26。
即使输入单价不变,计费数量增加,这部分费用也会上升。但这组数据只描述了特定句子、特定调用的输入量,既不能推出完整回答的成本,也不能证明哪个系列始终更省。
原因同样不能猜。原文指出,Sonnet 5.5 的文档称其与 Sonnet 5 使用相同 tokenizer,因此 40 到 42 的变化不能直接归因于分词器。记录没有隔离提示词的全部内部表示,差异来源仍未解释。
提前估算也有限制。CountTokens 只支持部分模型和格式,原文所查的 GPT-5.4、GPT-6.1 Sol 资料均标为不支持,无法靠它完整复现这张比较表。
所以,升级评估要同时记录模型 ID、endpoint、payload、配置、输入输出和适用费率。界面配置为 us-east-1,也不能证明推理实际发生在那里;原文提到的 GPT-6.1 Sol 配置可能涉及 cross-region 路由。
用户只问一次,模型为什么收了五轮输入
第二组演示让 Agent 完成一项 FinOps 任务:找出上个月最贵的 AWS 服务,查看此前两周的每日成本,分析趋势、生成 forecast、查询 budgets,最后在五行内给出结论。
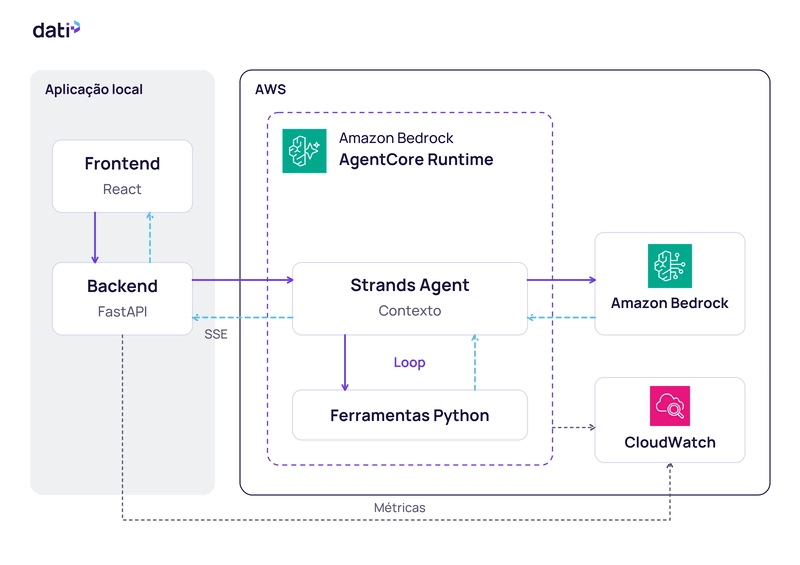
这些步骤有依赖。先知道哪个服务最贵,才能查询它的每日明细。模型选择工具,代码执行工具,结果回到上下文,模型再决定下一步。这就是 Agent 循环。
演示使用 Strands Agents:Agent 组织循环,tools 执行操作,BedrockModel 配置模型访问;Amazon Bedrock 提供推理,Bedrock AgentCore Runtime 托管应用,事件通过 SSE 返回界面。参考 Agent 的工具使用模拟数据,不能把它当作真实账单系统的效果验证。
标识为 GPT-6.1 Sol、模型 ID 为 us.openai.gpt-6.1-sol 的记录里,一项任务触发了五次模型调用。第一轮输入是 1,332 tokens,最后一轮是 4,553,累计达到 16,223。
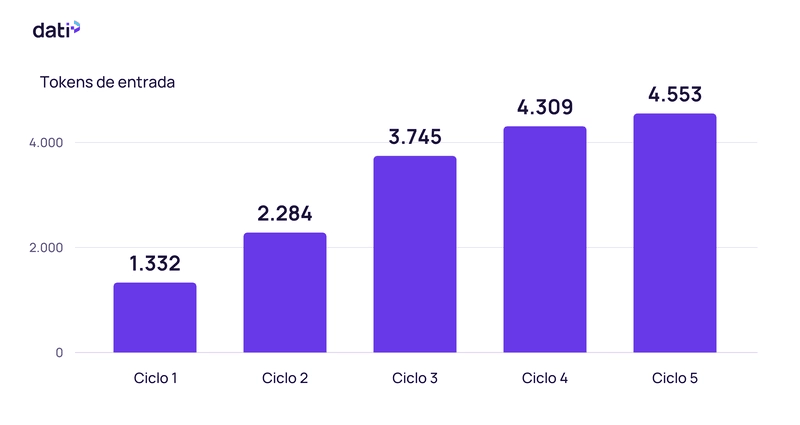
这里有两个容易算错的地方:只看第一轮,会漏掉后续消耗;把累计 16,223 再乘五,则会重复计算。要求最终只写五行,也限制不了此前生成的工具调用内容。
工具返回的数据,会影响后续多轮调用的成本。
作者因此提出两种优化假设:工具只返回下一步决策需要的字段,完整结果另存以供审计;确定性的聚合计算交给代码,避免模型反复重建。工具的描述和 schema 本身也占输入空间,不能忽略。
但原文没有证明这些调整能节省多少。删掉字段可能同时删掉识别异常的证据,必须用相同正确性标准比较完整流程。
缓存和运行环境,为什么不能揉成一个数字
上下文重复,不代表一定命中缓存。Bedrock 的 prompt caching 支持范围和条件随模型、API 而变,读取有单独费率,写入也可能比普通输入更贵。启用功能之后,仍要查看实际用量字段。
还要确认界面的计数口径:如果「来自缓存」的数量已经包含在输入里,再加一次就会高估。作者没有确认演示界面与 API 字段的完整映射,因此不能直接套公式。
合理的计算方式,是把普通输入、缓存读取、缓存写入和输出分成互不重叠的类别,分别应用费率,再累计所有调用。
Runtime 是另一笔账。应用调用模型时付推理费用,运行协调代码和工具时还会消耗计算资源。
原文讨论的 AgentCore Runtime microVM v1 中,CPU 按实际使用计量,内存则随占用时间累计。等待模型返回时,如果没有进程使用 CPU,等待时长就不等于同样时长的 vCPU 消耗;内存却可能继续收费。回答结束,也未必代表会话立即结束。
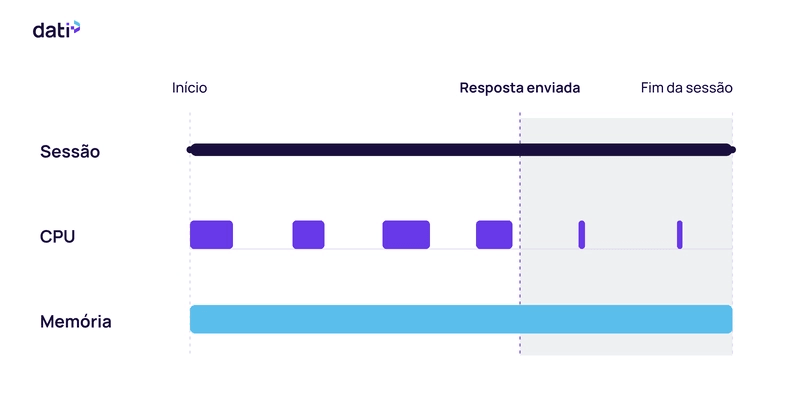
演示计算器采用了 900 秒空闲时间、约 1 GB 内存占用、空闲 CPU 为 1% vCPU 等假设。这些是估算条件,没有与实际账单核对。
缩短 timeout 可能减少空闲期间的内存费用,也可能增加重新启动会话的次数。多次交互共用会话时,费用如何分摊到任务也会变化。AgentCore Gateway、Memory 则按实际使用情况加入,工具循环本身不要求必须启用它们。
我的判断
作者最有说服力的地方,是把比较单位从「一次回答」推进到「完成一项工作」。便宜的调用如果经常失败或重试,未必能带来更低的任务成本。
但这不是模型性价比排行榜。作者明确说,没有为本文重新运行实验,也没有做模型间等价的质量评估。单次执行不足以给质量排序;工具裁剪、代码聚合和缩短会话的收益,目前也只是待验证的假设。
演示本身就说明了为什么要先定义成功:forecast 返回的时间窗口与要求不同,budgets 查询为空,最终回答承认了这些限制。识别并报告数据缺口,应该进入验收标准,不能只看它有没有写出一段流畅结论。
和固定工作流相比,Agent 适合由中间结果决定下一步的任务;但这项 FinOps 工作也包含确定性的查询与计算,值得比较由代码固定编排、模型负责解释的方案。原文没有对照数据,无法断言哪种更便宜。
Batch 可以考虑用于允许等待的离线分析,却不能直接替代这个交互流程中逐步依赖结果的调用。service tiers 的价格与处理方式,也要按模型核实。
更可靠的指标,是总评估成本除以按标准解决的任务数。
分子要包括失败尝试,还应覆盖推理、Runtime、工具所调用的服务、可观测性等实际资源;旁边同时展示解决率和端到端延迟。最后用 Cost Explorer 和成本报告核对收费,避免把遥测估算当成账单。
能拿来做什么
- 给 Node Agent 增加逐轮记录,保存模型 ID、工具调用、输入输出用量、缓存字段和耗时。前端可以通过 SSE 展示过程,让一次请求背后的调用次数可见。
- 检查工具返回的 JSON 是否携带了后续决策用不到的字段。先保留完整结果供审计,再测试精简返回是否影响异常识别,每次只改一个因素。
- 升级模型时,用相同 payload 和配置重跑代表性任务,并覆盖空数据、时间范围错误、工具失败和 retries。比较完整任务的成本、正确性与延迟。
- 对托管在 Runtime 的应用分别观察 CPU、内存和会话寿命。调整 timeout 前先确认会话复用方式,再用实际成本报告验证收益。