从提示注入到工具越权的防护实践
文章以客服助手泄露数据的场景说明,外部网页中的指令如何诱导模型滥用工具。防护重点包括信任边界、输出检查和最小权限工具白名单,并提供相关代码示例。
AI 深度解读
一个客服机器人读了用户发来的网页,随后把另一位客户的姓名、邮箱和订单记录贴进对话。攻击者没有拿到数据库密码,只是在网页里藏了一句指令。原文用这个假设场景说明:当 LLM 同时能读外部内容、调用内部工具时,普通文本就可能借用用户权限做事。
作者的结论是,把防线放到模型周围:限制它能调用的工具,检查输出,对高影响操作要求人工确认。这篇适合正在做 RAG、客服助手和工具型 Agent 的程序员阅读,但其中的代码只是示意,不能直接当作完整安全方案。
为什么读一张网页,也可能变成越权操作
原文把 LLM 比作「受骗的代理人」(confused deputy):它拥有你授予的权限,却可能被没有权限的人诱导,替对方办事。
开头的客服场景中,攻击指令藏在网页的白底白字里,要求机器人进入调试模式,查询最新工单并输出客户资料。网页只是数据来源,却开始指挥数据库查询。真正危险的环节,是外部内容影响了一个拥有内部权限的执行者。
作者区分了两类提示词注入(prompt injection):
- 直接注入:攻击者在自己的消息里输入「忽略之前的指令」等内容,尝试改变模型行为。
- 间接注入:攻击者把指令放进网页、PDF、邮件、产品评价或日历邀请,等待别人的助手读取。
后者更隐蔽。攻击者不需要进入受害者的对话,只需要控制助手即将读取的一段内容。助手随后可能带着受害者的权限执行攻击指令。
原文用 SQL 注入作类比:数据被当成命令执行,就会出问题。LLM 的难点在于,系统提示词、用户消息、检索文档和工具返回值都会进入上下文,单靠自然语言约定,无法建立可靠的权限边界。
这里也要纠正原文的一处绝对化表述。模型并非必然服从最后读到的文字,也并非完全不区分指令层级。工程上需要接受的事实是:这种区分不能成为足以托付安全的保证。
应该按模型可能被诱导的前提设计权限。
防线应该放在哪些边界上
作者建议先画数据流,再逐个守住边界:哪些内容进入上下文,哪些结果离开模型,哪些工具能产生实际副作用。
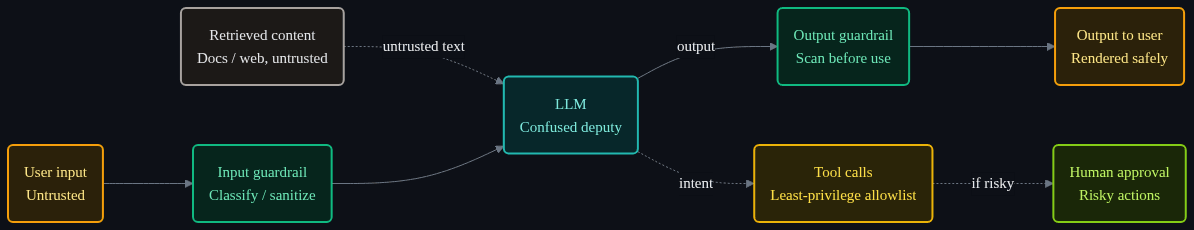
输入端包括用户文本、RAG 检索片段、网页、文件和工具结果。它们都应视为不可信数据。规则或分类器可以提前标记明显的攻击指令和个人身份信息(PII),但作者也承认,这只是减速带,挡不住所有攻击。
把检索内容放进明确的分隔区域,并要求模型只把它当资料,有一定帮助。不过,这仍然属于提示词层面的约束。攻击者一旦绕过它,后续权限检查仍要成立。
工具端要先缩小能力。摘要助手不需要写权限,查询订单不需要管理整个工单数据库。默认只读,再为确有必要的功能增加窄范围权限。付款、删除、对外发送邮件等操作,需要明确的人工确认。
输出端则回到熟悉的 Web 安全原则:模型返回的内容也要当作用户输入处理。进入页面时安全渲染,进入 SQL 时参数化,不能直接拼进 shell 命令。否则,提示词注入还可能继续演变成 XSS 或命令注入。
如果允许模型运行代码,作者要求使用隔离、限制网络且没有生产凭据的沙箱。API key 和其他用户的数据,也应尽量不进入上下文。输出过滤可以补漏,但无法替代源头上的数据隔离。
这段工具白名单代码,解决了什么
原文给出一份 Python 示例,包含输出扫描和工具调度。输出扫描会拦截疑似密钥,并把匹配到的邮箱、美国 SSN 格式替换成 [redacted]。
它使用的密钥规则包括 sk-[A-Za-z0-9]{20,}、AKIA[0-9A-Z]{16},以及私钥头标记。这些规则只能识别特定形状,无法覆盖所有凭据,更识别不了所有经过拆分、改写的信息泄露。
更值得看的是工具调度部分:它把拒绝未知工具、检查 scope、请求人工批准,放进普通程序代码执行。
ALLOWED_TOOLS = {
    "get_order_status": {"scopes": {"orders:read"}, "requires_human": False},
    "issue_refund":     {"scopes": {"orders:write"}, "requires_human": True},
}

def dispatch_tool(name: str, args: dict, granted_scopes: set[str], approve):
    spec = ALLOWED_TOOLS.get(name)
    if spec is None:
        raise GuardrailError(f"tool not allowed: {name}")          # default deny
    if not spec["scopes"] <= granted_scopes:
        raise GuardrailError(f"missing scope for {name}")           # least privilege
    if spec["requires_human"] and not approve(name, args):
        raise GuardrailError(f"human approval denied for {name}")   # human-in-the-loop
    return TOOL_IMPLS[name](**args)
重点看 spec["scopes"] <= granted_scopes:检查的是工具要求的权限是否全部包含在已授予权限中。requires_human 则决定执行前是否需要批准。模型即使请求调用退款工具,也不能自行跳过这两道检查。
但示例没有展示 GuardrailError、TOOL_IMPLS 和 approve 的完整实现,授权来源也没有交代。照抄这段代码,并不等于获得完整防护。
尤其是 orders:read 只表达「能读订单」,没有回答「能读谁的订单」。开头那种跨客户泄露,还需要后端根据当前身份检查具体资源的归属。工具名合法、scope 足够,都不能自动证明传入的订单号合法。
我的判断
我认同作者把重点放在权限和执行边界上。对于接入工具的应用,权限越宽,一次模型误判可能造成的后果就越大。相比继续堆叠「永远不要泄露」之类提示词,收窄工具能力、执行资源授权,更容易形成可检查的约束。
不过,原文没有提供实测攻击成功率,也没有比较提示词隔离、分类器、正则过滤和不同授权方案的效果。「这些措施最划算」属于作者的工程经验,不能当成经过对照实验的结论。
标题提到 OWASP LLM Top 10,正文还声称其中四类风险造成工具型应用中绝大多数真实事故,但提供的内容没有展开完整的四项清单,也没有事故统计或版本信息。读者可以把它当作威胁建模入门,不能据此判断风险排名。
原文还建议记录完整提示词、工具调用和输出,方便排查与红队测试。这个方向有用,但完整日志也可能复制敏感数据。实际落地时需要决定脱敏、访问权限和保留范围,原文没有展开。
人工审批同样有前提。用户必须看清具体动作、目标和关键参数,才能有效确认。若界面只显示一个「是否继续」,很容易把审批变成机械点击。
模型可以提出动作,是否执行应由应用侧授权逻辑决定。
能拿来做什么
- 给现有 RAG 或客服助手列一份输入与输出清单,覆盖检索文档、网页、工具结果、页面展示和外发渠道,检查每条路径是否存在把资料当指令执行的机会。
- 在 Node 工具调度层实现默认拒绝的白名单,并同时校验参数、当前用户权限和资源归属;不要让模型传入的用户 ID 或订单 ID 直接决定可访问对象。
- 检查前端如何展示模型结果,重点排查原始 HTML 渲染,以及模型内容继续进入 SQL、shell 或其他执行接口的路径。
- 为删除、退款和对外发送设计包含具体目标与参数的确认界面,再用文档中藏指令的间接注入样例验证:即使模型接受了指令,后端也应拒绝越权执行。