浏览器智能体如何压缩上下文又保真
Pilotfish 的工程文章讨论页面序列化、差分更新和操作批处理,强调保留表格行内关系,并以模型实际收到的页面为差分基线。文章还指出,网络和 DOM 静止并不代表业务数据已经就绪。
AI 深度解读
浏览器 Agent 最危险的失误,可能是把一个仍在刷新的余额,干净利落地交给用户。Pilotfish 作者讨论的不是怎样让模型更快点击,而是怎样在减少页面文本和模型往返时,保证模型知道自己看到了什么、哪些状态还不能信。
这篇工程解读的核心判断是:压缩、增量返回和批量操作都可以做,但必须先守住观察与执行的协议。对正在用 MCP、Node 或 TypeScript 开发浏览器自动化的程序员,这比单看 token 降幅更值得研究。
页面可以压缩,但不能压掉金额属于谁
作者用一个虚构的应收账款网站解释问题:Agent 打开账单,网络没有动静,DOM 也停止变化,页面显示余额 $8,400,上方却挂着「Refreshing balances」。
此时,更快返回 $8,400 并不是有效优化。真正要优化的是重复文本和模型调用,同时保留判断余额是否可信的依据。文中的客户、账单和金额都是示例,并非真实业务记录。
页面序列化,就是把浏览器页面转换成模型可读的文本。它可以去掉生成的 CSS 类名,但必须保留账单与余额的对应关系:
Customer | Invoice | Outstanding
Acme Fasteners | [e5]INV-1042 | $8,400.00
这里要看的是第二行:[e5] 保留链接的操作引用,账单和金额仍在同一行。文本变短以后,模型依然知道钱属于哪张账单。
Pilotfish 的普通表格行表示会保留单元格顺序和链接引用。但遇到表单控件、有状态的单元格、嵌套表格,可以回到常规表示。作者没有主张把所有表格一律拍平成文本。
只返回视口内的内容也有类似前提:必须说明省略了什么,以及如何继续读取。屏幕外可能正好有任务需要的按钮,因此精简观察还要配套完整读取入口。
压缩是否成立,要看任务关系有没有保住,而不只是字符数有没有下降。
增量更新必须从调用方收到的页面算起
输入客户名,通常只会改变输入框和少量候选项。每次重新发送整张账单表显然浪费,于是可以返回差异,也就是 diff。
但服务端捕获过页面,不代表调用方收到过页面。
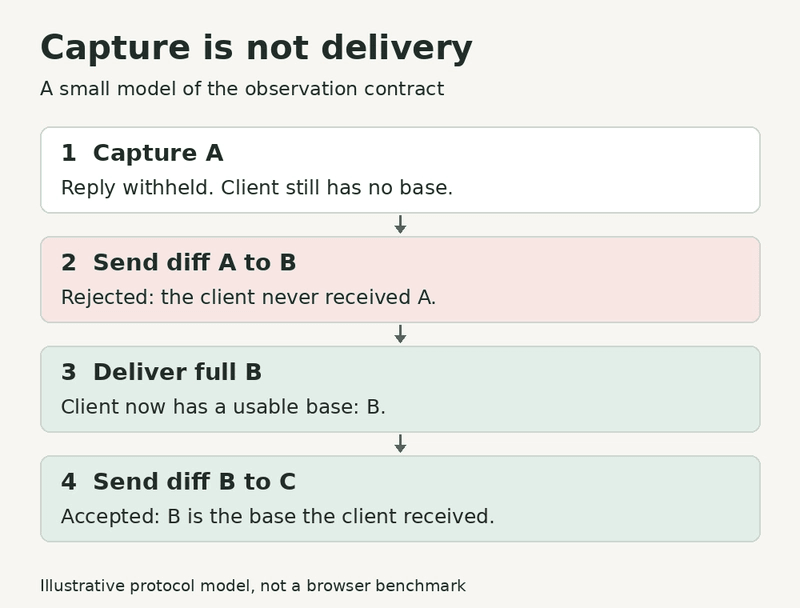
这张图是协议示意,不是 Pilotfish 实际运行录像。服务端先捕获 A,却没有交付;随后页面变成 B。如果直接发送 A 到 B 的差异,调用方根本没有 A,无法还原 B。正确恢复方式是完整发送 B,再以已交付的 B 为基准生成后续差异。
文中的实现约定是:完整观察交付后,才提交为差异基准;未交付的回复不能建立基准。
作者还给出一个只使用 Node 内置断言的协议模型。保存为 delivered-base.mjs,运行 node delivered-base.mjs,无需浏览器、账号、API key 或模型调用。模型中 A、B、C 的余额分别为 8400、5150、5000,用来验证未交付 A 后,完整 B 能恢复状态,接着 B 到 C 的差异才能成功。
关键故障也很明确:把未交付分支改成 if (withheld) { delivered = page; return null; },服务端就会错误提交基准,随后触发 unknown diff base。
这只是同步交付的小模型,不是 Pilotfish 实现或集成测试。真实传输仍要处理丢失回复、确认和重置。
差异还必须保留页面顺序。两张账单互换金额,不能因为文本行集合相同就被视为没变化。Pilotfish 描述的有序差异会保留周边上下文、记录替换行数,并列出被移除的交互引用。文档变化、基准过旧,或差异太大、存在歧义时,重新发送完整观察就是协议的一部分。
页面安静了,不代表可以继续操作
回到账单示例:部分付款已经到账,余额面板却还没更新。仅靠全页网络空闲,很难判断当前数值是否可用。
分析请求和轮询可能让正常页面一直繁忙;网络已经安静的页面,也可能仍显示加载中的余额。Pilotfish 的自适应等待步骤会跟踪当前动作触发的工作,而不是等待所有流量停止。写请求尤其需要关注,因为请求没有得到回应,不能当作写入已被接受。
此外,还有独立的加载指示器选项,最多等待六秒,检查 aria-busy、不确定进度条等信号。如果它们仍存在,回复就要保留这个状态。加载信号也可能缺失或误导,因此这些检查不能证明网站一定正确。
余额确认变成 $5,150 后,示例流程允许起草提醒,等待人工审核。收件人、主题、正文和内部备注都已确定,可以由一次模型决策安排多次填写。但浏览器动作仍按顺序执行,每一步之后仍然检查,最后停在 Send 之前。
如果第一步之后邮箱校验还在转,就停止后续动作。
批量执行器还会因失败、导航、对话框、新标签页、写请求被拒绝或未获回应、加载,以及登录或检查状态而停止。一个容易误解的细节是:在该实现中,字段无效会被报告,但它本身不是停止条件。调用方不能自行假设所有校验问题都会中断批次。
作者因此要求先测难处理的情况:交换两行金额、扣住完整回复、留下加载指示器、让写请求无回应,以及在批次中触发校验。之后再衡量整个任务,把恢复读取和失败成本一起算进去。一次极短的回复,如果马上迫使模型再调用一次,未必更省。
我的判断
我认同这篇文章把正确性放在协议层处理。模型能力再强,也无法可靠应用一份缺少基准的差异;页面状态没有被观察到,也不能指望模型猜出余额还在刷新。
相比每次发送完整页面,增量观察能减少重复,但增加了基准同步和恢复的复杂度。相比每个动作都让模型重新判断,批量填写能减少往返,但要求后续输入已经确定,并且执行器具备明确的停止条件。对短流程、低调用量的内部工具,完整观察和逐步执行仍可能更容易维护。
至于效果,原文提供的是一次项目方运行的整体系统比较。2026 年 11 月 11 日,Pilotfish open MCP 0.1.39 与 Playwright MCP 0.0.84 分别运行同一组 WebVoyager 任务。双方配对排除任一工具遇到站点阻断的 24 对任务,再排除存在回合前错误的 5 对,最终相同的 71 个任务中,正确完成数分别为 65 和 61。计数与中位数按公开结果行重新计算,中位数也使用同一任务集合。
这个结果有参考价值,但不能扩写成准确率优势已经得到证明。两组均由 GPT-6 Luna 驱动和评判,在印度同一台 Windows 机器上运行,并发五个任务;它不是独立验证,也没有测试托管服务。排除后的结果只描述符合条件的尝试,不能代表整体成功率或站点访问覆盖。
原文没有拆分各项机制的对照数据,无法据此判断某一种优化单独贡献了多少收益。
实现与基准链接固定到 commit b990f0f。另外那段 62 秒 LinkedIn 视频只是产品说明,也不是虚构账单任务的运行证据。
能拿来做什么
- 开发 Node 浏览器工具时,先复现基准丢失问题。用
node delivered-base.mjs理解交付与捕获的区别,再在真实传输中验证回复丢失和页面重置,确保恢复后调用方能重新获得完整页面。 - 给前端后台页面接入 Agent 时,把加载状态做成可观察信号,例如
aria-busy。测试时让网络结束后加载提示继续存在,检查 Agent 是否仍把余额视为暂定值;同时明确写请求无回应时的处理方式。 - 设计填写批次时,只合并已经确定的输入,并逐项约定停止条件。尤其要区分校验仍在进行、字段已经无效和导航发生变化,不能只用一个「填写失败」覆盖所有情况。
- 想试用本地浏览器接入,可以选择 open MCP;它要求 Node.js 22+ 和 Chrome 或 Chromium。在 Claude Code 中,文档给出的注册命令如下。直接从 TypeScript 调用则使用
@gaiventures/pilotfish,初次实验先放在可丢弃的本地页面上。
claude mcp add pilotfish -- npx -y @gaiventures/pilotfish-mcp
这行命令注册的是 @gaiventures/pilotfish-mcp,需要留意它对应 open MCP;它不是 TypeScript SDK,也不是托管中继。