模型路由免部署切换,生产验证如何补齐
Vercel AI Gateway 的虚拟模型 ID 支持集中调整模型、供应商与回退链,无需重新部署应用。文章建议明确回退条件、记录实际响应模型,并用固定模型和小型评测验证路由变更。
AI 深度解读
Vercel AI Gateway 的 virtual model ID,让应用始终请求同一个名字,背后的供应商、模型和回退链都能在控制台切换,不必重新部署。方便之外,生产行为也可能在没有 PR、代码差异和测试的情况下改变。
原文给出的结论是:把虚拟模型当成一份需要维护的契约,用明确的回退规则、真实响应模型的追踪记录,以及固定模型的对照评测,补上切换过程中的检查。这套思路值得看,但文中的示例离生产门禁还有距离。
模型切换移出代码后,谁来记录变化
虚拟模型 ID 是一个稳定入口。代码只负责请求这个名字,AI Gateway 决定它今天对应哪个供应商、哪个模型,以及失败后转向谁。模型路由从应用代码移到了平台配置。
作者首先要求收拢入口:业务使用的模型 ID 只在一个地方定义。示例通过 requireEnv 读取 AI_MODEL_ID 和 AI_MODEL_PINNED,缺少配置就抛错;前者保存虚拟模型 ID,后者保存可信的具体供应商/模型 ID,分别映射到 MODELS.chat 和 MODELS.pinned。ModelRole 则限制调用方可选择的角色。
统一调用函数解决的是另一个问题:每个入口都能留下相同的记录。
// src/ai/generate.ts
import { generateText } from "ai";
import { MODELS, type ModelRole } from "./models";

export async function ask(prompt: string, role: ModelRole = "chat") {
  const requested = MODELS[role];
  const result = await generateText({ model: requested, prompt });

  // 同时记录请求的模型,以及响应中报告的模型。
  console.log(
    JSON.stringify({
      requested_model: requested,
      response_model: result.response.modelId,
      input_tokens: result.usage.inputTokens,
      output_tokens: result.usage.outputTokens,
    })
  );
  return result.text;
}
要看的是 response_model: result.response.modelId 这一行。作者明确提醒:先在自己的日志里检查,使用虚拟 ID 时,这个字段究竟返回什么,再据此搭建看板。原文没有提供验证结果,不能直接认定它总能揭示最终供应商和模型。
按原文说明,设置 AI_GATEWAY_API_KEY 后,AI SDK 会把字符串形式的模型 ID 交给 AI Gateway。统一函数能够收拢调用,却不会自动补齐路由审计。
作者进一步建议采用 OpenTelemetry GenAI 语义约定,文中引用的版本是 1.44.0:通过 @opentelemetry/api 创建 span,写入 gen_ai.operation.name、gen_ai.request.model、gen_ai.response.model,以及 gen_ai.usage.input_tokens 和 gen_ai.usage.output_tokens;异常时记录错误并设置 SpanStatusCode.ERROR,最后结束 span。
查询时,把请求模型和响应模型组合起来分组。稳定入口对应的实际模型分布发生变化,就能发现路由行为变了。不过,这种变化也可能来自正常回退,追踪记录仍需结合控制台变更记录判断原因。
哪些失败可以换模型,必须提前约定
回退不是一次没有代价的重试。你为第一个模型调好的提示词,交给第二个模型,格式、能力和拒答行为都可能变化。
因此,作者把失败分成五类,只允许其中三类触发回退。下面这段代码用于约束仍在应用侧执行重试的路径:
// src/ai/fallback-policy.ts
export type FailureKind = "timeout" | "rate_limit" | "provider_down" | "bad_request" | "refused";

export function classify(status: number | undefined, err: unknown): FailureKind {
  if (err instanceof DOMException && err.name === "TimeoutError") return "timeout";
  if (status === 429) return "rate_limit";
  if (status !== undefined && status >= 500) return "provider_down";
  if (status === 400 || status === 422) return "bad_request";
  return "refused";
}

const MAY_FALL_BACK: ReadonlySet<FailureKind> = new Set(["timeout", "rate_limit", "provider_down"]);

export function mayFallBack(kind: FailureKind): boolean {
  return MAY_FALL_BACK.has(kind);
}

// 使用带硬超时的请求:
// const res = await fetch(url, { signal: AbortSignal.timeout(15_000), ... });
关键是 MAY_FALL_BACK:超时、429 限流和 5xx 服务故障可以继续尝试;400、422 请求错误,以及策略拒答应直接失败。示例用 AbortSignal.timeout(15_000) 设置 15 秒超时。
这份分类只能作为起点。最后一行把未识别的错误全部归为 refused,并没有真正识别供应商的策略拒答;认证失败、网络错误等情况也需要另外处理。分类函数本身也不会执行回退,更不会自动修改网关配置。
作者引用 Cloudflare AI Gateway 作参照:多步回退后,通过 cf-aig-step 响应头标记实际响应步骤,0 是主模型,1、2 是后续步骤。这是其他网关的例子,原文没有证明 Vercel 提供同名响应头。
回退要有明确原因,也要能查到实际走了哪一步。
如果网关负责回退,应用侧主要保留超时控制和日志;仍然直连供应商的旧路径,再单独定义重试策略。否则,两层同时重试容易放大请求次数和等待时间。候选模型也必须提前评测,不能只按当时的价格挑选。
不部署就能切换,更需要一份对照基线
固定模型 AI_MODEL_PINNED 的用途,是给虚拟路由提供可比较的基线,也保留一个明确的回退目标。
作者给出 scripts/route-eval.ts,运行命令为 npx tsx scripts/route-eval.ts。脚本用 Promise.all 并行评测虚拟模型和固定模型:两条输入分别要求返回带 intent、refund 字段的 JSON,通过 JSON.parse 检查能否解析、目标键是否存在。如果虚拟模型得分低于固定模型,就执行 process.exit(1)。
作者自己承认,两条用例只是玩具示例,建议从真实日志中选取 20 条案例,接入定时 CI,并在每次修改路由前后运行。
这里需要看清评测覆盖范围:字段存在,不代表字段类型正确,更不代表订单取消或退款意图判断正确。它适合发现最初级的输出格式退化,无法单独证明业务质量没有下降。脚本失败也只是报错退出,并没有自动回滚控制台配置。
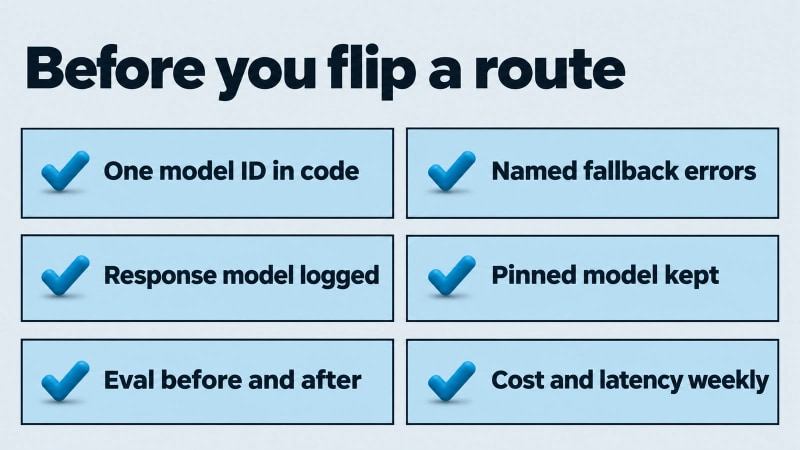
原文最后补充了成本和延迟检查:每周按实际响应模型查看单次请求成本与 p95 延迟。否则,成功率看起来正常,用户可能已经在等待更慢、价格更高的回退模型。
我的判断
我赞同作者把注意力放在变更控制上。虚拟 ID 降低了切换成本,也让代码仓库无法完整解释线上行为。相比把模型选择分散在多个处理函数里,统一入口、明确规则和追踪属性更容易维护。
但原文是一套工程建议,没有给出团队实测的故障率、成本变化或质量对照数据。「20 条真实案例可以作为门禁」也是经验建议,用例是否有效取决于业务覆盖,不能只看数量。
对已有代码评审和发布流程的团队,把路由配置放在代码里仍有优势:差异、责任人和测试结果容易关联。控制台路由适合需要快速切换的场景,前提是团队补齐配置变更记录和评测流程。两种方式的取舍,不只看能否少部署一次。
另外,固定模型是对照基线,不是永远正确的答案。相对得分没有下降,仍可能是两边都答错了。真正的门禁还需要业务认可的预期结果。
能拿来做什么
- 在现有 Node AI 调用层集中管理
AI_MODEL_ID和AI_MODEL_PINNED,统一记录请求模型、响应模型与 token 用量,并先验证响应模型字段的实际含义。 - 检查网关和应用是否同时重试,为超时、限流、服务故障分别写清处理规则,让请求错误和策略拒答有独立记录。
- 从真实业务日志挑选固定评测案例,在路由切换前后执行;对 JSON 输出同时检查解析、字段类型和业务结果,保留切换前的配置。
- 按实际响应模型比较单次请求成本和
p95延迟,把评测结果与路由变更记录放在一起,便于决定是否回滚。