Agent 任务该用循环验证还是分支编排
文章用 osFoundry 说明两种任务组织方式:Loop 按固定路径反复执行,以外部检查验收,并设置轮数和失败上限;Graph 支持条件分支、并行、重试与人工审批。示例以 npm test 的退出码判断修复是否完成,避免仅凭 Agent 自报成功。
AI 深度解读
AI 助手说测试修好了,测试执行器却还在报错,问题往往出在缺少可靠的验收和停止规则。osFoundry 的 Loop 把目标、agent 团队、检查方式和重试上限打包起来;Graph 则负责分支、局部重试和人工审批。
原文给出的选择标准很直接:固定步骤反复执行,用 Loop;下一步取决于上一步的结果,用 Graph。对程序员更有参考价值的,是它如何把一句「帮我做完」变成有检查、有边界、能追查的执行过程。
修没修好,应该由谁说了算
Loop 是可复用的任务配置,包含 agent 名单、自然语言目标、验收方式、轮数上限、连续失败上限,以及可选的触发条件。每轮结束都要检查目标,满足条件后停止。
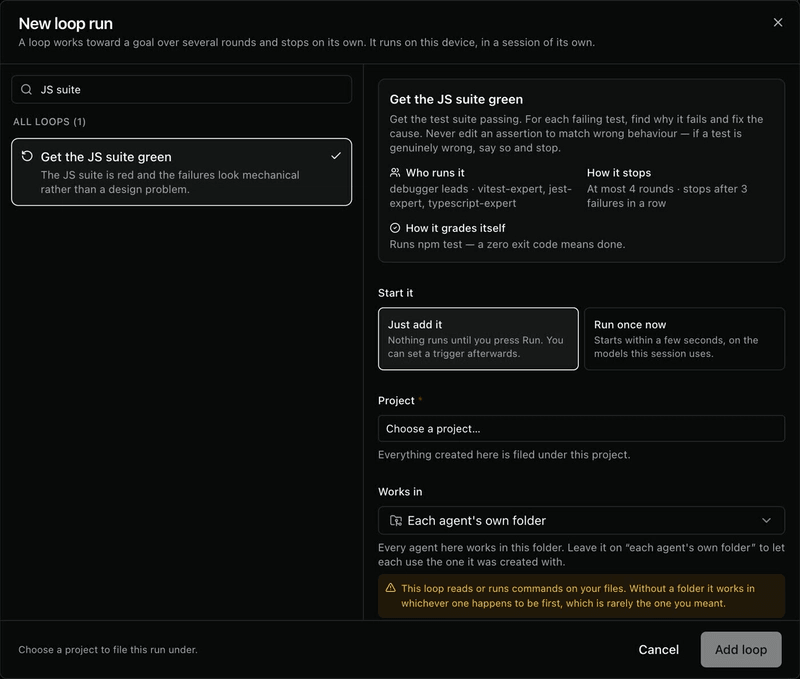
原文用 JavaScript 测试说明这个机制。进入 New session,搜索「JS suite」,选择 Get the JS suite green,启动卡片会提前交代:
- 一个调试 agent 带领三位测试专家。
- 最多执行 4 轮,连续失败 3 次就停止。
- 执行
npm test,只有 exit code 为零才算完成。
选 Run once now,指定项目和工作目录,再点 Run it now,就能在 Rounds 查看逐轮结果。
示例中,三项测试从第一轮通过一项,到第二轮通过两项,再到第三轮全部通过,状态变为 Verified。界面同时显示「Round 3 of 4」和连续验证失败计数;必要时也能 Pause 或 Cancel。
Verified 的依据是最后一轮通过检查。
这里必须留个边界:原文明确说测试和文件名是示例数据。这组「1/3、2/3、3/3」展示了产品流程,不能拿来证明真实项目的修复成功率。它能说明验收机制如何工作,不能证明多 agent 比单 agent 更有效。
定时运行只是 Loop 的一个入口
另一个例子是 Watch the competitors。它只进行网页搜索,不碰本地文件,用户填写公司和关注项,例如价格、新功能、招聘信息,就能执行。原文描述的报告只列变化,每条附日期和来源,并把公司的自述标为未经查证。
需要定期运行时,在 Trigger 中选择 Add a schedule。预设包括 Every 30 min、Hourly、Daily 09:00 和 Weekdays 09:00,界面会展示 cron 配置及接下来三次执行时间。
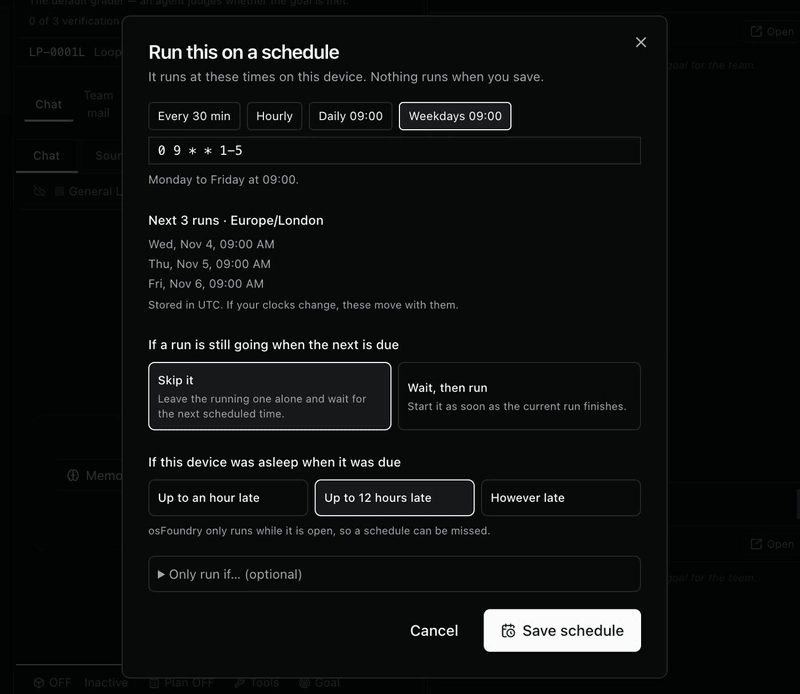
更有实际价值的是两组异常处理:上次还没结束,可以 Skip it 或 Wait, then run;错过执行时间,可以接受 Up to an hour late、Up to 12 hours late 或 However late。
但排程依赖桌面应用保持开启。原文说的「每天早上都有报告」,需要在这个条件下理解,补跑也不等于准时运行。
Loop 因此不能简单等同于 cron job。cron 负责到点启动,Loop 还负责组织团队、检查目标、限制重试并保存每轮结果。它也可以只手动执行一次,完全不设排程。
下一步需要看结果,才轮到 Graph
如果任务是逐文件审查、合并报告,并在不可逆操作前等待批准,固定重复同一套计划就不够用了。
Graph 是保存下来的工作流程序,支持按结果分支、局部重试、并行分发、人工审批和调用其他 Graph。Loop 也能并行跑 agent,因此并行能力不是两者的分界。
真正的分界是:下一步是否需要根据执行结果改变。
Graph 提供 Start with a working graph 和 Choose a starter 两种创建入口。三个 starter 对应了常见结构:Review each item, then merge 逐项并行处理后汇总;Triage and route 分类后交给一位专家;Propose, ask, then apply 先提出变更,得到肯定答复后再执行。
Graph 用代码表达控制流程,没有采用拖拽式流程图。用户可以让 Maestro 或 agent 修改程序,在 Configure session 调整 Maximum agents at once、token 警示、Hard token ceiling、默认输入及各步骤的 agent 和模型。
运行面板的 Run、Changes、History 分别用于查看步骤、文件变更和历史记录。审批卡片提供 Approve 或 Decline,等待时其他并行工作继续。部分文件变更可以复原,但原文没有说所有操作都能回滚。Graph 可以在浏览器查看,执行仍需要桌面应用。
两者还可以组合:排程好的 Loop 在 9:00 调用会分支的 Graph。Loop 配置可在 osStudio 中做版本管理,Graph 则有固定标识供其他流程调用。
我的判断
我认同把验收交给外部检查的方向。对于测试、类型检查和 lint,成功条件比「看起来完成了」更明确。不过,npm test 返回零只能证明当前测试集通过,测试遗漏的需求仍可能出错。
原文没有给出成本、耗时、成功率或对照实验。四位 agent 的配置是否优于单 agent,Graph 是否比现有脚本更省维护,仍属于待验证的问题。
对步骤明确的项目,脚本配合 CI 已经能提供退出码检查、日志和定时触发。Loop 的价值在于把这些能力与 agent 执行整合起来;Graph 则更适合确实需要路由、局部重试和人工审批的任务。流程越复杂,越要检查控制代码本身是否可靠,不能只依赖 agent 生成。
能拿来做什么
- 给前端或 Node 修复任务先定义验收命令,例如原文的
npm test,同时检查测试是否覆盖了要修的问题,再决定是否交给 Loop 反复执行。 - 首次使用 Loop 时,先手动跑一次,查看 Rounds 中的实际检查结果,并确认最多 4 轮、连续失败 3 次这样的停止条件是否适合当前任务。
- 做逐文件审查时,先判断是否需要分类路由、只重跑失败部分或人工批准;存在这些需求,再考虑 Graph,并配置并发限制和 Hard token ceiling。
- 给竞品监测加排程前,明确任务重叠和错过执行时间的处理方式,同时确认桌面应用能够在计划时段保持开启。