用 GKE 沙箱兼顾智能体执行隔离与速度
文章讨论代码执行智能体在容器隔离与启动延迟之间的取舍,介绍基于 Kubernetes Agent Sandbox、gVisor 和 GKE Pod Snapshots 的执行方案。其目标是通过隔离机制与快照能力实现亚秒级执行环境准备。
AI 深度解读
Agent 一旦能自己写代码、执行 Shell,普通容器的安全边界和启动速度就会同时受到考验。原文给出的方案是:用 GKE Agent Sandbox 管理执行环境,用 gVisor 隔离内核访问,再通过预热池和快照减少等待。
这套设计值得看,但「亚秒级」「零信任」要拆开理解。作者提供了配置与 SDK 示例,没有给出完整压测或安全验证。对程序员更有用的,是它如何划分执行权限、会话状态与计算资源,以及这些设计成立需要哪些前提。
为什么给每个 Agent 一个 Pod 还不够
普通 Kubernetes Pod 中的容器共享宿主机 Linux 内核,主要依靠 namespaces、cgroups 和 seccomp 限制访问与资源。作者担心的是:执行内容来自模型,还可能受到外部日志、GitHub issue 或网页中的间接提示注入影响。攻击者未必直接访问执行器,也可能诱导 Agent 生成危险命令,探测 io_uring、eBPF 或未修补的系统调用路径。
另一个问题更容易碰到:会话串数据。把执行请求分发到共享 Deployment,Session A 留在 /var/tmp 的凭据或文件,可能被随后进入同一副本的 Session B 读到。内核隔离和会话隔离是两件事,前者增强了,也不能自动解决后者。
于是作者提出单租户、具备内核隔离边界、支持多轮状态的沙箱。普通容器启动快,却共享内核;完整 micro-VM 隔离更强,但每次工具调用都启动客体内核,会增加时间和内存开销。
原文提到两组启动时间:标准 Kubernetes 的典型供应耗时为 1–3 秒或更久;包含镜像拉取、Python 环境初始化和重依赖导入时,可能达到 15–45 秒。两者覆盖的阶段不同,不能当成同一指标比较。每个会话若有数百次工具调用,反复承担这些开销,交互就很难流畅。
预热池把哪些等待提前做掉了
GKE Agent Sandbox 的思路,是把沙箱变成 Kubernetes 声明式资源。原文称该项目基于开放的 kubernetes-sigs/agent-sandbox,采用 gVisor,并支持 Kata Containers;它还称 GKE 集成已达到 GA,但没有提供对应版本和发布依据。
文中使用 agents.x-k8s.io API 组,重点围绕 SandboxTemplate、SandboxWarmPool、SandboxClaim 和 Sandbox 生命周期展开。模板规定执行环境,预热池提前准备实例,申领机制把实例交给具体会话。
下面这份原始配置同时定义了安全限制与预热容量:
apiVersion: agents.x-k8s.io/v1alpha1
kind: SandboxTemplate
metadata:
  name: python-agent-executor
  namespace: agent-workloads
spec:
  template:
    spec:
      # 1. 强制使用 gVisor 用户态内核隔离
      runtimeClassName: gvisor
      nodeSelector:
        sandbox.gke.io/runtime: gvisor
      tolerations:
        - key: sandbox.gke.io/runtime
          operator: Equal
          value: gvisor
          effect: NoSchedule

      # 2. 不向沙箱挂载 Kubernetes API 凭据
      automountServiceAccountToken: false

      containers:
        - name: code-runner
          image: us-central1-docker.pkg.dev/my-gcp-project/agent-repo/sandbox-runtime:v1.2
          securityContext:
            runAsNonRoot: true
            runAsUser: 10001
            allowPrivilegeEscalation: false
            capabilities:
              drop: ["ALL"]
          # 3. 用硬性资源配额限制 fork bomb 和 DoS
          resources:
            requests:
              cpu: "500m"
              memory: "1Gi"
            limits:
              cpu: "1000m"
              memory: "2Gi"
---
apiVersion: agents.x-k8s.io/v1alpha1
kind: SandboxWarmPool
metadata:
  name: python-executor-warm-pool
  namespace: agent-workloads
spec:
  templateRef:
    name: python-agent-executor
  # 保留 20 个预热沙箱供即时申领
  minReady: 20
  maxSandboxes: 200
重点看 runtimeClassName: gvisor、automountServiceAccountToken: false 和 minReady: 20:它们分别处理运行时隔离、集群凭据暴露、启动等待。镜像中的 v1.2 是示例应用镜像标签,不能当成 Agent Sandbox 的产品版本。
原文还称,GKE admission controller 会禁止 hostNetwork、privileged: true、hostPath 和新增 capabilities。实际落地仍需核对集群能力与策略,不能只凭模板字段判断限制已经生效。
预热池的收益来自提前支付启动成本。
按作者描述,控制器先准备 20 个 gVisor Pod,Agent 从运行中的实例申领,才可能获得毫秒级响应。原文没有交代池耗尽、集中突发、节点扩容时的延迟,也没有给出 P95 或 P99 数据。
快照解决等待人工时的资源占用
预热池处理首次启动,多轮会话还有另一笔账:Agent 等人批准时,执行环境是否继续占用资源?
作者假设,一个任务先花 8 秒加载 500MB 依赖图、连接预发布数据库,并在 /tmp 建立 SQLite 缓存。随后人工审批等待 15 分钟。如果有 5,000 个并发会话,全部保留运行中的 Pod,计算成本会持续累积;直接删除,又会损失状态。
原文提出用 GKE Pod Snapshots,即 podsnapshot.gke.io,把运行状态保存到 GCS,再切换 operatingMode: Suspended 删除底层 Pod;恢复时切回 operatingMode: Running。
文中安装命令为 pip install "k8s-agent-sandbox[tracing]==0.4.6",客户端为 PodSnapshotSandboxClient。下面是示例中的暂停与恢复部分:
    print("Waiting for human approval... Suspending sandbox to zero compute.")
    suspend_result = sandbox.suspend(snapshot_before_suspend=True)
    assert suspend_result.success

    # --- [10 分钟后:用户在 Slack 中批准操作] ---

    # 5. 从 GKE Pod Snapshot 恢复沙箱
    #    将 operatingMode 改回 Running,并从 GCS 恢复内存和文件系统
    print("Approval received! Restoring sandbox from snapshot...")
    resume_result = sandbox.resume()
    assert resume_result.success and resume_result.restored_from_snapshot
关键是 snapshot_before_suspend=True,以及恢复后检查 restored_from_snapshot。代码注释用的是等待 10 分钟,与前面的 15 分钟同属场景假设,并非实测结果。
完整示例通过 sandbox.commands.run() 写入 pandas pickle 文件,再在恢复后启动新的 Python 命令读取它。因此,示例直接展示的是文件状态恢复路径;仅凭这段代码,无法证明长期驻留进程的堆内存、CPU 寄存器和外部连接都能无条件恢复。
作者进一步提出 Golden-Snapshot Warm Pools:先加载 PyTorch、Playwright 或内部 SDK,预热 JIT 与解释器缓存,通过 PodSnapshotManualTrigger 生成快照,再让新沙箱从快照启动。方向合理,但原文没有给出对应配置和计时结果。
我的判断
我认同它把执行环境视为不可信边界,并将 Agent Orchestrator 与执行沙箱分开。负责 ADK、system prompts 和 Vertex AI 凭据的编排器,确实不该把这些权限顺手交给代码执行进程。
不过,「零信任」还需要网络和身份控制。原文建议通过 ClusterNetworkPolicy 限制出站,阻断元数据地址 169.254.169.254,只允许访问获批 MCP 端点或受检查的出口代理;执行身份则使用短期、限定资源范围的 OAuth/JWT token,避免向 sandbox.commands.run() 传入长期 IAM 密钥或静态数据库密码。
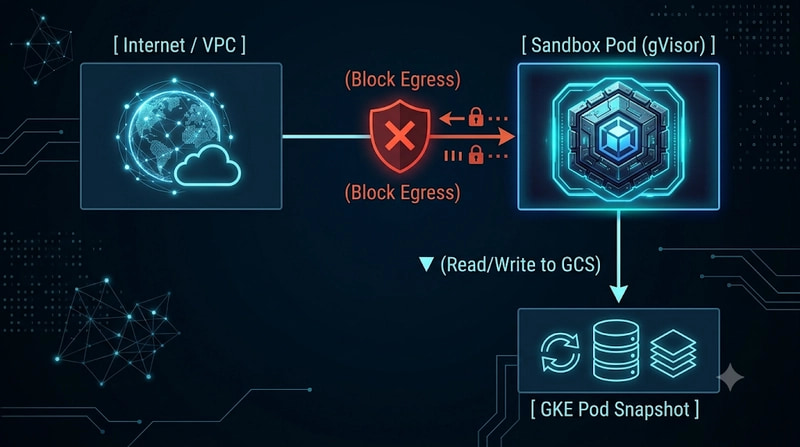
内核隔离减少逃逸风险,凭据和出站策略限制越权之后能做什么。
快照也不是免费的状态仓库。删除 Pod 可以释放计算资源,但仍需考虑 GCS 存储、快照读写,以及快照中可能包含的凭据。外部数据库连接、令牌过期和浏览器会话如何处理,原文没有说清。
与每次启动新 Job 相比,这套方案更适合重初始化、多轮、有等待的任务;如果只是短命令或可重建的无状态任务,快照生命周期也可能增加复杂度。作者没有提供对照压测、成本表和兼容性测试,因此「亚秒级恢复」目前应作为待验证的工程目标。
能拿来做什么
- 如果正在做 AI 编程执行器,可以先拆开编排服务与执行环境:模型凭据留在编排端,生成代码通过 sandbox-router HTTP proxy 下发到单会话沙箱,并设置资源上限。
- 如果 Agent 经常运行 Playwright 或加载重依赖,可以分别记录申领、依赖初始化、命令执行和恢复耗时。原文建议启用
k8s-agent-sandbox[tracing],通过 OpenTelemetry spans 接入 Google Cloud Trace,定位真正的等待阶段。 - 如果流程包含人工审批,可以用真实工作负载验证暂停与恢复,重点检查临时文件、驻留进程、过期 token 和外部连接,再决定哪些会话值得保存快照。
- 如果执行环境需要访问内部服务,可以先列出允许的 MCP 端点和资源权限,把出站白名单、短期身份与内核隔离一起配置。