OpenMobile-2 用多应用训练提升手机智能体
OpenMobile-2 团队构建了覆盖逾 110 款应用的开放训练环境,其中包含 35 款热门应用的复刻版本,强调应用多样性对训练的作用。作者称,其模型在真实 Android 设备上的成绩领先其他开放智能体。
AI 深度解读
OpenMobile-2 想证明,开源手机智能体要追上闭源模型,关键不只是增加训练数据,还要让模型在更多不同的 App 里练习。研究团队搭建了覆盖 110 多个应用的训练环境,并开放模型、环境、数据和复现说明;其中 27B 模型在真实 Android 设备上的 SPA-Bench 得到 59.6 分,作者称这是开放模型中的最高成绩。
对程序员来说,更值得读的是成绩背后的工程方法:怎样把应用做成可重复训练、自动验收的环境,以及为什么给智能体接上工具后,还需要专门教它使用。
为什么要重建 App,而不直接在真机上练
真实 App 不适合大规模反复试错。登录会过期,下单可能产生真实交易,操作后的状态也未必能恢复。一次失败留下的数据,还可能干扰下一次训练。
研究团队因此重建了 35 个应用,包括淘宝、京东、滴滴、美团,也包括 Slack、Google Drive。再结合已有模拟应用和 Android 模拟器中的应用,训练环境总计覆盖 110 多个应用。图中分别列出 63 个模拟应用、62 个模拟器应用,但原文没有交代两类的重叠口径,不能直接相加当作独立应用数。
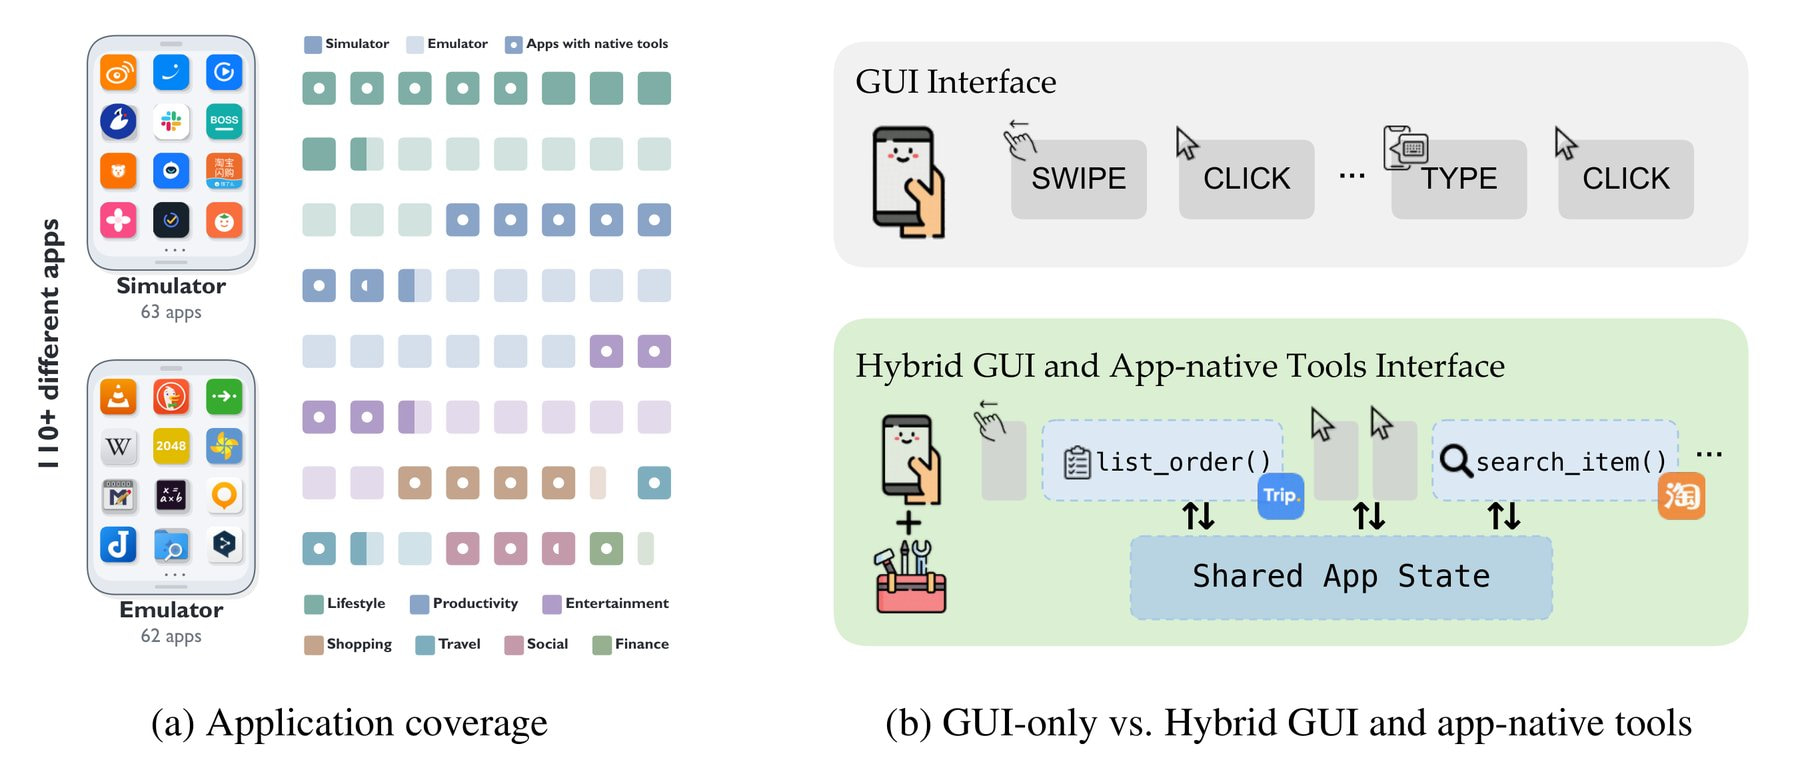
这些重建应用需要经过人工对照,持续调整界面和操作流程。订单、预算、出行计划可以跨会话保存,应用之间能通过剪贴板传递数据,每次实验又能自动恢复初始状态。普通界面操作模式下,智能体通过截图观察页面,不能直接读取应用内部数据。
这里最有价值的设计,是把应用行为变成可检查的状态变化。例如,下单是否成功,要看订单数据有没有按预期改变,而不是看模型是否回答了「已完成」。研究者先定义操作与状态的关系,再回放流程、核对结果。
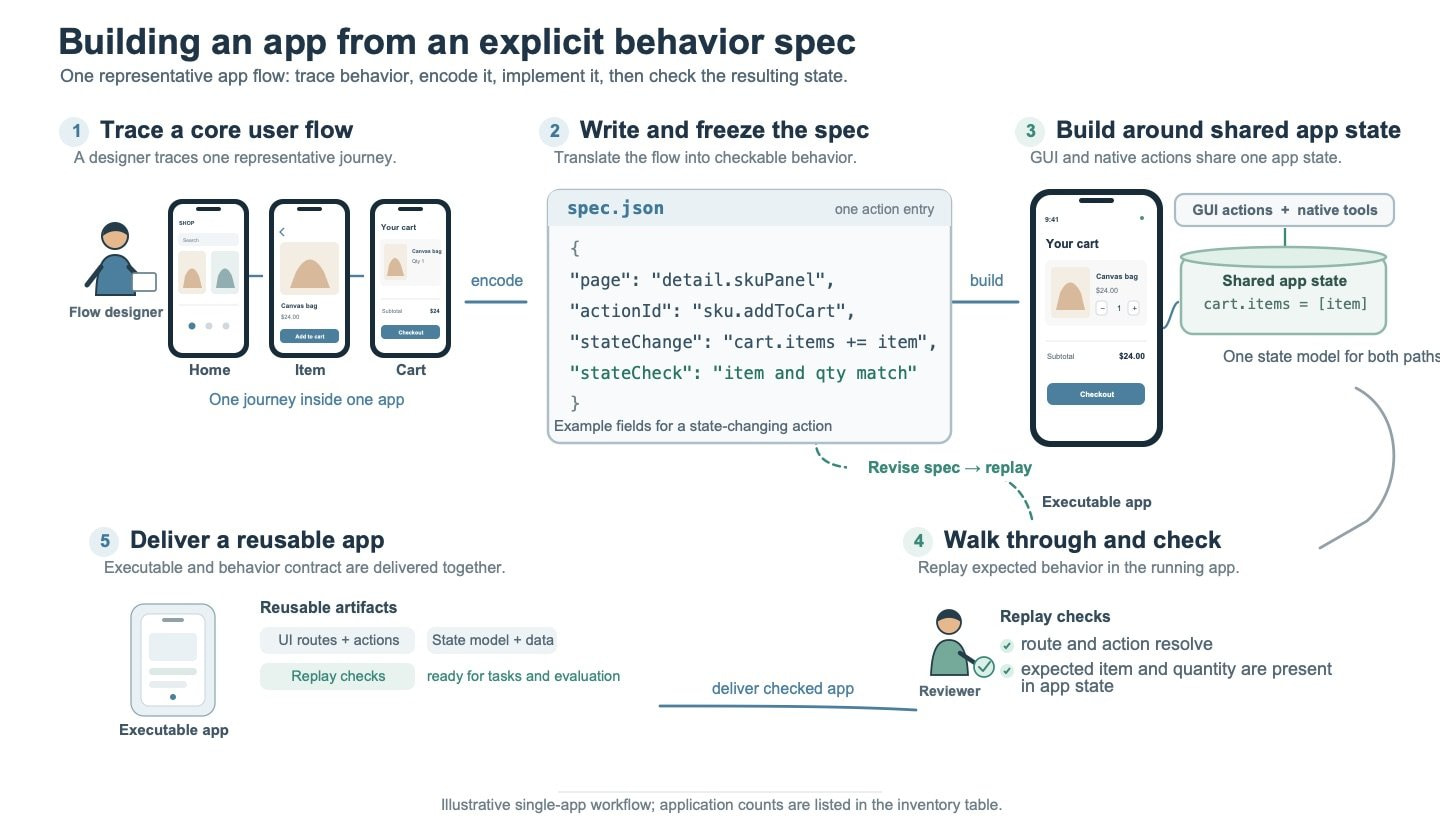
依靠这套环境,他们生成了约 11,600 条示例流程,以及超过 2,000 个带自动成功检查的练习任务。示例由 Gemini 3.1 Pro 生成,因此,这也是一个开源模型学习闭源教师输出的方案。
真机成绩提高了,但更值得看的是应用多样性
OpenMobile-2 提供两个模型:基于 Qwen3.5 的 9B 版本,以及基于 Qwen3.6 的 27B 版本。
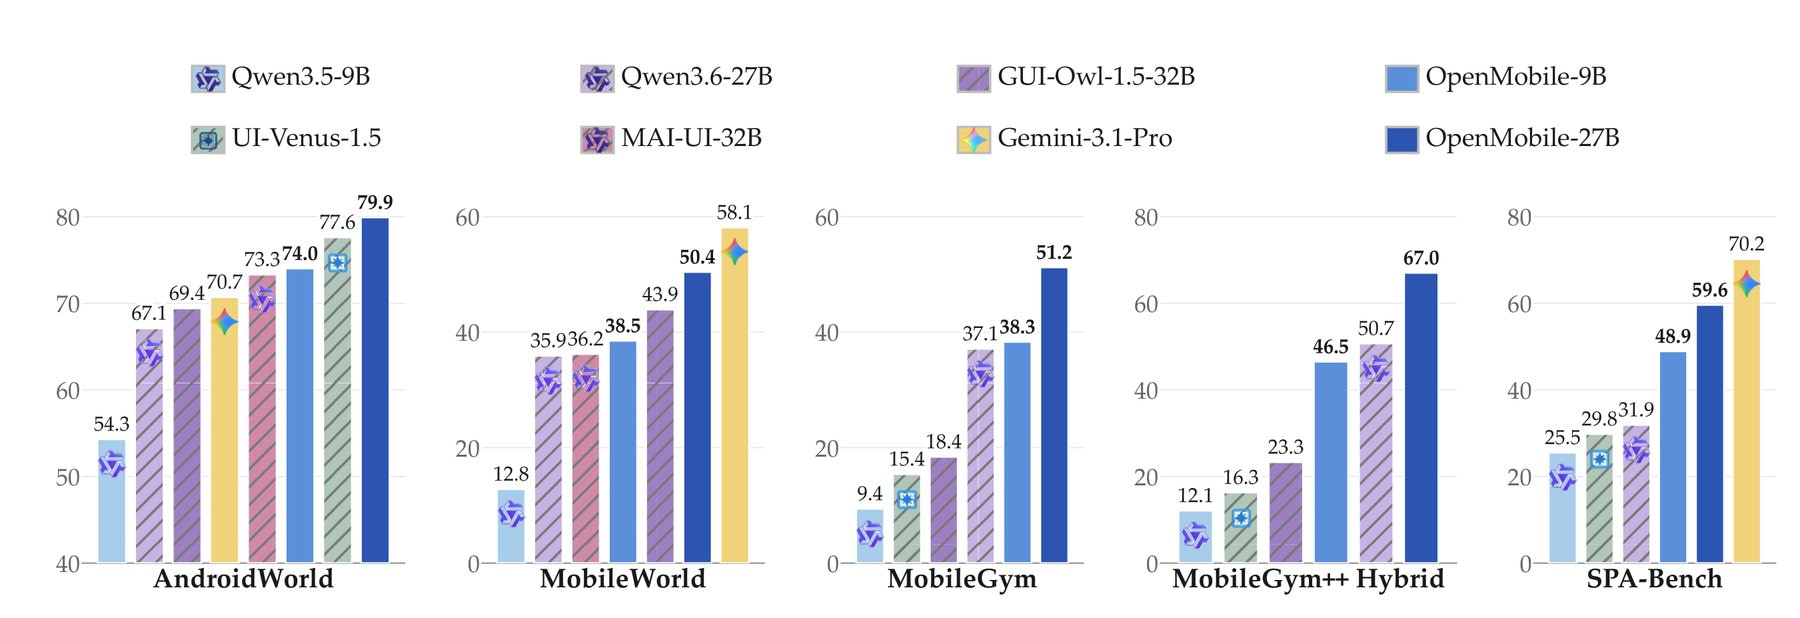
在 AndroidWorld 上,27B 模型从 67.1 分提高到 79.9 分,9B 模型从 54.3 分提高到 74 分;前代 OpenMobile-1 为 64.7 分。在任务更长、涉及跨应用操作的 MobileWorld 上,27B 模型从 35.9 分提高到 50.4 分。
真实 Android 设备上的 SPA-Bench 提升更大:27B 模型从 31.9 分提高到 59.6 分。按作者报告,这是开放模型中的最好成绩,图中仍落后于 Gemini 3.1 Pro。因此,「能与闭源模型竞争」不能理解为已经全面超过闭源模型。
固定数据量后,增加训练应用种类,仍然能提高陌生应用上的成功率。
这是全文最有说服力的实验。研究者保持训练数据总量不变,只增加应用种类,未见应用上的成功率便从 60.7% 提高到 67.5%,增加了 6.8 个百分点。相关图表展示了训练应用数量从 15 个扩展到 53 个时的变化。
这个结果支持一种解释:模型需要接触不同的页面组织、交互方式和任务流程,才更可能学会迁移;反复练习少数应用,容易让能力停留在熟悉的路径里。但它不能证明数据规模不重要,只能说明在这组实验的数据预算下,多样性更划算。
强化学习也没有稳定带来额外收益。增益主要出现在接近训练环境的任务中;27B 模型在 AndroidWorld 上反而从强化学习前的 80.8 分降至 79.9 分。训练阶段增加了,并不保证泛化能力跟着增加。
工具能绕过菜单,但模型需要学会何时调用
研究中还有一条实验路线:让智能体同时使用界面操作和应用提供的直接命令。
超过 50 个模拟应用开放了这类工具,例如 list_order()、search_item(),以及直接加入购物车的命令。智能体可以根据情况,在点击、滑动、输入与工具调用之间切换。工具和界面共享应用状态,调用后的结果仍要接受任务检查。
问题在于,接口摆在那里,模型未必会用。未经针对性训练时,模型倾向于忽略这些捷径;训练后,任务成功率最高提高 10.3 个百分点,平均少走约 5 步。作者还报告,这种能力可以迁移到训练期间没见过的工具。
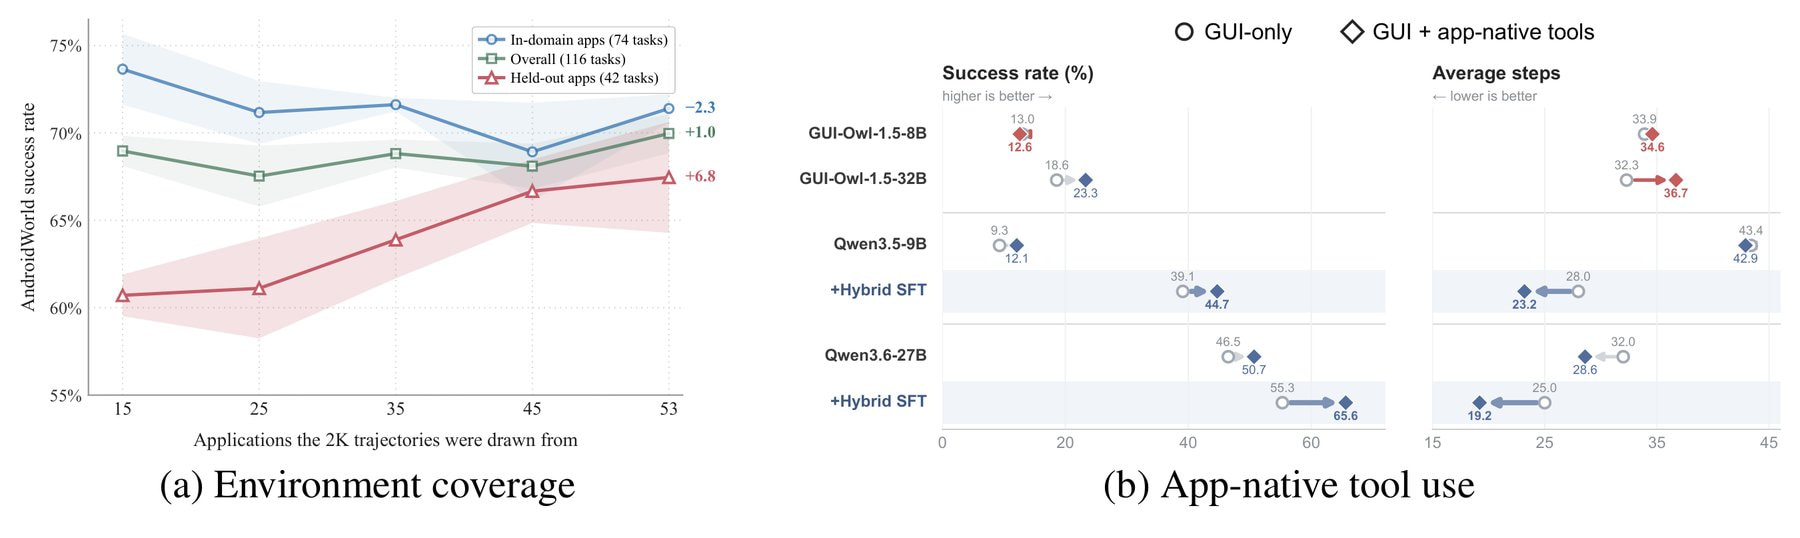
后续强化学习阶段,只要一次执行包含至少一次直接命令,就能获得工具使用的奖励系数,但奖励仍取决于任务是否完成;虚报成功会受罚。这样的设计是在鼓励模型尝试工具,同时避免把「调用过工具」当作完成任务。
边界也很明确:这些接口目前只存在于模拟应用,研究者自己也将它称为实验方案。部分成绩来自团队自建的 215 项任务基准,其中近一半涉及跨应用操作。验收程序比较执行前后的应用存储数据;作者检查了训练与测试任务的重叠,报告只有少量相似之处。
我的判断
我更认可这项工作对训练环境的投入。可重置状态、自动验收、跨应用数据流转,让智能体训练具备了可重复实验的基础。固定数据量比较应用多样性,也比单独展示排行榜涨分更能解释改进来源。
不过,模拟应用再接近真实产品,也不能自动覆盖登录异常、弹窗、网络波动和版本变化。真机成绩提供了迁移证据,但原文没有给出足够细的失败分类,无法判断剩余问题主要出在哪里。开放训练材料也不等于脱离闭源能力,示例仍来自 Gemini 3.1 Pro。
工具路线同样有现实前提。原文援引 Microsoft Research 的 2025 年研究,将 API 智能体概括为更可靠、GUI 智能体更灵活;OpenMobile-2 尝试结合两者,但普通团队未必能给第三方 App 增加接口。Oppo 的 X-OmniClaw 则通过 deeplinks 重放已展示的路径,Google 把手机控制放进 Gemini 3.5 Flash。它们解决问题的条件不同,原文没有统一对照数据,不能据此排出优劣。
能拿来做什么
- 做界面智能体评测时,先准备可恢复的初始数据和明确的完成条件。前端页面显示成功之后,还应检查订单、记录等业务状态是否真的改变。
- 训练或整理任务样例时,可以借鉴固定预算的对照方式:保持样例总数相近,比较少数应用反复练习与覆盖更多应用的效果,并单独留出未见应用做测试。
- 如果团队掌握应用和 Node 服务,可以试验界面操作与业务工具混合执行。工具接入后,要验证模型是否会主动选择它,以及是否减少步骤,不能只检查调用是否成功。
- 评估 OpenMobile-2 时,先区分纯界面任务、混合工具任务和真机任务,再对照自己的目标场景选择成绩。不要用模拟环境中的工具收益估算真实设备上的自动化效果。