本地模型并发实测:吞吐量与延迟要分开看
TensorFold 公布 Spark-X2.6-4B 的原生 CUDA 测试:RTX 5090 上单路约 191–204 tokens/s,四路合计约 716–729 tokens/s。结果采用 8 位转换,测量的是解码吞吐,不能等同于单用户速度、完整请求延迟或回答质量。
AI 深度解读
本地模型一个人用着快,四个人同时请求,还能不能撑住?TensorFold 的 Spark-X2.6-4B 原生 CUDA 实验给出了一组容量数据:RTX 5090 上,四路请求的合计生成速度达到 716–729 tokens/s,但这不是每位用户都能拿到的速度。
这组测试值得看,是因为作者同时交代了长输入等待、显存开销和功能边界。它能帮助判断一台机器可以怎样服务多人,却不能证明模型答得更好,也不能直接推导真实业务的响应时间。
四路合计 729 tokens/s,用户实际能得到多少
TensorFold 是由 ashhart 维护的社区项目。作者在 Linux、RTX 5090 上,使用 8-bit 转换和 32,768-token 上下文设置,报告了以下结果:
| 并发请求数 | 合计生成速度 |
|---|---|
| 1 路 | 191–204 tokens/s |
| 2 路 | 375–389 tokens/s |
| 4 路 | 716–729 tokens/s |
测试对每个提示生成三次 256-token 回复,使用贪心解码,并取中位数。
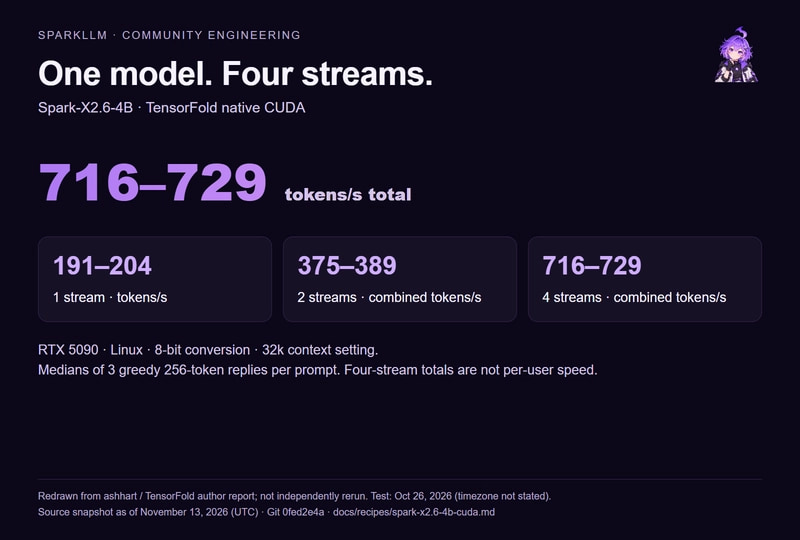
并发增加后,合计吞吐量接近按比例增长,说明这套配置在这些测试条件下还有服务多路请求的能力。不过,原文没有给出四路请求各自的速度分布,不能据此判断每个人是否一样快。
合计吞吐量回答机器能产出多少,单请求延迟才回答用户要等多久。
长文读完后生成稳定,不代表长文处理没有成本
作者还记录了四类提示在加入 28k-token 输入前后的表现,生成速度维持在相近范围。
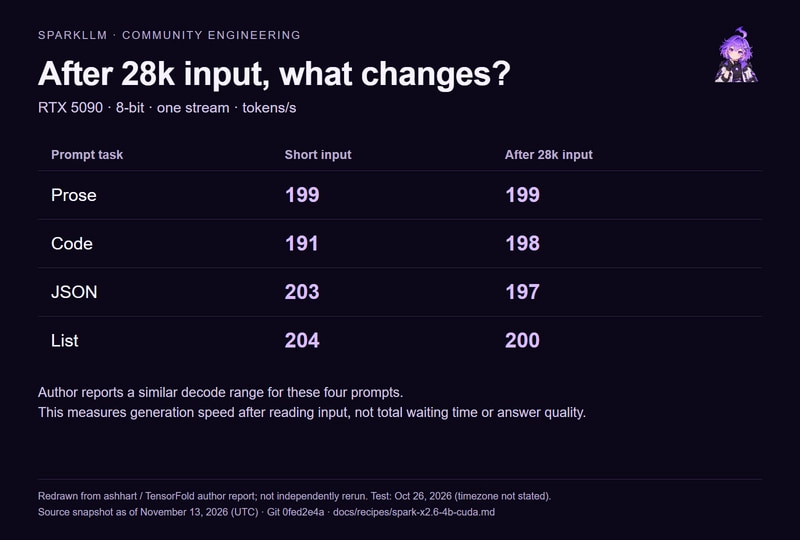
这里测的是解码(decode)速度,也就是模型开始输出之后,每秒生成多少 token。它没有把读取长文的等待算进去,也没有评价回答质量。
另一组 RTX 4090、Windows、8-bit 测试给出了首 token 等待时间:
| 输入长度 | 首 token 等待 |
|---|---|
| 2k | 0.24 秒 |
| 8k | 0.93 秒 |
| 16k | 1.93 秒 |
| 29k | 4.65 秒 |
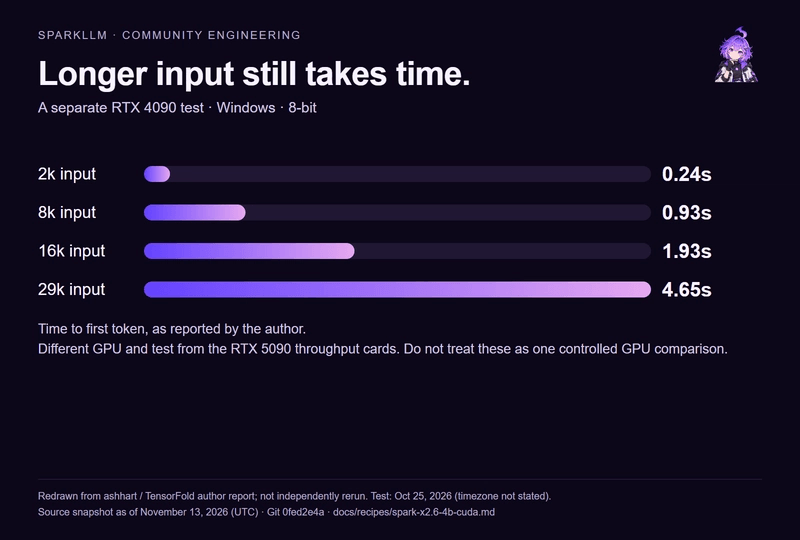
输入越长,用户看到第一个字之前的等待越明显。对长文问答来说,开始输出后的速度和开始输出前的等待,需要一起看。
这组数据与 RTX 5090 测试的硬件、操作系统和条件不同,不能用来做两张显卡的受控性能比较。
显存够不够,还要看每路请求的成本
在 RTX 5090 服务器上,作者报告模型占用 9.47 GiB;采用 32k 设置时,每增加一路请求,还需要 1.23 GiB。
因此,评估本地服务容量时,只看模型能否装进显存还不够,还要给并发请求留下空间。真实服务的容量仍需在目标负载下验证。
作者做了两类输出一致性检查:并发贪心回复与单独运行的回复,12/12 一致;关闭 copy drafts 后的回复与启用时的回复,也是 12/12 一致。这只能说明这些样本的输出没有变化,不能当成任务正确率。
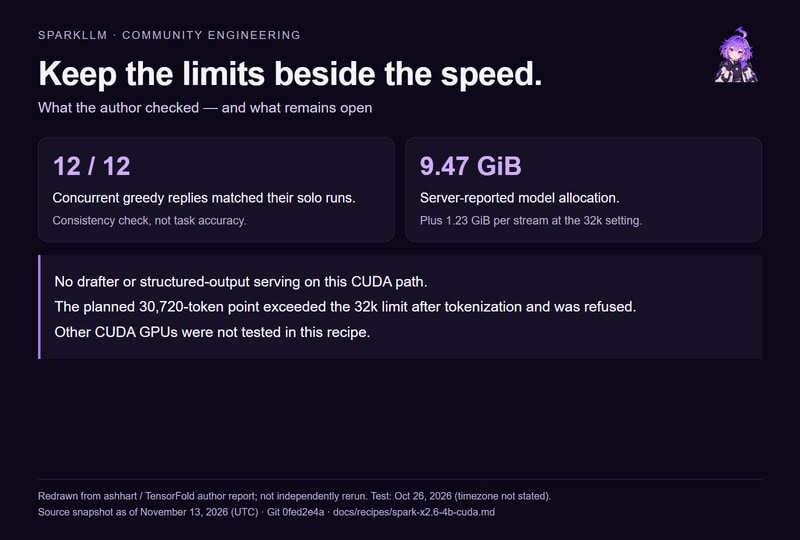
边界也很具体:这条 CUDA 路径不提供 drafter,也没有结构化输出模式。原计划的 30,720-token 输入,经分词后超过 32k 限制,被拒绝执行。配方覆盖 RTX 4090 和 RTX 5090,其他 CUDA GPU 尚未在其中验证。
我的判断
我认可这篇把吞吐、等待和边界放在一起的写法。相比只展示单路 tokens/s,它更接近部署时需要做的判断。
但这些仍是作者报告的测试结果,SparkLLM 没有独立复跑,也没有给出其他推理方案的对照数据。因此,它支持「这套配置值得在相近环境复现」,不支持「TensorFold 比其他方案更快」或「Spark-X2.6-4B 更适合所有任务」。
来源将 RTX 4090 测试标为 2026 年 10 月 25 日,RTX 5090 测试标为 10 月 26 日,未注明时区;核查时间为 2026 年 11 月 13 日(UTC),源码修订为 0fed2e4a5fcc03f109cfaaf8eda10734cce21fb7。图表是按数值报告重绘的,并非运行截图,SPARK 角色插画也不是测试证据。
对于需要固定 JSON 的 Node 工具调用服务,缺少结构化输出模式是实质限制。即使速度合适,也不能假定它能直接替换已有方案。
能拿来做什么
- 复现时从固定版本的 TensorFold CUDA 配方开始,核对 Spark checkpoint revision、转换命令和构建命令。原文提到这些内容,但没有展开具体命令。
- 给 Node 服务做并发评估时,同时记录单请求速度、合计吞吐和首 token 等待,避免用一个总吞吐数字代表所有用户的体验。
- 做长文问答或代码上下文输入时,用实际输入长度测试等待时间,并检查分词后的长度是否超过上下文限制。
- 分享其他显卡的测试结果时,一起提供 GPU、量化方式、提示长度、并发数、解码速度和首 token 等待,让别人能判断结果是否适用。