一句仓库指令能替代多少技能配置
作者用 10 个任务、每种条件重复 5 次,对比默认配置、ADR 搜索技能和单句仓库指令,共运行 150 次。三组正确率接近,技能与单句指令分别降低约 20% 和 14% 的成本,未体现准确率提升。
AI 深度解读
给 AI 编程助手补一个检索 skill,收益到底来自脚本,还是来自一句更清楚的指令?karasu 作者围绕约 500 份架构决策记录做了 150 次运行:正确率没有拉开差距,skill 带来的成本节省,约三分之二用一句规则就拿到了。
这份周报的另一条线也很实用:让架构建模工具分析自己的仓库,再用结果暴露语言和布局的缺口。对程序员来说,它值得读的地方,是把提示词、工具、知识维护和工程验证拆开看,避免把所有改善都算到 agent 头上。
一句规则为什么能拿到大部分收益
karasu 是受 C4 model 启发的文本架构建模语言:用 .krs 文件描述系统,再生成系统、部署和团队结构视图。作者表示,项目代码全部通过 Claude Code 编写。
项目积累了约 500 份 ADR,也就是记录「当时为什么这样设计」的架构决策文档。agent 原来的查找方式,是先读索引,再打开具体记录。作者想知道,换成关键词搜索和反向引用查询,回答会不会更准、成本能不能更低。
实验有三个条件:R 是原有方式,RS 增加检索 skill,RN 则只在 CLAUDE.md 增加一句:
don't read the index files.
作者固定 karasu commit,使用 Opus 5.5,以 Claude Code 无界面模式执行 10 个任务,每种条件各重复 5 次,共 150 次。答案交给子 agent 评判;评判前打乱报告,并遮掉可能暴露实验条件的词,减少裁判受方案名称影响的可能。
结果是,三组正确率都已触顶,skill 没有继续提高正确率。差别出现在成本和耗时:RS 节省的成本中,约三分之二来自 RN 那一句规则,脚本贡献剩下三分之一。
先消除低效的信息读取路径,可能比增加工具更划算。
不过,工具还改善了指令执行。RN 的 50 次运行中,有 8 次仍读取索引;RS 只有 1 次。只说「别走这条路」,不如同时提供一条方便的替代路线。
实验也提醒人别迷信单次跑分。早期每个任务只跑一次时,RS 比 R 便宜 28%;重复到 5 次后,差距收窄到 20%。
还有一个比搜索方式更深的问题:部分回答推荐了已经被替换的按钮 CSS class。R、RS、RN 分别出现 2/5、1/5、3/5 次。新 ADR 虽然记录了替换,旧 ADR 的状态却仍是 accepted。作者据此判断,问题更可能出在知识状态维护上。这个判断有道理,但实验没有进一步隔离验证。
给自己的仓库画图,能发现什么
作者把 reverse-architecture skill 指向 karasu 自己,让它读取仓库并生成 .krs 模型,最终得到 4,453 行内容。
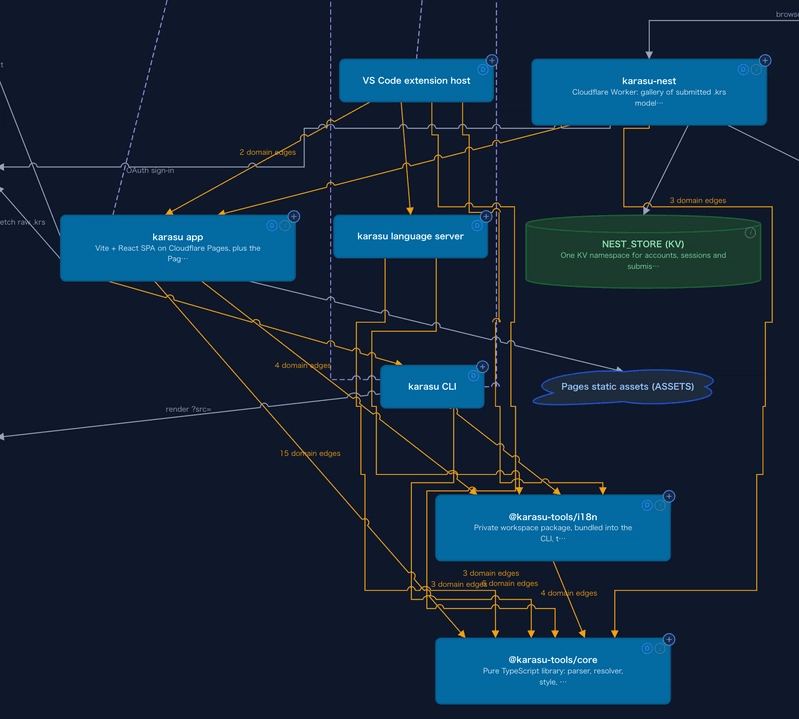
这里有个容易误读的地方:模型中的 service 不一定是独立部署的网络服务。karasu 是 monorepo,里面并列存在 CLI、库、Visual Studio Code 扩展、浏览器 SPA 和图库 Worker。agent 将各个包建模为 service,再向下拆分领域职责。
模型共有 10 个 service,其中 3 个是外部服务:Anthropic API、公共网络和 GitHub。只有应用的聊天功能会在用户提供自己的 API key 时调用 Anthropic API,解析和绘图不调用它。
作者之前分析的 umami 是一个 Next.js 应用,模型有 10 个领域、135 个用例、26 个实体,实体几乎都是数据库表。karasu 只有一个 KV namespace 存储,agent 却把语法树、诊断信息等内存结构也建成实体,实体数量约为前者的十倍。
这说明生成的模型可以帮助阅读代码,但实体数量不能直接用来比较两个系统的复杂度:建模口径已经变了。
作者没有手工修正输出。整个会话及其 19 个子 agent 的费用,来自日志 token 用量按 API 标价估算,并非实际账单。其中 13 个领域子 agent 并行运行,各耗时 2.4 至 5.3 分钟;该阶段整体耗时 14 分钟,约占成本四分之三。日文副本使用 Sonnet 翻译,作者称成本较低,但原文没有给出完整费用表。
真正推动产品修改的,是 13 个子 agent 中有 6 个分别发现:用例无法引用客户端存储。浏览器的 OPFS、localStorage,以及 CLI 和扩展读写的本地文件,都无法完整表达。
新增语法给客户端资源赋予 ID,再由用例引用:
client WebApp [web] {
  resource opfs ProjectIndex "/meta/projects.json"
}

usecase RenameProject {
  label "Rename a project"

  resource WebApp.ProjectIndex {
    operations write:update
  }
}
关键是 resource WebApp.ProjectIndex,它把「重命名项目」和具体存储资源连接起来,operations write:update 则说明操作类型。从 Issue、设计、ADR 到实现用了四天;该语法仍属实验性质,语言版本保持 2.0。
图画出来以后,还得让人看得懂
karasu 的实体视图会把当前领域关联的外部实体一起画出,并降低其视觉强度,称为 ghosts。此前所有 ghosts 都排在领域框下方的一行,数量一多,图就变成横向长卷。
Dify 的 IdentityAccess 曾有 101 个 ghosts,生成的图达到 36,053 × 1,372 像素,宽高比约 26∶1。karasu 自己的 Language 领域也有 29 个内部实体、44 个外部关联实体,终于让作者提高了这个问题的优先级。
新布局按所属领域分组:引用当前领域的放上方,当前领域引用的放下方;双向关联按关系较多的一侧放置;单个 ghost 不单独套框,行宽达到预算就换行。框和卡片还会按连接对象的横向位置排序。
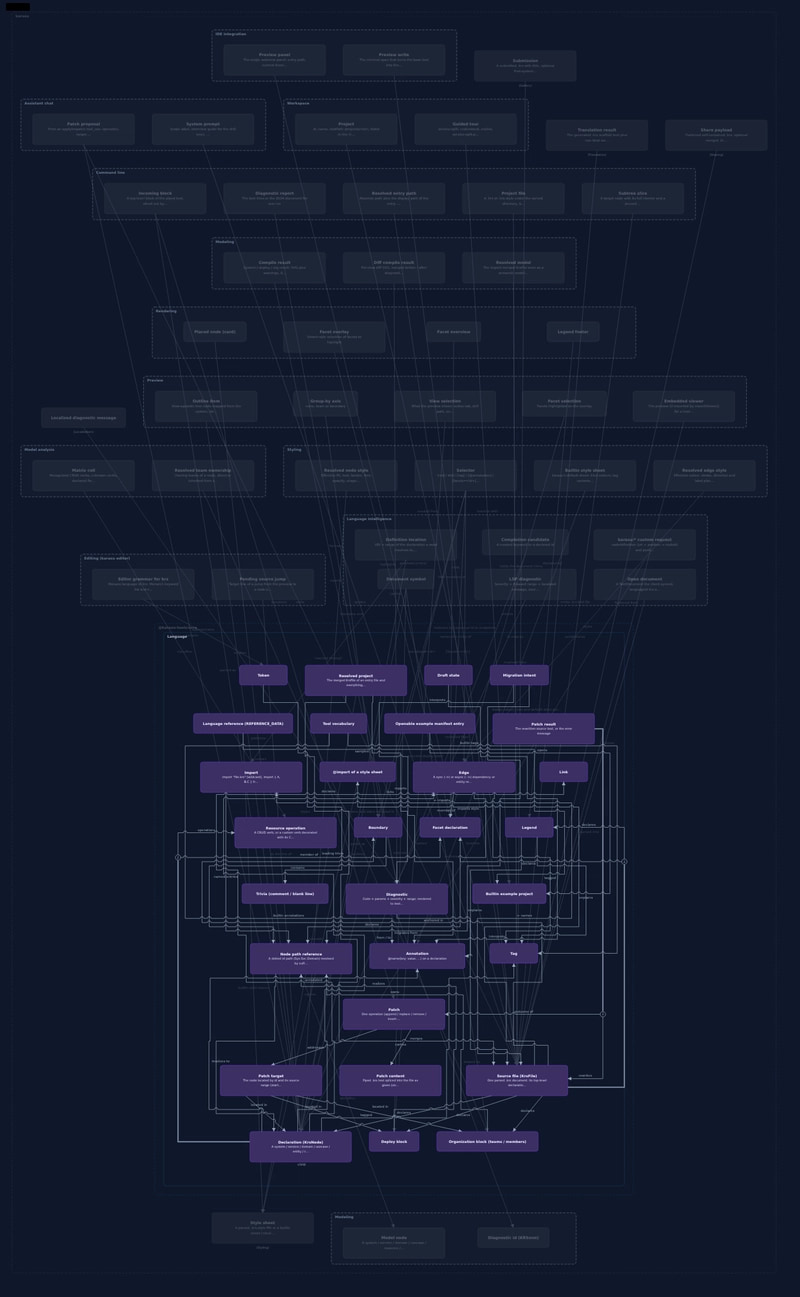
作者在 Dify、Twenty、WordPress 三个模型上测量:82 张包含 ghosts 的实体视图中,宽高比超出 16∶9 到 9∶16 范围的数量,从 51 降为 0。IdentityAccess 缩成 4,360 × 3,514 像素。这个数据证明布局更紧凑,但尚不能证明关系更容易读懂,ghost 连线目前仍是直线。
工程流程也在补类似的缺口。约 1,700 张图的绘制测试发现两个 compare mode 问题;模拟 Cloudflare Pages 的永久链接测试发现,固定返回 404 或 413 的响应没有被缓存。公共图片导出曾直接把背景颜色参数写入 SVG,现在只接受十六进制颜色,white 等名称会回退为默认白色。
我的判断
我最认同的是作者把「回答正确」「读取成本」「指令是否遵守」分开测量。很多 skill 演示只展示成功案例,这次至少做了重复运行和条件遮蔽。
但它还不足以支持「一句话能替代大多数 skill」。任务只有 10 个,正确率已经触顶,评判依赖子 agent,详细题目和成本数据还没公布。更难的跨 ADR 推理任务会怎样,原文没有回答。skill 将迁往 adr-tools,计划增加搜索、反向引用命令,并作为 Claude Code plugin 提供,目前也不能写成已经交付。
相比单纯调整提示词,我更看重旧 ADR 状态的问题。当前代码检索、明确的替代关系和决策失效标记,都是值得比较的做法,但作者没有给出这些方案的对照数据。一次查找成功,不等于找到的结论仍然有效。
自动化合并和发布也有边界。本周 11 个 Low PR 全由 low-pr-merger[bot] 合并,但新增站外链接会升级为 Medium;回看自 9 月以来涉及 ADR 或 TPL 的 380 个 commit,有 37 个会被升级。发布流程则拆开了持有 npm token 和安装依赖的任务,由作者对比本地构建后通过 2FA 批准。不过,批准后的发布流程尚未实跑,11 月 29 日才计划首次执行。设计合理,运行可靠性仍待验证。
能拿来做什么
- 给前端或 Node 仓库增加 ADR 检索 skill 前,先比较现有流程、单条规则、规则加工具三种方式,并重复执行同一组任务,分别记录正确率、成本和违规读取次数。
- 替换组件规范、CSS class 或技术方案时,同步更新旧决策的状态和替代关系,减少 agent 从历史文档中拿到过期结论的机会。
- 用仓库逆向建模辅助梳理 monorepo 职责时,先统一 service、领域和实体的含义,再核对关键依赖与存储读写,避免把生成结果直接当成完整设计文档。
- 顺序合并多个修改 lockfile 的机器人 PR 时,检查其 base 是否仍匹配最新 main。作者的三个 PR 因来自同一 base,squash 合并没有冲突,却产生了 66 行重复内容,最终导致构建失败。