用策略映射适配图像模型并实现失败兜底
文章用代码展示如何在用户意图与模型调用之间加入策略映射,针对不同图像模型调整提示词重点。AI 调用失败时,通过确定性逻辑生成可用提示词。
AI 深度解读
同一个画面描述,换个图像模型,效果可能就变了。作者给出的办法,是在用户需求与模型之间加一层「模型策略」:主体保持一致,再按目标模型补上不同的表达重点,用共享骨架组装提示词,最后交给 LLM 润色。
这篇更值得程序员看的,是它的工程取舍:模型差异如何维护,AI 服务失败后怎样继续交付,以及示例库怎样帮助用户验证效果。不过,代码能证明流程跑得通,不能证明作者对七个模型的判断都经过了充分测试。
七个模型,为什么不维护七套模板
作者用一个简单需求贯穿全文:木桌上的陶瓷咖啡杯,旁边放着笔记本电脑,晨光从窗户照进来。切换模型时,这些内容无需变化,需要调整的是提示词的强调顺序。
他们把差异放进 MODEL_STRATEGY,每个模型对应一句策略:
GPT Image 2强调现实知识、准确文字、精确构图和细节一致性。GPT Image 1.5强调摄影真实感、自然光、清晰主体,并减少复杂文字。Nano Banana Pro强调创意探索、复杂场景、多图融合和风格化。Seedream 5 Pro强调可控编辑、可读文字、局部修改和商业设计。Seedance 2.0强调关键帧、分镜、动作节点、镜头语言和运动方向。Grok Imagine强调社交传播、视觉反差和一秒内能抓住注意力的画面。Gemini 3 Pro强调复杂指令、多模态推理、信息结构和长上下文一致性。
这些是作者采用的策略描述,原文没有提供逐项验证它们的对照实验。
策略表解决的是维护问题。七套完整模板容易各自演化:公共构图规则修了一处,其他六处可能还留着旧版本。抽成共享骨架后,公共要求集中维护,模型差异也更容易审查。
先集中管理差异,再讨论哪种提示词更有效。
共享骨架怎样容纳模型的特殊要求
本地生成器接收 subject、model、ratio,把主体、目标模型、策略、画幅比例和公共约束拼成提示词。下面这段代码完整展示了作者的做法:
function buildLocalPrompt({ subject, model, ratio }) {
  const lines = [
    `Subject: ${subject}`,
    `Target model: ${model}`,
    `Model strategy: ${MODEL_STRATEGY[model] || "Create a high-quality visual result based on the model's strengths."}`,
    `Aspect ratio: ${ratio}`,
    "Composition: clear subject, readable foreground/midground/background layers, enough negative space, complete lighting and material details.",
    model === "Seedance 2.0" ? "Seedance keyframe note: write a single image as a video keyframe with a clear action moment, motion direction, lens focal length, and dynamic tension." : "",
    model === "Seedance 2.0" ? "Optional storyboard extension: for video, add 3-5 shots and specify framing, subject action, camera movement, duration, and transition for each shot." : "",
    "Text rule: if text appears in the image, keep it short, readable, and naturally integrated with the layout.",
    "Quality rule: no watermark, no extra distortions, no broken fingers, wrong perspective, messy background, or low-quality texture.",
    "Replaceable variables: swap [subject], [brand/person], [scene], and [text] with your specific need.",
  ];
  return lines.filter(Boolean).join("\n");
}
重点看最后的 filter(Boolean):模型专属规则不适用时返回空字符串,最终统一过滤,共享流程无需复制。遇到未知模型,策略行还有通用描述兜底。
Seedance 2.0 的条件行要求把静态图当作视频关键帧,补充动作瞬间、运动方向、焦距和动态张力;如果扩展成视频,再给出 3-5 个镜头,逐个说明取景、动作、运镜、时长和转场。
末尾的 [subject]、[brand/person]、[scene]、[text] 则提示用户哪些内容可以替换。它只提供替换说明,并没有实现变量插值。
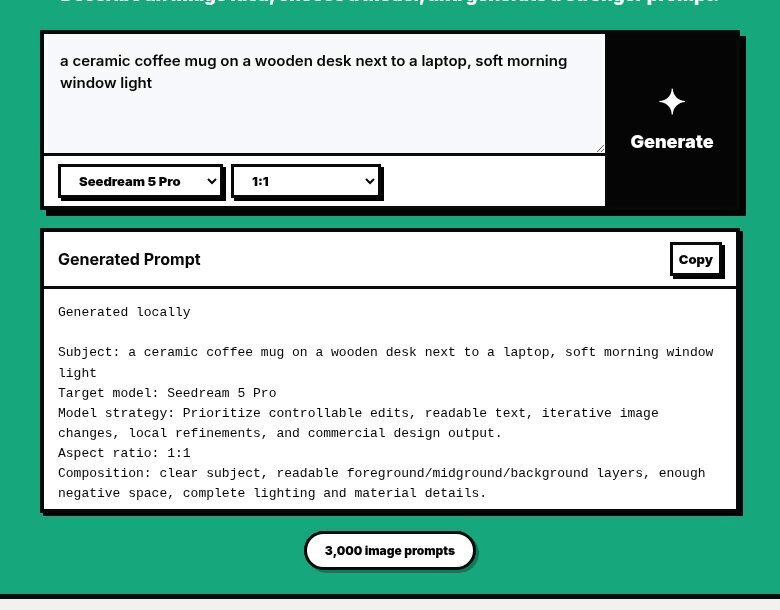
工具支持中文和英文输出,以及 1:1、4:5、9:16、16:9 四种比例。比例会写进提示词,但原文没有展示把它转换成各家图像服务原生参数的过程,不能据此认定最终图片一定按指定尺寸生成。
AI 负责润色,本地规则负责保底
作者在 Cloudflare Worker 中提供 /api/generate-prompt,将相同的主体、目标模型、比例和模型策略发给聊天模型,生成更自然的提示词。
系统指令要求只返回最终提示词,不加解释、Markdown 或标题,并覆盖场景、构图、镜头、光照、材质、风格、文字规则和质量约束。生成参数是 max_tokens: 900、temperature: 0.75。这些是作者的配置选择,原文没有展示参数比较。
入口也做了约束:Origin 必须在 ALLOWED_ORIGINS 中,否则返回 403;主体去除首尾空白、合并空白字符后,限制为 3,000 个字符;模型名上限为 80,比例上限为 20。缺省模型和比例分别为 GPT Image 2、1:1。
真正决定失败体验的是客户端这段代码,它在请求 AI 前先生成本地结果:
async function generatePrompt() {
  const localPrompt = buildLocalPrompt({ subject, model, ratio });
  try {
    const prompt = await requestGeneratedPrompt({ subject, model, ratio });
    render(prompt, "Generated by AI");
  } catch {
    render(localPrompt, "Generated locally");
    showToast("Live generation failed. Showing a local prompt instead.");
  }
}
要看的是 try 之前的 buildLocalPrompt:上游密钥过期、触发限流或网络失败后,页面仍有可复制的内容,并用 Generated by AI、Generated locally 区分来源。
AI 调用失败后,用户仍然能拿到一份结构完整的提示词。
但标题里的「永不失效」需要收窄理解。代码没有展示超时控制;请求一直不结束,就不会进入 catch。它也没有展示成功响应的内容校验,空结果或不合要求的文本是否触发回退,原文没说清。
作者还把真实示例放在生成器下方,帮助用户检查提示词与画面的对应关系。
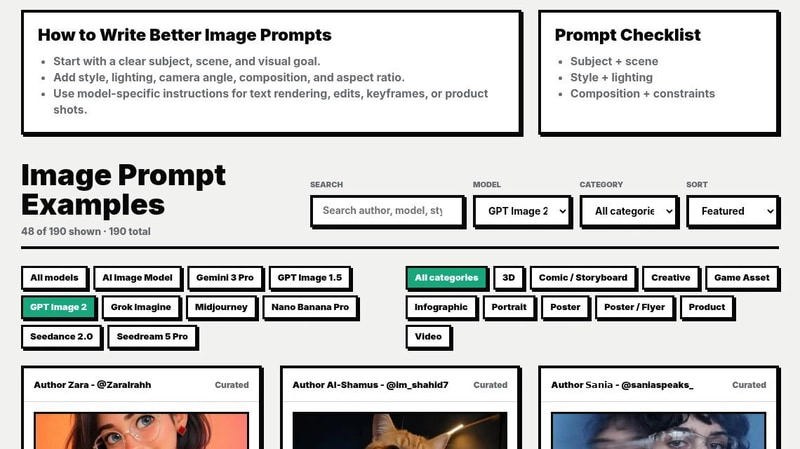
索引收录了 3,493 条提示词,支持筛选、排序,以及按作者、模型或关键词搜索。数据按模型拆成 JSON 文件,通过 IntersectionObserver 随滚动延迟加载,避免首屏下载整个库。
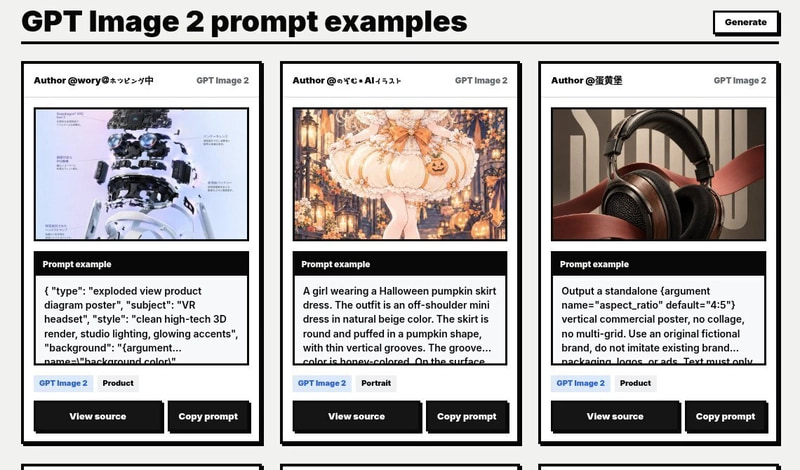
卡片保留作者和来源,首页的 Try it 按钮能把示例复制到生成器,再修改模型或比例。作者也提醒,商业复用前应检查对应来源;注明出处不等于获得授权。
我的判断
我认可它把可预测规则与生成式润色拆开的做法。对于提示词工具,本地结果已经能交付核心价值,LLM 可以改善措辞,产品也就不必把全部可用性押在一次远程请求上。
相比七套独立模板,这种结构更容易保持公共规则一致。不过,「每个模型一句话」适合表达风格偏好,未必足以覆盖不同服务的能力边界。如果以后涉及原生尺寸参数、编辑接口或不同输入格式,还需要独立的适配代码。
效果判断则要保留。原文没有同一主体的七模型成图对照,没有盲评、重复生成记录,也没有失败率数据。「自然段提示词通常更好」和各模型擅长什么,目前只能视作作者的经验。示例库能帮助理解,却不能替代控制变量的比较。
安全上也有一个明确边界:Origin 白名单可以限制浏览器中的跨站调用,但不能充当身份认证,非浏览器客户端可以构造这个请求头。若接口要承担公开流量,还得结合实际需求考虑鉴权、限流和额度控制。
能拿来做什么
- 做多模型提示词工具时,可以先抽出共享骨架,把模型偏好集中到策略表中维护;用固定的一组需求比较修改前后的成图,再决定策略是否保留。
- 在前端接入 AI 润色时,可以提前生成本地版本,并明确显示结果来源;同时补上请求超时和响应校验,让回退条件覆盖真正影响使用的情况。
- 用 Node 或 Worker 包装生成接口时,可以参考原文的字段长度限制、默认值和纯文本输出约束,再按业务补充模型白名单与访问控制。
- 建立提示词示例库时,可以同时展示图片、完整提示词、作者和来源,并按模型拆分加载;让用户有依据地修改提示词,也能追溯复用条件。