让无历史上下文的 AI 审查开发方案
文章实测 Elephant-Goldfish 工作流:先由长会话梳理设计文档,再让全新 AI 会话仅依据文档和关联文件独立审查。案例报告了 26 项发现,其中 2 项误报,同时仍有 2 个缺陷未被发现。
AI 深度解读
AI 陪你讨论一个功能越久,就越了解你的想法,也越容易沿着同一套假设继续推演。原文介绍的 Elephant-Goldfish Model(EGM),就是让一个保留上下文的会话负责写方案,再让多个没有历史记录的新会话挑错,最后由人决定怎么改。
作者拿一个 npm 包健康检查 CLI 做了实验:首轮审查提出 26 条问题,其中 2 条判断错误;最终实现首次通过 24 项测试,却仍有两处问题没被审查发现。这套流程值得借鉴的地方,是让需求漏洞提前暴露,同时留下了很明确的能力边界。
为什么审方案的 AI 要先忘掉讨论过程
按原文介绍,Google 在 10 月 22 日开源了 EGM,采用 Apache 2.0 许可证,Google 称已有数千名员工每天使用。它支持 Claude Code、Codex 和 Google 的 Antigravity,但本文实际展示的是 Claude Code 流程。
EGM 把工作分给两类会话:
Elephant 保留完整上下文。你和它讨论 20–30 分钟,把目标、规则和待修改文件整理成设计文档,暂时不写代码。Goldfish 则从空白开始,只读设计文档及其引用文件,检查陌生人能否理解和实现。
审查者不知道你当初怎么想,文档里没写出来的前提才更容易露馅。
流程是先写方案,再用新会话审查,由人筛选意见并修改;重复到只剩小问题,再交给另一个新会话实现,最后运行测试和实际试用。
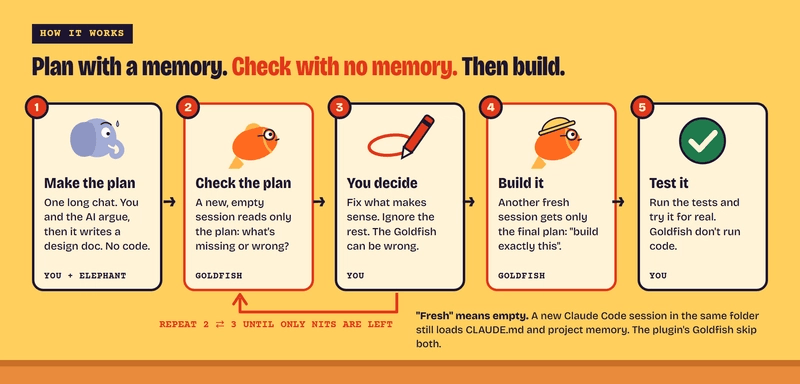
这里的「新会话」必须足够干净。原文提醒,在同一个项目目录启动 Claude Code,仍会自动加载 CLAUDE.md 和项目记忆。没有聊天记录,不等于没有既有立场。
插件通过隔离的子代理执行审查,只提供方案及关联文件。手动尝试时,可以把方案复制到空目录,或在关闭记忆的聊天应用里开启新对话。原文给出的三类问题也很实用:先让它复述目标,再找错误假设和边界情况,最后判断信息是否足够一次完成实现。每个问题都用新会话提问。
26 条意见里,真正有用的是哪些
实验项目叫 pkg-pulse,用来判断一个 npm 包是否仍在维护。初稿的核心设计如下:
## Verdict rules
- DEAD: latest version is deprecated, OR the GitHub repo is archived.
- SLOWING: no release and no push for more than 180 days.
- ALIVE: anything else.

## Design
- Run the three requests in parallel with `Promise.all`.
- Exit code 0 for ALIVE, 1 for SLOWING, 2 for DEAD, so it works in CI.
重点看 ALIVE: anything else:当数据不完整时,它也可能把包归为正常。
作者通过 claude --plugin-dir ./elephant-goldfish-model 临时加载插件,再执行 /egm:egm-review docs/designs/pkg-pulse.md,选择 consolidated report。五个阶段依次审查,覆盖架构师、新人、严厉的设计评审者、再次拉远视角的架构师和负责实现的技术负责人,共派出 9 个只读 Goldfish。
14 分钟后,作者得到 6 份报告、26 条意见,分为 9 个 blocker、9 个 major 和 8 个 nit,也就是阻塞项、主要问题和细节意见。最有价值的发现有三个。
首先,没有 GitHub 仓库的包怎么办?初稿没规定缺少 GitHub 数据时的行为,工具可能直接输出 ALIVE。一个专门检查维护状态的工具,却把未知情况包装成正常,判断规则就失去了可信度。
其次,「最后发布」到底读取哪个时间?作者检查的 time.modified 显示 2026 年 7 月,但最后一次真实发布发生在 2020 年 2 月。元数据发生修改,不代表发布了新版本。
最后,退出码发生冲突。SLOWING 使用 1,Node 程序崩溃也可能退出为 1。CI 只能看到同一个数字,无法区分依赖维护变慢和检查工具执行失败。
这些发现都落在输入缺失、字段含义和调用约定上。日常写 Node 工具时,它们经常比代码能否运行更影响结果是否可靠。
测试全绿,为什么仍然漏了两处问题
作者没有照单全收:26 条意见中修复了 20 条、跳过 4 条,另有 2 条判断错误。比如,有意见要求为这个小 CLI 增加正式的「备选方案」章节,作者认为没有必要。
关于 scoped package,审查意见认为 @tanstack/react-query 中的斜杠必须编码成 %2F,作者实测两种形式都被 npm 接受。对于 GITHUB_TOKEN,不同 Goldfish 也有分歧:一方认为不需要,另一方认为共享 CI runner 容易耗尽 GitHub 每小时 60 次的请求额度。作者最终保留了它。
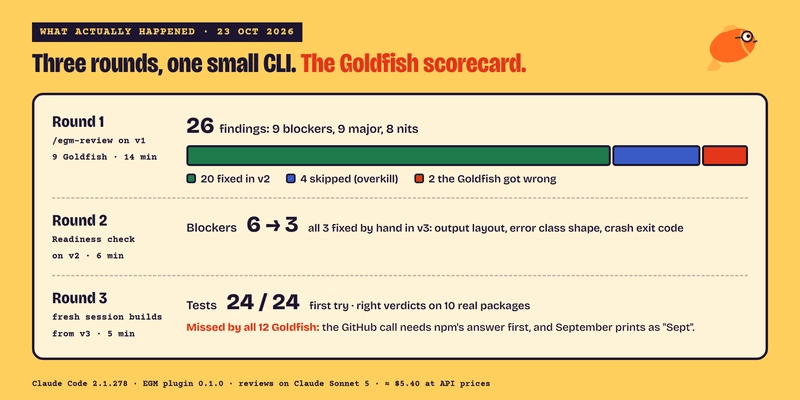
第二轮只运行技术负责人审查阶段,涉及 3 个 Goldfish,阻塞项从 6 个降到 3 个,作者确认后全部手动修复。因此,首轮总计 9 个 blocker 与后面的「6 降到 3」属于不同统计范围,不能直接当成同一个指标。
最终,新的 Claude 会话按方案实现,5 分钟生成 6 个文件,首次通过全部 24 项测试。实跑时,esm 3.2.25 每周下载量仍有 4.1M,却因 GitHub 仓库归档而判为 DEAD;request、node-sass 也为 DEAD,formik 为 SLOWING,react-hook-form 和 @tanstack/react-query 为 ALIVE。这些是作者当次运行结果,不应当作持续有效的包状态查询。
两轮共 12 个 Goldfish 仍漏掉了两处问题。
一处就在初稿的 Promise.all:GitHub 地址需要从 npm 响应中取得,相关请求有先后依赖,不能把三个请求直接一起启动。作者在修改 v2 时自己发现了它。
另一处来自真实输出。Node 24 的英式英语日期会把九月写成 Sept,例如 15 Sept 2026,多出的字母让对齐偏移。技术负责人审查时用十一月示例确认过日期格式,仍没有覆盖这个情况。
文档审查能发现描述里的漏洞,执行结果还得靠测试和实跑验证。
我的判断
我认同它把「方案能否独立讲清楚」作为检查目标。设计文档也是一种接口:实现者需要什么信息,就应该把什么信息写进去,而不是依赖聊天记录里的默契。对接口降级、第三方数据和 CI 工具,这种检查尤其有价值。
但一次小项目实验,证明不了 EGM 比普通代码审查或单轮 AI 审查更划算。作者没有提供对照组,也没有统计节省了多少返工时间。Rensin 提出的「约 30% 建议高度有价值」是经验判断;本次修复 20/26 条,也可能反映初稿比较粗糙。
成本同样有前提:作者称完整审查耗时 14 分钟,使用 Claude Sonnet 5,按 API 价格约 $3.40;订阅用户则消耗套餐额度。测试环境是 2026 年 10 月 23 日的 Claude Code 2.1.278、EGM 0.1.0、Node 24.19.0,不能据此推定其他项目的耗时和效果。
实际取舍上,普通团队可以先尝试一次干净会话审查。涉及跨系统约定、缺失数据或复杂边界,再考虑多阶段流程。原文也明确提到,Google 文档不建议把一次就能修好的简单 bug 强行纳入设计优先流程。
能拿来做什么
- 开发需要调用外部服务的 Node 工具前,先写清数据缺失、请求失败和业务异常分别如何输出、如何退出,再让空白会话逐项找歧义。
- 给 AI 一份设计文档,让它先复述目标,再判断能否独立实现。如果它必须追问,你就得到了需要补充的信息清单。
- 每周都要做方案审查时,可以尝试
claude plugin marketplace add google/elephant-goldfish-model和claude plugin install egm@egm。按原文要求,Claude Code 至少需要 2.1.271,旧版本无法向 Goldfish 隐藏 CLAUDE.md。 - 把审查意见转成可验证的问题。接口编码用实际请求确认,日期格式用边界月份验证,请求并行先检查数据依赖;不要把「AI 已审过」当作通过依据。