60次VEX测试揭示本地代码模型准确率短板
在16GB RTX 5070 Ti上,Qwen2.5-Coder 7B与14B各完成30次Houdini VEX测试,首轮均仅通过5次;最多两次反馈修复后分别通过8次和11次。研究保留全部156段生成代码,但仅覆盖受控点属性任务。
AI 深度解读
把 Ollama 接进 Houdini,让本地模型生成 VEX,接口确实能跑通;但代码返回得快,不代表能直接用。作者在一张 16GB RTX 5070 Ti 上做了 60 次固定测试,两个模型的首次成功率都只有 5/30,最多修复两轮后才分别升到 8/30 和 11/30。
这篇最有用的地方,是把「接通接口」「编译通过」「结果正确」拆开验证。对正在给开发工具接 AI 的程序员来说,这套检查方法比模型选型结论更值得带走。
60 次测试,到底验证了什么
作者使用 Windows 11、Ryzen 9 9950X、64 GB RAM,显卡是 RTX 5070 Ti,驱动 617.42 报告显存为 16,303 MiB。执行环境是无界面的 Houdini 22.0.429,通过 hython 使用自带的 Python 3.13;Ollama 固定在 0.13.2,由其运行时选择 CUDA 13。
测试对象是 Qwen2.5-Coder 7B 和 14B,固定模型摘要前缀分别为 dae161e27b0e、9ec8897f747e。作者明确说,这不是最新模型推荐。
任务在推理前冻结,任务说明和原生校验器都记录了 SHA-256。每个模型完成十项任务,每项使用种子 11、23、47,共 30 次,两者使用相同的轮换顺序。参数为 temperature 0.2、top-p 0.9、context 8192,每次最多生成 768 tokens。
任务包括高度遮罩、高度着色、安全归一化法线、整数 ID 缩放、径向 smoothstep 衰减、指定右手系 Y 轴旋转、根部固定的风动、正弦地形、点组归属,以及包含零尺寸回退的包围盒 UV。它们是受植物制作启发的属性数学练习,没有使用生产花园资产。
每段代码原样放入逐点执行的 Attribute Wrangle,分别跑过 45 点网格、37 个确定性扰动点和 9 个边界点。边界包含零法线、X 方向退化包围盒;时间固定为第 13 帧、24 fps,对应 @Time = 0.5。
独立 Python 参考实现检查数值,绝对误差容限为 2e-5,还检查向量分量数、有限值、点数、输入是否保留,以及有没有多写属性或点组。三个数据集必须全部通过。校验器先接受了十个正确控制样例,并拒绝了四个故意错误的样例。
这套设计回答的是一个很窄、但可检查的问题:模型能不能在明确约束下,写出结果正确的 VEX。
编译通过,为什么还不能算成功
首次生成时,7B 有 7/30 能在全部测试数据上编译,但只有 5/30 正确;14B 的编译通过和正确结果都是 5/30。仅检查编译,会给 7B 多放行两个错误结果。
错误也不只是语法问题。有的回答使用未定义变量或虚构函数;有的声明了局部 height_mask,却没有正确写入目标属性;还有代码在要求保留位置时修改了 P。旋转任务中,模型把 rotate 当成接收并返回点向量的函数,Houdini 不接受这个签名。
能编译,只证明代码跨过了语法和类型检查,没有证明它完成了任务。
失败后,作者把原生编译信息或数值差异反馈给模型,反馈最多 3500 字符,同一对话最多尝试三次,也就是初次生成加两次修复。最终 7B 达到 8/30,14B 达到 11/30;全部 156 段生成代码都原样保留,没有人工补丁。
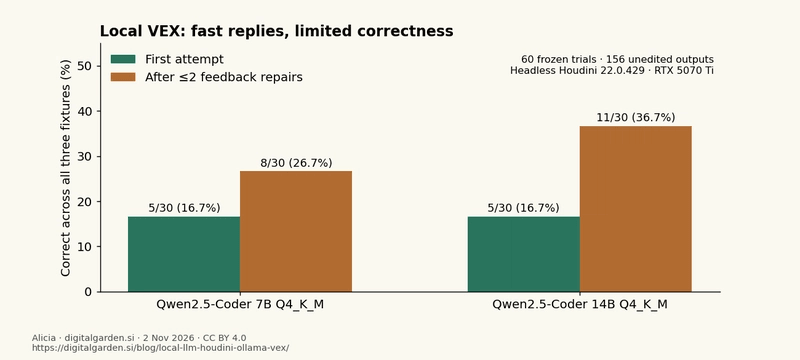
任务差异很明显:正弦地形任务,两者首次都三次全过;径向衰减、根部固定风动和 UV 任务,两者在三个种子下用完修复机会也都未通过。有些修复还重复了原来的错误代码。
作者把后一个指标称为「反馈后成功」,没有包装成 pass@k。原因是修复依赖前一轮的代码与报错,并非相互独立的采样。每项只有三个种子,也不足以支持广泛的模型排名。
接口能跑通,还要处理响应、代理和阻塞
作者另起了一个 Ollama 服务,使用专属模型目录,只允许一个并行请求、一个常驻模型。地址为 http://127.0.0.1:11435,区别于默认端口 11434,没有修改工作站的全局 Ollama 或代理配置。
下面这段标准库客户端解决了三个实际问题:关闭流式返回、检查响应是否完成,以及为本地请求绕过继承的代理。
import json
import urllib.request
import urllib.error

API = "http://127.0.0.1:11435"
opener = urllib.request.build_opener(urllib.request.ProxyHandler({}))

def chat(model, messages, timeout=180):
    body = {
        "model": model, "messages": messages, "stream": False,
        "keep_alive": "5m",
        "options": {"temperature": 0.2, "num_ctx": 8192,
                    "num_predict": 768},
    }
    request = urllib.request.Request(
        API + "/api/chat", data=json.dumps(body).encode("utf-8"),
        headers={"Content-Type": "application/json"},
    )
    try:
        with opener.open(request, timeout=timeout) as response:
            data = json.load(response)
    except urllib.error.HTTPError as error:
        raise RuntimeError(
            f"Ollama HTTP {error.code}: "
            + error.read().decode("utf-8")
        ) from error
    if data.get("error"):
        raise RuntimeError(data["error"])
    if not data.get("done"):
        raise RuntimeError("Incomplete response")
    return data["message"]["content"], data
要看准最后一行:/api/chat 的文本在 message.content,generate API 才使用 response。两者都支持流式输出,不能把流式的逐行 JSON 当成一个完整 JSON 文档读取。
代理问题也有实测支撑:同样 GET /api/version,继承代理的 opener 返回 502,直连 opener 返回 200,版本为 0.13.2。ProxyHandler({}) 只影响这个客户端,不会关闭系统代理。
在应用代码时,作者通过控制器设置 Wrangle 的 snippet,读取原生几何结果后再检查。下面是正式试验 1 中被接受的、未经修改的 14B 着色代码:
float t = clamp(@P.y / 1.5, 0, 1);
@Cd = lerp(set(0.05, 0.20, 0.03), set(0.80, 0.30, 0.10), t);
这里要看 @Cd:它写入颜色,位置 @P 只参与计算。演示中的 Python SOP 真实请求了本地服务,返回 READY 并保留 60 个输入点;HIP 保存、重开后又检查了点数和颜色属性。
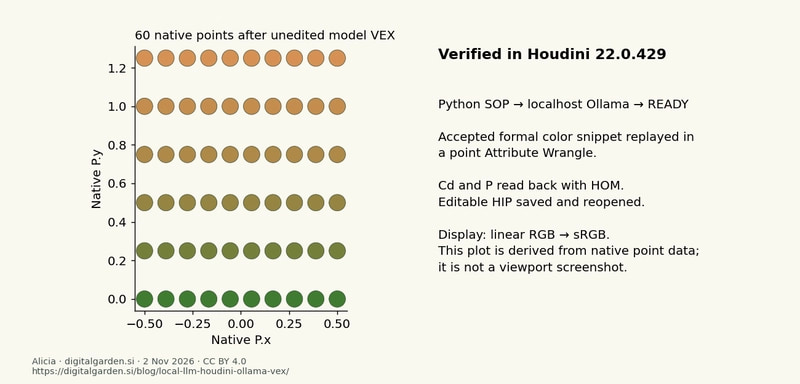
这张图是原生点数据经过 linear-to-sRGB 转换后的绘图,不是视口截图。保存的 Python SOP 重放已验证回复,打开文件不会自动启动推理。同步 HTTP 会阻塞 Python cook,作者没有测试带线程的 GUI 控制器。
我的判断
我更认可这篇的验证方式,而不是把它当成「14B 比 7B 好多少」的选型依据。作者保留失败代码、设置边界数据、检查额外副作用,还主动说明 Codex 协助了实现、执行、检查和写作,计数来自保存的原生结果。这让结论有了可追查的依据。
比起只做语法检查,数值参考实现更贴近任务是否完成。但这也有前提:这些题的正确答案可以独立计算。换成开放式视觉效果或复杂生产资产,验证器不会自动长出来,评估成本可能更高。
14B 的反馈后结果更好,是这组任务里的实测;它是否比其他本地模型、云端模型或人工编写更划算,原文没有对照数据。
显存也不能扩大解读。14B 报告的 Ollama 常驻分配为 10.118 GiB,取自 /api/ps 的 size_vram 除以 2³⁰。这既不是驱动峰值,也不能证明剩余显存足够维持生产视口。200 ms 间隔的 nvidia-smi 日志因异步追加产生畸形 CSV,作者排除了这份峰值诊断。
延迟同样有边界:统计包含每个模型全部 30 次首次请求,包括失败;累计响应时间不含原生校验与交互,前缀缓存保持开启。冷预热中 32 秒与 2 秒的观察受到模型顺序和系统状态影响,不能推出 14B 普遍加载更快。
这篇证明了本地生成加原生校验的路径可行,没有证明它已经适合直接接管工作场景。
能拿来做什么
- 给 Houdini 或日常 AI 编程工具接生成能力时,先在隔离环境运行候选代码,同时检查结果和副作用。除了「能执行」,还要确认输入、数量和非目标字段是否被改动。
- 在前端或 Node 中封装 Ollama 客户端时,把 chat 与 generate 的响应结构、流式解析和 HTTP 错误分别处理。遇到本地连接异常,可以参照作者的方法检查代理路径,避免把网络错误误判成模型错误。
- 建立小型任务回归集时,提前固定提示词、参数、边界输入和判定标准,分别记录首次成功与反馈后成功,并保存失败输出。不要让人工修补后的结果冒充模型原始表现。
- 给工具增加「应用生成代码」按钮前,先补齐超时、取消、界面状态和场景校验。原文只验证了有边界的无界面流程,同步请求阻塞 cook 的问题仍需要产品实现解决。