英伟达扩展 Nemotron 开放权重模型
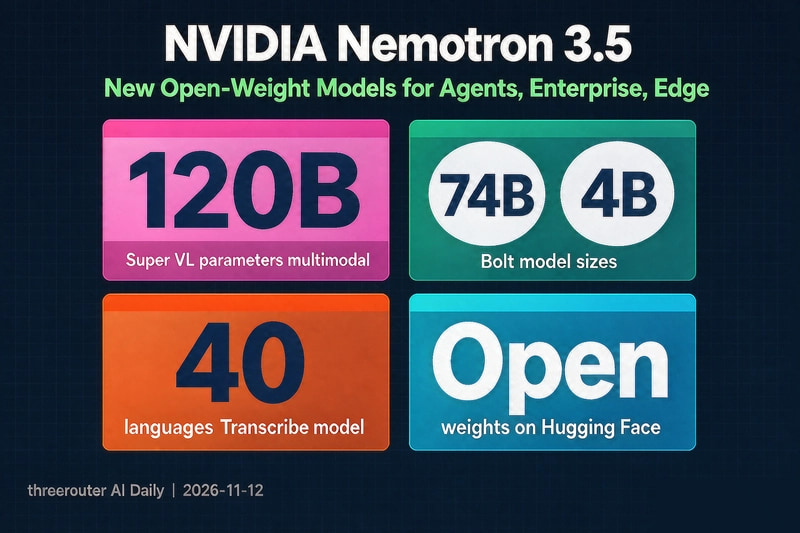
据素材介绍,英伟达发布 Nemotron 3.5 系列,涵盖 120B 多模态模型、74B 与 4B 模型,以及支持 40 种语言的 30B MoE 语音模型。权重发布于 Hugging Face;部分 Agent 基准领先及提速说法来自转述,摘录未提供测试细节。
AI 深度解读
NVIDIA 这次扩充 Nemotron 家族,重点是把不同工作负载拆开:多模态 Agent、企业任务、边缘部署和多语言语音,各有对应的 Nemotron 3.5 模型。原文称,这批模型的权重均已发布在 Hugging Face。
对程序员来说,值得看的是这些模型分别适合进入哪一类候选清单。至于「超过 Claude、GPT」「最高快五倍」的说法,原文缺少测试条件,还不足以支撑选型结论。
三类模型,解决的是不同问题
Nemotron 3.5 Super VL 是一个 120B,即 1200 亿参数的多模态模型,定位于专项 Agent 任务。 多模态指模型不只处理文字,但原文没有展开它支持哪些输入形式、如何接入工具,也没有给出具体任务示例。
Nemotron 3.5 Bolt 提供两种规模:74B,即 740 亿参数的版本面向较重的企业工作;4B,即 40 亿参数的高效版本名为 E4B,面向边缘设备和本地部署。两者让团队可以按部署位置和任务重量选择候选模型,但原文没有提供硬件要求或吞吐数据。
Nemotron 3.5 Transcribe 则面向语音,是一个 30B,即 300 亿参数的混合专家模型(MoE)。可以把 MoE 理解为由多个专家模块组成的模型架构;原文只给出了参数规模,没有说明每次推理实际激活多少参数。
「最高快五倍」,能直接当选型依据吗
原文援引 VentureBeat 和 Interesting Engineering 的报道,称 Super VL 在特定 Agent 基准上超过 Claude Opus 5 和 GPT-6.1 Sol,完成任务的速度最高可达五倍。
这里有两个限制:一是「特定基准」,二是「最高」。它没有列出基准名称、具体得分、运行硬件,也没有交代任务成功率和速度之间的关系。对于这些比较,原文提供的是媒体转述,并非作者展示的实测过程。
这条成绩可以作为进一步评测的线索,不能直接推导出所有 Agent 任务都更快、更好。
尤其是要把模型接入现有应用时,任务是否完成、工具调用是否正确、失败后能否恢复,都比一句速度倍数更接近实际需求。原文没有覆盖这些细节。
语音模型的信息更具体,但仍缺质量指标
Transcribe 支持转写、翻译和说话人识别,覆盖 40 种语言,训练使用了 463,062 小时音频。这些信息至少明确了它要解决什么问题,以及训练数据的大致规模。
不过,训练时长不是识别准确率。原文没有列出完整语言清单,也没有提供中文、口音、噪声环境下的表现,更没有说明是否支持流式处理。
因此,对需要语音功能的团队,它是一个值得核对能力的候选模型;对已经有线上转写服务的团队,这些数字还不足以构成迁移理由。
我的判断
这次发布的价值在于分工明确:Super VL 对应多模态 Agent,Bolt 覆盖企业与本地部署,Transcribe 专注语音。相比只看一个综合排行榜,这种划分更有助于缩小评测范围。
但开放权重也不等于已经解决了部署问题。原文只说模型已在 Hugging Face 发布,没有交代许可证条款、量化方案、推理框架和资源需求,不能据此判断商用限制或落地成本。
与直接调用托管模型 API 相比,自行部署通常需要团队承担更多运维工作。这篇短讯没有给出成本或质量对照数据,也没有呈现作者自己的使用经验。我的取舍是:把它当作候选模型索引,后续用自己的任务验证。
能拿来做什么
- 如果你正在开发 Agent,先整理一组真实任务,记录任务成功率和完成耗时,再评估 Super VL;不要直接把「最高五倍」写进项目收益预期。
- 如果应用需要本地或边缘推理,可以先核对 Bolt E4B 的模型说明、硬件要求和许可证,再决定是否做部署验证;4B 参数本身不能保证目标设备运行流畅。
- 如果产品需要语音转写、翻译或说话人识别,可以把 Transcribe 加入候选清单,先确认所需语言,再用真实录音检查质量。需要实时交互时,还要另行确认流式能力。