小型决策模型训练中的偏置与捷径
文章复盘 Gev 从预训练权重到决策模型的训练过程,重点讨论因果注意力盲区、选项位置偏置和模型投机。早期模型超过九成情况选择首个选项,作者据此介绍防止捷径学习的训练策略与分阶段流程。
AI 深度解读
一个 270M 参数的小模型,能否胜任分类、路由和候选项打分?Gev 团队给出的答案是可以尝试,但预训练权重并不能直接变成决策引擎。他们基于 Google 的 T5Gemma 2,目标是在单次 45 ms 推理内完成选项评分,训练中却先遇到了一个尴尬问题:模型超过 90% 的时候都选 Option 0。
这篇最有价值的内容,是作者如何拆掉模型的取巧路径:调整标记位置,让模型真正读到选项;打乱顺序,削弱位置偏见;再用教师模型的概率分布训练学生。对准备做业务分类器或 AI 请求路由的程序员,这些经验比参数规模更值得看。
预训练模型为什么还要再训练一次
作者把 Gev 的生命周期分成三个阶段:基础预训练、一次性决策训练、零样本部署。
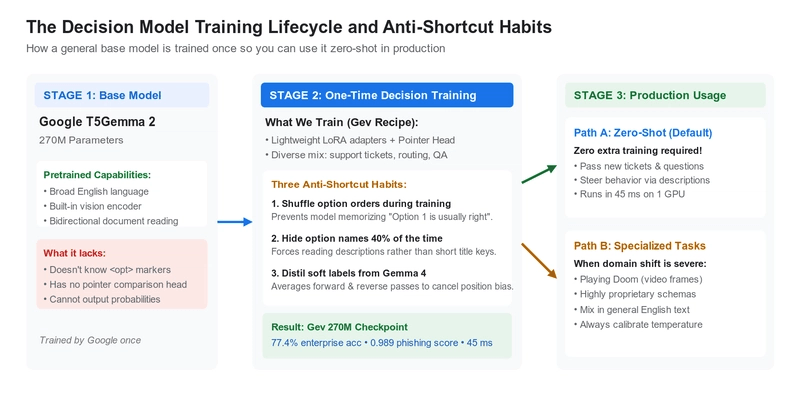
第一阶段是 Google 完成的 T5Gemma 2 270M 预训练。按原文描述,模型从数万亿 token 的网页、书籍、代码和图像中获得语言、代码及通用知识。它认识发票和数据库错误,却还不认识 <opt>、<decide> 这些专用标记,也没有负责比较选项的指针头(pointer head)。
知道一张发票是什么,与能按给定规则在几个候选动作中打分,是两种能力。
第二阶段才是作者的工作。他们冻结基础模型,用 LoRA(低秩适配)训练额外的小型适配层,同时训练指针头。训练任务混合了分类、路由和评分,让模型学会读取标记、比较问题与候选项,并输出概率。这样不用更新全部 270M 参数,也能减少训练显存需求及覆盖原有知识的风险。
第三阶段是部署。训练完成后,业务可以传入新问题和自定义选项描述,不必为每次新增类别更新权重。这里的「零样本」指部署时处理新任务,并不是模型从未接受过决策训练。
作者认为,只有切换到差异很大的领域,例如处理 Doom 游戏画面,才需要再次训练。不过,多大的变化算「差异很大」,原文没有给出判断标准。
一个标记放错位置,为什么准确率会掉到 35%
Gev 使用的是编码器与解码器架构,但原文讨论的评分位置处于解码器中。它的因果自注意力只能看到当前位置之前的内容。
下面是作者早期使用的格式,它展示了选项标记放在描述前面的写法:
<q> Is this invoice approved? <opt> approve: within budget <opt> reject: over limit <decide>
要看紧第一处 <opt>:模型到这里时,只读过问题,还没有读到 approve: within budget。如果指针头从这个位置取表示来评分,它就看不到自己负责的选项内容。
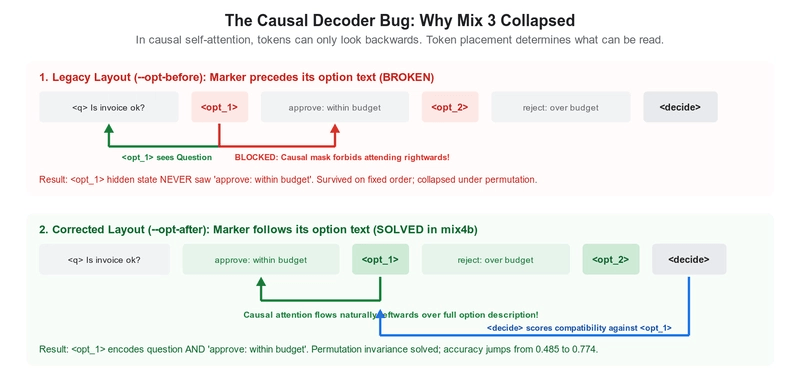
作者早期的模型靠记住固定位置维持表现。一旦在训练中打乱候选顺序,准确率就从 65% 跌到 35%。打乱顺序揭开了原先被位置规律掩盖的问题:评分位置没有足够的信息。
修正后的格式把标记移到每个选项末尾,让评分位置先读完描述:
<q> Is this invoice approved? approve: within budget <opt> reject: over limit <opt> <decide>
关键仍是 <opt> 的位置。作者报告,调整后多选任务准确率超过了 77%。
评分位置能看到什么,必须沿着注意力方向逐个检查。
<q> 为什么可以留在问题前面?因为它只负责标出问题起点,指针头不会对它评分。真正参与比较的是各个 <opt> 与末尾的 <decide>;后者已经读过问题和全部候选项。
这个区别也限定了经验的适用范围:并非所有模型都要求标记放在末尾,而是这里的因果注意力与取表示方式共同决定了这个要求。
怎样避免模型只看位置和类别名字
修好可见性之后,还要处理模型「看得到,但不认真看」的问题。作者用了三种训练做法。
第一,每个训练步骤随机打乱选项。人工整理的数据容易把正确答案放在前面,模型便可能学到「第一个通常正确」。随机化顺序,就是让这个规律失效。该操作只发生在训练中,生产推理仍可以按业务习惯排列选项。
第二,大约 40% 的训练样本隐藏有语义的选项名称。例如原本是 billing: payment and invoice problems,训练时把名称换成 option_0、option_1 或 A、B,保留详细描述。否则模型可能只认 billing,完全忽略后面的范围说明。
这对需要自定义类别的路由器尤其相关。若分类范围写在描述里,训练却鼓励模型只认名称,新增类别时就容易失去依据。
第三,用 Gemma 4 生成软标签,蒸馏给 Gev。硬标签只告诉学生一个选项正确,其余都错;软标签则保留教师的概率分布,例如 [72%, 28%],而不是 [100%, 0%]。学生由此能接触到候选项之间的接近程度。
教师也可能偏爱靠前的答案。因此,每条合成样本都让 Gemma 4 按正序和倒序各判断一次,再对分布取平均。这里比较的是同一个选项,实际实现必须先把顺序对应回来。
原文没有展开蒸馏脚本、损失函数和概率校准过程,这些被留到了 Part 4。
我的判断
作者最有说服力的发现,是标记位置导致的信息缺失。它有明确的机制解释,也有 65%、35% 和超过 77% 的结果支撑,值得作为训练前的检查项。
但这些数字还不足以证明整套方案能普遍复现。原文没有交代评测集规模、类别分布、训练预算和重复实验情况,也没有给出隐藏名称、软标签蒸馏各自带来了多少收益。40% 更适合当作实验起点,不能直接视为最佳比例。
同样,使用软标签不等于概率已经校准。若要让 0.8 的置信度承担业务决策,还需要独立验证,原文在这一篇里没有提供证据。
和规则、现成分类模型或通用 LLM 直接分类相比,Gev 的吸引力在于体积小,以及部署时可传入新选项描述。但文中没有同条件对照。单次 45 ms 也缺少硬件、输入长度和并发条件,不能直接当成线上服务承诺。
后续内容同样要区分预告与证据:Part 3 将讨论用内置视觉编码器处理 1993 年 Doom 的画面,目标表现为每秒 35 帧;Part 4 将介绍量化和生产服务,以及把推理控制在 45 ms 以下的做法。这些尚不能拿来补齐本篇的验证缺口。
能拿来做什么
- 做 Node 请求路由或业务分类前,先检查类别名称与描述是否各自包含足够信息。如果规则已经能稳定覆盖需求,可以先保留规则,再评估模型能处理哪些模糊输入。
- 给现有 AI 分类流程增加顺序检查:同一输入换几种候选排列,观察答案是否跟着位置变化,再决定是否需要改数据或训练方式。
- 如果自行训练带特殊标记的模型,先检查评分 token 能否读取完整候选内容,再投入大规模训练;这比只盯着损失下降更能发现结构问题。
- 尝试教师蒸馏时,可以参考正序、倒序生成软标签的做法,同时保留独立评测集,分别验证分类准确率和置信度是否可信。