CloudOpsBench 用真实运维任务评测智能体
开源基准 CloudOpsBench 覆盖服务修复、资源删除、权限收紧、更新发布和项目退役等云运维任务。报道指出,推理能力是 AI 处理此类任务的主要瓶颈。
AI 深度解读
云运维 Agent 的难点,可能不在于记不记得命令,而在于能否把任务范围想完整。开源基准 CloudOpsBench 用 45 项 AWS 任务测试后发现,表现最好的 Claude Fable 5.1 也只完成了 60%,约 80% 的失败被归因于推理问题。
这个结果值得程序员关注:能回答云服务问题,和能把一次变更安全地做完,是两种能力。不过,这份结果来自特定任务集,不能直接当成所有 AI 运维产品的能力排名。
45 项任务测的是能否把事情做完
CloudOpsBench 1.0 由有经验的 DevOps 工程师构建,覆盖修复服务、删除资源、收紧访问权限、发布更新和下线项目等任务。
这些任务考查的不只是某条命令能否执行成功。比如,下线一个项目,需要判断哪些资源属于这个项目、哪些服务需要检查,以及任务是否真的结束。命令执行只是其中一步。
原文称,所有任务都能在真实 AWS 云环境和模拟器中以相同方式运行。这让基准同时具备真实环境和模拟环境两种运行路径,但原文没有展开两者的一致性如何验证,也没有交代各项任务的复杂度和评分细则。
目前版本覆盖 AWS,GCP、Azure 和 OCI 扩展仍在计划中。项目采用 Apache 2.0 许可证,并提供了详细的失败分析。
为什么知道怎么操作,还是做不完
在这组测试中,Claude Fable 5.1 的完成率为 60%,GPT-6 Astra 为 53%,没有模型完成全部任务。
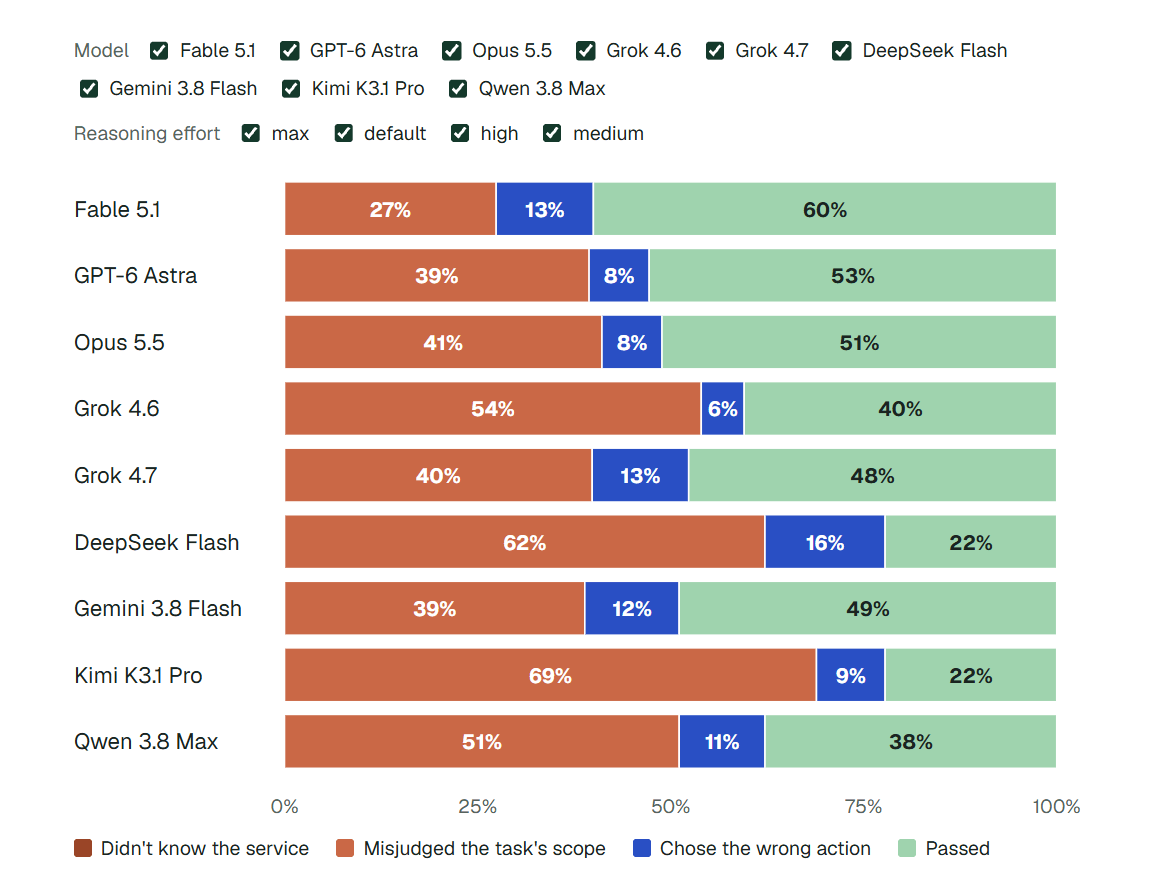
密歇根大学 Ang Chen 带领的团队将约 80% 的失败归因于推理:Agent 错判任务范围、没有检查所有相关服务,或者过早停止。
这里的「推理」可以理解为:把用户的一句话,展开成完整的检查和操作过程,再判断结果是否满足要求。Agent 可能知道每个服务怎么用,却漏掉服务之间的关联;也可能完成了眼前的操作,就把局部成功当成整个任务完成。
另有约 20% 的错误属于错误操作,其中部分会对基础设施造成不可逆后果。
「漏做了什么」和「做错了什么」,都需要进入 Agent 的验收标准。
不过,原文没有列出具体错误案例,也没有说明失败分类是否存在交叉,不能进一步推断哪些服务或操作最危险。
我的判断
这份基准最有价值的地方,是把关注点从「模型懂多少」移到了「任务有没有完整完成」。对运维 Agent 来说,一次工具调用成功,只能证明这一步执行成功,无法证明用户的目标已经达成。
但「推理是最大瓶颈」仍应限定在这组测试及其失败归因之内。原文没有给出完整运行配置,也没说明工具接口、权限设置、重试次数和任务提示如何影响结果。仅凭这篇报道,还无法判断更换模型、补充操作手册,或改造 Agent 流程,哪种投入最有效。
我更倾向于把它当作设计验收流程的证据。对于边界明确的日常操作,固定脚本和人工检查清单依然是有价值的替代方案;Agent 是否更省时、更可靠,需要放到同一组任务里比较。原文没有提供这种对照数据,也没有验证某种改进方案已经解决了问题。
能拿来做什么
- 如果团队准备让 Agent 操作 AWS,可以从服务修复、权限收紧、更新发布和项目下线中挑选真实任务,分别记录完成、遗漏和错误操作,避免只统计工具调用成功率。
- 给运维任务写清完成条件。例如,下线项目时明确要检查哪些相关服务、如何确认资源已处理,让 Agent 的停止时机有依据。
- 评估 CloudOpsBench 时,先阅读详细失败分析,再决定是否复用其模拟器或真实 AWS 任务;涉及 GCP、Azure、OCI 时,要记住当前 1.0 的结果来自 AWS。
- 比较模型和固定脚本时使用同一组任务,同时检查任务覆盖是否完整、是否出现不可逆操作,别只依据 60% 和 53% 两个数字选型。