用写入钩子执行 AI 容易漏掉的规则
作者把 Agent 容易忽略的一条文本规则改成写入校验,违规时直接拒绝保存。文章记录了对 Claude Code 钩子和校验位置的调研,并分享了三入口脚本的实测与局限。
AI 深度解读
一条写进 AGENTS.md 一类文件的规则,AI 连续四次没遵守。作者原本要求每次记录饮食时,把每天固定吃的项目计入合计。第四次漏记后,他又补了一句提醒。读者给了个更直接的办法:把反复漏掉的要求做成校验,缺项就拒绝写入。
作者用一个独立 Python 脚本和三个触发点验证了这个思路。对日常用 AI 改代码的人,最有参考价值的是三个触发点各自能做到什么,以及脚本究竟验证了哪一条规则。
先把规则缩到脚本能判断的范围
读者举的例子是,要求每条记录都标明内容属于事实、推测还是待确认,并在写入或提交时校验。这个做法适合那些能从文件内容直接判断的要求。作者的饮食日志也是 Markdown,但整份日志只有一个文件,每天用 ## YYYY-MM-DD 开一节。docmeta、mdtype、mdschema、docuchango、remark-lint-frontmatter-schema 等工具通常检查文件顶部的元数据(frontmatter)。原文引用的是 docmeta 4.14.0 的说明,也提到 iwe 的发布说明称它会拒绝违反已绑定 schema 的修改。这些做法的校验单位是文件,作者需要检查文件里的每个日期小节。
下面是作者的 check_meal_log.py。它从文件或标准输入读取日志,逐日检查已有内容的小节,并把违规日期写到标准错误。
#!/usr/bin/env python3
import re, sys

HEADER = re.compile(r"^## (\d{4}-\d{2}-\d{2})")

def check(text):
    errors, sections = [], []  # (date, lines)
    for line in text.splitlines():
        m = HEADER.match(line)
        if m:
            sections.append((m.group(1), []))
        elif sections:
            sections[-1][1].append(line)
    for date, lines in sections:
        body = [l for l in lines if l.strip()]
        if body and not any("固定" in l for l in body):   # "固定" = "fixed"
            errors.append(f"{date}: no line for the fixed daily items. Add it to the totals and write a 'fixed' line")
    return errors

def main():
    src = sys.argv[1] if len(sys.argv) > 1 else "-"
    text = sys.stdin.read() if src == "-" else open(src, encoding="utf-8").read()
    errors = check(text)
    for e in errors:
        print(e, file=sys.stderr)
    return 2 if errors else 0

if __name__ == "__main__":
    sys.exit(main())
看 if body and not any(...) 这一行。只有日期标题的空白条目可以通过。有正文时,任意一行包含「固定」就算通过,所以「今天漏记固定项目」也能满足条件。脚本验证的是标记有没有出现,合计是否正确还得另算。
同一份校验,三个触发点分别管什么
第一层最早介入。Claude Code 的 PreToolUse 在调用工具前运行,从标准输入接收 JSON,其中包括 tool_name、tool_input 和 tool_use_id。file_path 会展开为绝对路径。作者在 .claude/settings.json 里用 Edit|Write 匹配工具,执行 python3 "${CLAUDE_PROJECT_DIR}/scripts/hooks_pretool_meal_log.py"。
这段 hook 的工作是先在内存里拼出写完后的整份日志,再检查 nutrition-log.md 会不会出现违规。
#!/usr/bin/env python3
import json, os, subprocess, sys

TARGET = "nutrition-log.md"
CHECKER = os.path.join(os.path.dirname(os.path.abspath(__file__)), "check_meal_log.py")

def main():
    data = json.load(sys.stdin)
    inp = data.get("tool_input") or {}
    path = inp.get("file_path", "")
    if os.path.basename(path) != TARGET:
        return 0
    if data.get("tool_name") == "Write":
        text = inp.get("content", "")
    elif data.get("tool_name") == "Edit":
        try:
            cur = open(path, encoding="utf-8").read()
        except OSError:
            return 0
        old, new = inp.get("old_string", ""), inp.get("new_string", "")
        text = cur.replace(old, new) if inp.get("replace_all") else cur.replace(old, new, 1)
    else:
        return 0
    r = subprocess.run([sys.executable, CHECKER, "-"], input=text, text=True, capture_output=True)
    if r.returncode != 0:
        sys.stderr.write("Meal log check failed: " + r.stderr)
        return 2
    return 0

if __name__ == "__main__":
    sys.exit(main())
关键是失败分支的 return 2。按原文引用的文档,这个退出码会阻止工具调用,并把 stderr 交回模型。退出码 1 属于非阻断错误,hook 超时默认也会放行。另一种拒绝方式是返回包含 "permissionDecision": "deny" 和拒绝原因的 JSON。
第二层用 PostToolUse 匹配 Bash,执行 python3 "${CLAUDE_PROJECT_DIR}/scripts/hooks_posttool_meal_log.py"。echo >>、sed -i 这类写入不会经过第一层,光看命令字符串也很难可靠判断它会改哪个文件。作者索性在每条 Bash 命令结束后读取日志。路径可以通过 MEAL_LOG_PATH 指定,默认是 01-private/nutrition-log.md。此时修改已经落盘,报错的作用是让 AI 回头修。违规一直留着,每跑一条 Bash 命令就会再提醒一次。
第三层是 Git 的 pre-commit。作者用 ln -sf ../../scripts/pre-commit.sh .git/hooks/pre-commit 安装脚本,脚本通过 git rev-parse --show-toplevel 找到仓库根目录,再把工作区里的日志交给同一个检查器。校验失败时,这层返回 1。这里的 1 会让 Git 提交失败,和 Claude Code 对 PreToolUse 退出码 1 的解释是两回事。原文也提到,有报告记录了 git commit --no-verify 跳过本地钩子的情况,因此有人会在 CI 再跑同一项检查。
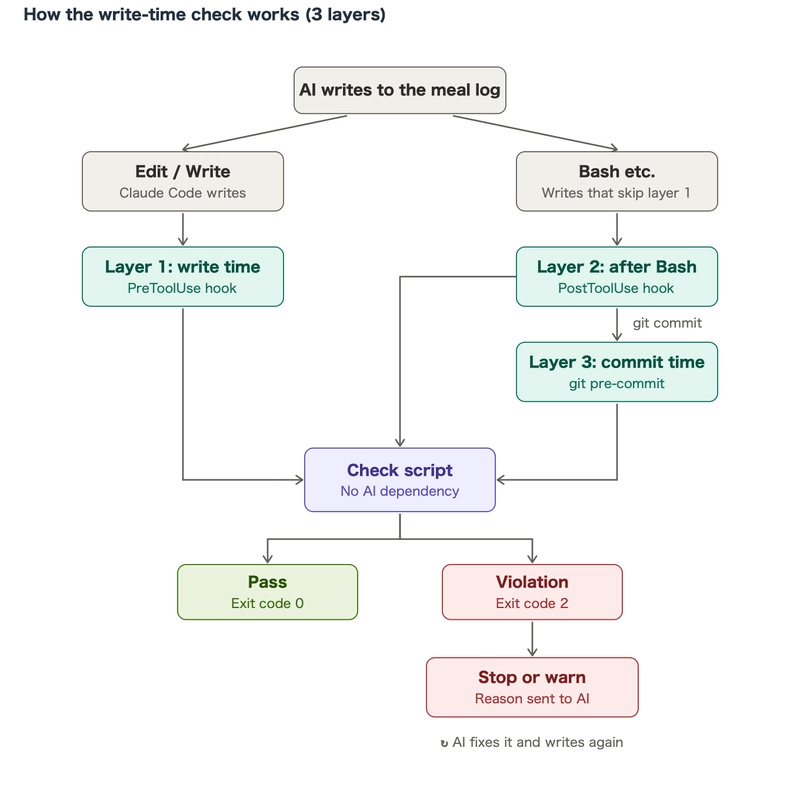
实测拦下了一次写入,提交环节只跑了脚本
作者让 AI 写一份缺少「固定」行的日志,第一层拦住了工具调用,错误信息传回了 AI,文件也确实没有创建。作者还把现有的整份日志交给脚本,全部通过。第二层的测试是故意用 Bash 追加违规小节,随后 AI 收到 PostToolUse:Bash hook blocking error。作者从备份恢复日志,并确认内容一致。第三层只直接运行了钩子脚本,违规时返回 1,恢复文件后通过。原文没有执行一次实际的 git commit 来验收这层。
原文还提到两个 GitHub issue。13744 报告 Write 或 Edit 在 hook 返回 2 后继续执行,23284 涉及 Bash 的 PreToolUse。两条都被自动标为重复并关闭,没有维护者回复可供判断。作者的环境没有复现第一种问题,原文也没有给出 Claude Code 的具体版本。另一次测试中,作者传入损坏的 JSON,json.load 直接抛出异常。正常的规则拒绝和校验器自身崩溃,得分开验。
我的判断
我认同把校验逻辑放进独立脚本。它可以直接拿旧文件跑,也能放进本地钩子或 CI。换 AI 工具时,主要需要重接触发入口。写入前反馈也有明确收益:模型当场就能拿到违规日期和修复提示。至于它比继续写规则能减少多少漏项,原文没有对照数据,结论仍是一次个人实践里的经验判断。
取舍取决于规则的粒度和要验收的对象。每条记录独占一个 Markdown 文件时,frontmatter schema 可以直接约束必填字段。多条记录共用一个文件时,校验得理解小节结构。到了团队仓库,还要看检查器读的是哪个版本。作者的 pre-commit 读工作区文件,遇到部分暂存时,校验通过的内容和实际进入提交的内容可能不同。团队如果靠这层验收提交,就该校验暂存区里的版本。
作者的方案适合减少日常漏项。真正需要禁止某类操作时,原文引用的官方文档把硬性限制交给权限机制。即便权限配置正确,当前脚本能保证的也只是字符串出现过。要落实「计入合计」,就得校验明细和合计之间的关系。
能拿来做什么
- 仓库若要求 AI 在变更记录里标明「事实」「推测」或「待确认」,可以写一个独立的 Node 或 Python 校验脚本,按记录检查字段,并把记录位置和缺失字段一起报出来。
- 接入 Claude Code 后,先在临时文件上分别测试
Write、Edit和 Bash 写入,查看前两种调用是否被拒绝、Bash 写入后能否收到提醒。再用坏 JSON 或超时测试校验器异常时的实际行为。 - 准备用
pre-commit执行团队规则时,做一次真实提交测试,覆盖只暂存部分修改的情况。若这条规则还要在合并前生效,可以让 CI 对提交内容运行同一份脚本。