用 ESP32 和 AWS 搭建语音助手
方案用 ESP32-S3 处理音频交互与联网,由 AWS 承担通信和存储,Amazon Bedrock 负责理解请求、生成回复并支持智能体流程。设想的用途包括检索个人知识库和查询部署状态。
AI 深度解读
一块 ESP32-S3 能当随身 AI 助手,前提是把它当成语音终端。它负责录音、联网和播放,AWS 负责转写、查个人资料、生成回答,再把文字合成语音。作者给出的是一套参考架构,没有提供成品的实测数据。
对前端和全栈开发者,最有参考价值的是这套系统怎么切边界。一次语音请求要经过哪些服务,会话和文档怎么分别提供上下文,以及当助手从回答问题走到查询部署状态时,后端要接管哪些决定。
一句话从录音到播放,要经过哪些服务
以「解释我最近存到 AWS 笔记里的架构」为例。ESP32-S3 用外接麦克风录音,固件准备音频,通过 MQTT over TLS 连接 AWS IoT Core。作者建议把较大的录音通过 HTTPS 上传到私有 S3,后端拿到音频引用再处理。这样一来,设备消息和音频文件可以走各自的通道。原文没有给出音频大小阈值,也没有规定设备如何拿到上传授权。
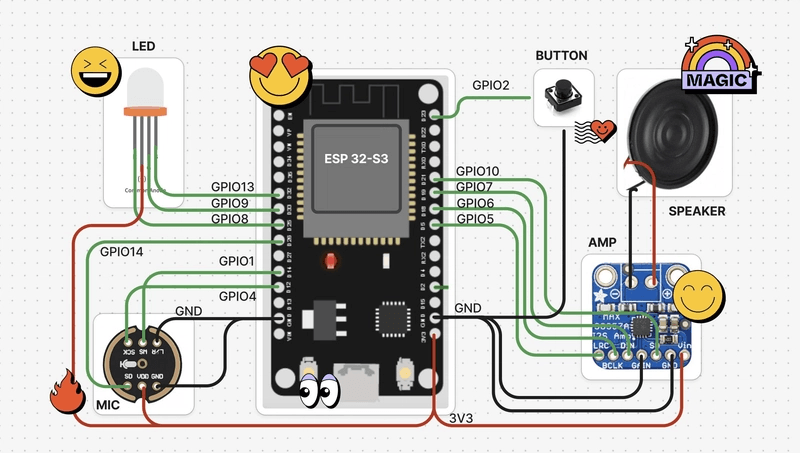
后端用 Amazon Transcribe 把录音转成文字,再由 AWS Lambda 把转写结果和相关上下文交给 Amazon Bedrock。对查笔记这类请求,后端还需要检索资料,把命中的段落带进生成过程。回答生成后,Amazon Polly 将文字转成音频。音频可放进私有 S3,设备通过短时预签名 URL 下载,再交给扬声器播放。
从用户角度看,这是一轮问答。从工程角度看,每一段都有独立的输入和输出。设备收到了回复消息,仍可能遇到音频 URL 过期或下载失败。转写成功,也可能因为专有名词听错而搜偏。原文没有定下同步还是异步交付结果。做原型时,可以先把「已收到录音」「正在处理」「可播放」区分开,排查时才能定位究竟卡在哪一段。
为什么会话记忆和个人资料要分开存
用户先问 Amazon S3 Vectors 是什么,接着问「怎么把它用在我的 RAG 架构里」。后端需要带上足以解释「它」的前文。作者用 DynamoDB 管理短期会话,列出了时间戳、用户与会话的归属以及相关元数据,但没有说明消息正文或摘要怎么保存,也没有给出选取前文的规则。光有时间戳,模型仍然不知道上一句聊了什么。
查个人笔记要解决的是另一类问题。文件放在 S3,Amazon Bedrock Knowledge Bases 从获准使用的资料源检索相关段落,后端再把段落交给模型。这就是检索增强生成(RAG)。例如,助手要解释你保存的架构,就得先找出写有组件和数据流的那几段。若用户问的是「最新」一份,还需要有办法判断版本或保存时间。原文没有交代这个规则,单靠内容相关度无法保证找对版本。
下面的 Python 示例展示了后端怎样通过 boto3 把上下文和用户问题一起交给 Amazon Bedrock,再取出回复文本。
import boto3

bedrock = boto3.client(
    "bedrock-runtime",
    region_name="us-east-1"
)

def ask_jarvis(user_message, context=""):
    response = bedrock.converse(
        modelId="YOUR_SUPPORTED_MODEL_ID",
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "text": f"""
                        You are Jarvis, a helpful personal AI assistant.

                        Relevant context:
                        {context}

                        User request:
                        {user_message}
                        """
                    }
                ]
            }
        ],
        inferenceConfig={
            "maxTokens": 500,
            "temperature": 0.4
        }
    )

    return response["output"]["message"]["content"][0]["text"]
先看 modelId 那一行。YOUR_SUPPORTED_MODEL_ID 是占位符,需要换成账户在所选区域可调用的模型。maxTokens: 500 和 temperature: 0.4 是示例参数,原文没有给出调参结果。context 也只是调用方传入的字符串。历史消息怎么选、资料怎么检索、哪些数据该到期删除,都要由应用实现。
能查部署状态以后,谁来决定能不能执行
「看看最新部署是不是失败了」可以从只读工具做起。按作者的设计,模型提出要调用的工具和参数,后端校验工具名与参数、核对用户身份和权限,再让具备最小 IAM 权限的工具去查。查询结果返回模型,由它解释这次部署处于什么状态。删除资源、修改基础设施或变更权限等操作,则需要用户明确批准。
这里有两份身份要管。每台设备的唯一 X.509 证书用于确认是哪台设备在连接。谁拥有这台设备、当前操作者能看哪个项目,要靠应用自己的身份与授权机制判断。家里多人都能碰到这块板子时,这个区别尤其直接。能对着麦克风发请求的人,可能没有权限看你的部署记录。原文提出了这个边界,但没有给出共享设备上的用户认证流程。设备固件也不应写入 AWS 账户凭证。
我的判断
作者最有说服力的做法,是先跑通单轮语音,把会话、文档检索和工具调用留到后面。语音链路本就有上传、转写、模型生成、合成和下载等环节。每加一种数据源或工具,故障来源就多一处。先用固定问题跑通全链路,才能区分到底是麦克风录得不清楚、检索漏了资料,还是模型答错了。
ESP32-S3 的价值在于实体入口,比如桌上放一个按键和扬声器。如果团队想验证的是员工能否用语音查文档或看部署结果,先用浏览器录音,接同一套后端,就能把硬件和设备证书的工作往后放。反过来,如果要验证的就是离开电脑后的交互,真机录音、弱网恢复和播放就应该尽早测。选哪条路,取决于当前要验证什么。
原文没有给出端到端延迟、转写准确率、硬件兼容性结果或实际账单。控制历史长度、缩小检索片段、缓存适合复用的回答,都是经验建议,没有对照数据证明各自能省多少。成本也不能只盯着 Bedrock 的 token。转写和语音合成、Lambda 执行、DynamoDB、S3 及 IoT 消息都会计入。作者建议按选定区域和用量用 AWS Pricing Calculator 估算,交互速度还得用完整请求来测。
能拿来做什么
- 先在 Web 页面或 ESP32-S3 上做一次按键录音,用固定问题走通上传、转写、生成、合成和播放。分别记录每一段的耗时和失败状态,再决定先优化哪里。
- 给 Node 后端的会话查询带上用户和会话归属,只取能解释当前追问的几轮内容。文档检索单独做,用一新一旧两份架构笔记测试「最新」究竟按什么规则选。
- 把首个工具做成只读的部署状态查询。由后端校验项目和环境参数,确认当前用户有权读取,再把查询结果交给模型组织成回答。
- 给原型加上可复现的失败场景,至少试一次设备断网、音频 URL 过期和转写失败,看页面或设备能否显示当前状态并重新发起请求。