Mistral Large 4 权重开放下载
Mistral 在 Hugging Face 发布旗舰开放权重模型 Large 4。标题称其编程成绩领先 GLM-5.3 一分,但摘录未说明测试基准、部署条件或许可细节。
AI 深度解读
Mistral Large 4(ML4)开放权重了。Mistral 给它的定位很直接:面向智能体编程和网络安全的前沿模型。最吸引人的成绩,是编程测试比 GLM-5.3 高出 1 个百分点,同时宣称每项任务平均少用 47% 的 token。
但这篇报道真正值得看的,不只是排名。它把模型能力、推理效率和开放权重放在了一起:开发者既要模型能干活,也要用得起、部署得下,还要避免业务完全依赖一家供应商。这里有可参考的数据,也有尚未被充分证明的商业主张。
编程领先只有 1 个百分点,效率才是更大的卖点
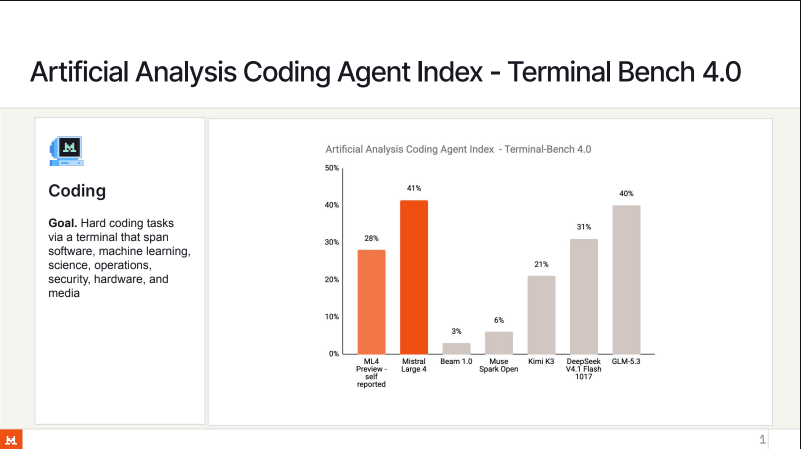
ML4 的正式昵称是 Le Chonk。按照 Mistral 提供的数据,它在 Terminal-Bench 4.0 上得到 41%,GLM-5.3 为 40%,Kimi K3 为 21%,Muse Spark Open 为 6%。这项测试是 Artificial Analysis 的 Coding Agent Index 的组成部分。
智能体编程(agentic coding)关注模型在工具和运行环境中完成任务的能力。对程序员来说,它比单次回答一道代码题更接近实际工作,但具体测试任务依然会限制结论的适用范围。
41% 对 40%,足以说明竞争接近,撑不起全面领先的结论。
更有吸引力的是另一项说法:ML4 每项任务平均使用的 token 比 GLM-5.3 少 47%。如果在相近成功率下成立,模型反复分析、调用工具、读取结果的开销就可能下降。
不过,token 少不直接等于费用和耗时同比下降。单价、生成速度、工具执行时间、失败重试都会影响最终结果。原文没有交代这项平均值覆盖哪些任务,也没有提供完整的端到端成本对照。因此,「少用 47% 的 token」应保留为 Mistral 的测试结论,不能直接改写成「便宜 47%」。
报道标题里那句「竞争对手能做的,它都能做」,同样超出了这些数据能够证明的范围。模型在特定榜单领先,并不代表它在所有语言、仓库规模和工具链中都有相同表现。
网络安全成绩更突出,但不能理解成自动兜底
Mistral 把编程和网络安全列为训练投入的两个重点。它认为,这两类能力最能影响客户的业务流程。
在测试防御性网络安全能力的 CyberGym E2E 上,Mistral 给出的成绩是:
- ML4 得分 79%,GLM-5.3 得分 29%。
- GLM-5.3 Flash 得分 74%,DeepSeek v4.1 Flash 1017 得分 76%。
- MiMo-V2.6-Pro 同样得到 79%,与 ML4 持平。
这组数据比编程测试的领先幅度更显眼,但参照对象很重要。只看 GLM-5.3 的 29%,容易形成断层领先的印象;把其他模型放回来,ML4 的位置是处于前列,并且存在同分者。
作者还记录了一个客户应用方向:用专门的智能体分析应用日志、寻找潜在入口,辅助自动化渗透测试。这比笼统地说「模型懂安全」更具体,说明它正在被接入真实工作流程。
但报道没有给出客户名称、漏洞发现率、误报率或人工复核成本。CyberGym E2E 的成绩,也不能直接换算成某个线上系统的安全覆盖率。把它作为辅助分析和验证工具,有依据;据此认为它能独立承担安全验收,证据还不够。
开放权重解决可控性,资源效率还需要更多证据
Mistral 在周四把 ML4 权重发布到 Hugging Face。它此前已公开预览约三周,公司称通过强化学习,以及客户和合作伙伴测试,模型能力又有明显提升。
具体到 Terminal-Bench 4.0,Mistral 自己公布的分数从预览阶段的 28% 上升到 41%,提高了 13 个百分点。这个变化比领先 GLM-5.3 的 1 个百分点,更能体现其报告中的迭代幅度。
训练资源方面,报道给出两组信息:10 月初预览前,ML4 在欧洲数据中心使用约 3,800 张 Nvidia Grace Blackwell GPU,训练约两个月;之后的强化学习,Mistral 称只用了 10 兆瓦功率。
这两组数字不能直接拼成完整训练账单。10 兆瓦描述的是功率,原文没有提供强化学习持续时间、总耗电量,也没有披露统一口径的竞争对手数据。被追问如何确定效率更高时,Mistral 科学副总裁 Pierre Stock 的回答是,他不知道有谁能用同样规模的资源做到。
这属于经验判断,不是完整的成本比较。他提出「如果资本增加到 10 倍,就能结合这些效率收益继续推进」,也是对未来投入的判断,不能当成已验证的扩展规律。
开放权重的理由则更清楚:企业可以在自己的基础设施或信任的基础设施上运行模型,降低服务被外部供应商中断的风险。
开放权重增加了部署选择,但不会自动消除算力依赖。
报道也引述了 Dario Amodei 的不同看法:即使权重开放,计算基础设施仍可能集中。两者并不冲突,拿到权重解决的是控制模型的条件,拥有足够算力解决的是实际运行能力。
Mistral 还计划在未来几个月推出 Le Chonk 模型家族,其中一个版本可以在笔记本上运行。原文没有公布这些小模型的参数量、硬件要求和能力差距,不能把未来版本的承诺算到当前 ML4 身上。
我的判断
我认可 Mistral 把任务成功率、token 消耗和部署控制权放在一起讨论。对团队选型来说,这比单独追逐榜单分数更接近实际需求。模型能否完成任务、一次完成花多少钱、服务能否持续获得,都是工程问题。
但「全球最佳开放智能体编程模型」仍然是厂商主张。报道中的关键对比来自 Mistral,没有提供可供读者复核的完整实验设置,也没有展示不同仓库和任务类型的结果分布。它值得进入候选名单,尚不足以成为直接替换现有方案的理由。
相较于托管模型服务,开放权重提供更多控制空间,也会带来部署、运维和容量管理工作。原文没有说明 ML4 的许可证细则和部署门槛,因此不能把「开放权重」直接理解成免费、低门槛或适合普通笔记本。
Mistral 提到的遗留代码现代化、金融、制造、工业工程和地理空间应用,更多是能力定位。报道没有逐项给出案例或对照数据。选择模型时,仍要回到自己的任务,而不是把应用领域列表当成效果证明。
能拿来做什么
- 如果你在评估 AI 编程工具,可以从现有前端或 Node 仓库选取可验收的修复、迁移任务,用同一套测试比较 ML4 与当前模型,同时记录成功率、token 消耗、耗时和重试次数。
- 如果团队准备让智能体辅助安全工作,可以从日志分析和潜在入口排查开始,把模型输出交给人工复核,并用误报和遗漏情况判断它是否减少了工作量。
- 如果业务需要长期可控的模型服务,可以把开放权重列入选型条件,同时核对许可证、硬件要求和维护成本;计划中的笔记本版本,应等实际发布后再评估。