Mistral Large 4 开放权重并下调 API 价格
据素材介绍,Mistral Large 4 采用约 1.05 万亿总参数、每 token 激活约 520 亿参数的 MoE 架构,支持百万 token 上下文和图文输入。权重提供 FP8、NVFP4 版本;API 每百万 token 输入、输出价格分别降至 0.70、2.10 美元。
AI 深度解读
Mistral Large 4 的看点,是把万亿参数、开放权重和较低的 API 标价放到了一起。原文给出的结论很明确:它对欧洲数据驻留、自托管和安全研究有吸引力,但如果只比较任务效果与价格,还不能直接认定它比中国开放模型更划算。
这篇值得读的地方,是它把参数、跑分、价格和许可证放在同一张选型清单里。不过,多数成绩来自 Mistral 自己,独立榜单又采用预览版数据,读的时候需要分清证据来自哪里。
万亿参数,为什么不等于万亿参数的推理成本
按原文,Mistral AI 在 2026 年 10 月 6 日发布 Mistral Large 4 公开预览版,10 月 29 日在 Hugging Face 放出权重。它简称 ML4,昵称「Le Chonk」,采用混合专家架构(MoE):总参数 1.05T,每个 token 激活约 52B。
这里有个容易误读的数字:公告写过 49B,文档写过 52B。模型卡解释,49B 是每个 token 运行的参数量,52B 把嵌入层和输出层也算了进去,两者统计口径不同。
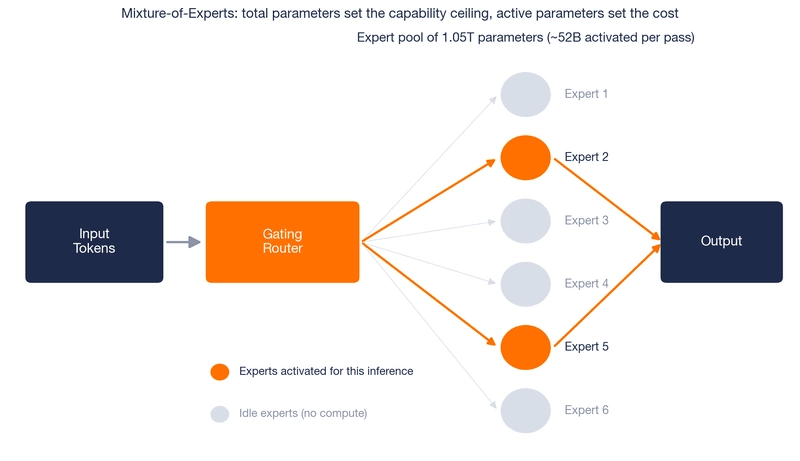
可以把它理解为一个很大的专家库,每次只请其中一小部分参与计算,激活比例约 5%。原文据此认为,ML4 的服务计算成本接近 50B 模型。不过,不能把这个判断直接当成部署预算:权重仍要存放,实际吞吐也受硬件、并发和推理框架影响。
ML4 支持 1M-token 上下文、文本与图像输入,视觉编码器为 1.6B,训练数据覆盖 160 多种语言。同一个模型兼顾快速回答和分步推理,但推理 token 会计入 max_completion_tokens。提高推理设置时,既要给答案留空间,也要承担更多输出费用。
激活参数决定了部分计算开销,总参数仍然关系到部署门槛。
跑分很亮眼,但哪些能代表你的编程任务
原文最看重 ML4 的安全能力:它进入 Artificial Analysis Cyber Index 前五,在复现真实漏洞并修补的测试中达到 82%,解决了 93% 的 Cybench 挑战。
编程代理方面,Terminal-Bench 4.0 从预览版的 28.3% 提升到 41%。视觉定位测试 Dense 200 得分 42%,比 GPT-6 Astra 高 1 个百分点。Mistral 的安全测试还给出两项结果:抵御 Lakera B3 攻击的比例为 97.1%,拒绝恶意网络请求的比例为 96.6%。金融和法律能力也有领先宣称,但原文没有展开可供比较的数据。
这些结果多数由 Mistral 发布,不能直接推导出「更适合写前端」。
独立综合榜单提供了另一种尺度。Artificial Analysis Intelligence Index 的 v4.3.2 榜单采用预览版成绩:ML4 得到 38 分,与 GPT-6 Luna 持平,在展示的 25 个模型中排名第 18。Nemotron 3 Ultra 为 23 分,Claude Opus 5.5 则以 58 分领跑。
因此,「美国和欧洲最强开放权重模型」是带地域和模型开放范围的结论。它仍落后于同榜领先的中国开放模型,也没有达到闭源前沿水平。预览版综合成绩与后续专项测试还不是同一个时间截面,不能拼成一张完全同步的排名表。
安全能力同样存在访问条件。Mistral 正与安全公司、审核通过的合作伙伴及国家机构开展红队测试,部分参与者可以使用降低内容限制、扩展网络安全能力的版本。普通 API 用户能否获得同样效果,原文没有交代清楚。
API 降价以后,自托管仍然是一道门槛
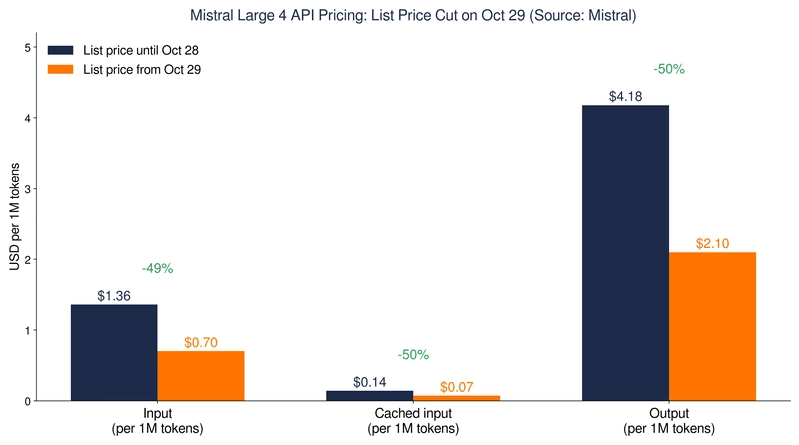
10 月 29 日,ML4 每百万 token 的正式价格从输入 $1.36、缓存输入 $0.14、输出 $4.18,降到 $0.70、$0.07、$2.10。此前预览期有过 50% 首发优惠,输入和输出分别为 $0.68、$2.09,这次相当于把接近促销期的价格固定下来。
原文尚未找到 Large 4 的公开批处理价格。OpenRouter 的 EU-hosted 路由收费为全球路由的 1.1 倍,上下文则从 1M 缩到 512K。接入时只看模型名,很容易漏掉路由差异。
API 模型 ID 是 mistral-large-4-0,别名为 mistral-large-4。权重仓库是 mistralai/Mistral-Large-4-1T-A52B:FP8 约 1.06 TB,NVFP4 约 610 GB。后者另有面向 Blackwell GPU 的 checkpoint,涉及 B200、B300、GB200 和 GB300。官方服务示例中,FP8 使用 8 张 GPU,NVFP4 使用 4 到 8 张。
许可证叫 Mistral Ecosystem Open-Weight License,是修改版 MIT 许可证。按原文说明,它允许使用、修改、微调、再分发和商业使用,包括企业内部自托管;但如果你或关联方经营模型访问服务,需要另行取得商业许可。开放权重不能直接理解成可以随意转售 API。
欧洲是它的另一项卖点:训练完全在 Mistral 自有欧洲数据中心完成,API 也从欧洲提供服务。但欧洲托管只是数据治理的一项条件,不能单凭这一点判断业务已经满足 GDPR 要求。原文对美国闭源 API 无法提供同类条件的说法,也没有给出逐产品对照。
Mistral 在 9 月以 €21 billion 估值融资 €3 billion,目标是在 2030 年达到 1 GW 欧洲算力;10 月 21 日公布与 NVIDIA 合作,把 ML4 用于航空航天、汽车和半导体的物理仿真及工业设计,涉及 CUDA-X、Warp、Omniverse。计划中的开放基准和数据集尚未发布,这部分仍是合作方向。
我的判断
我认可原文把选型标准落到数据位置、硬件控制权和任务成本上。对需要欧洲数据驻留、能够承担多卡部署、又希望保留微调和跨云迁移空间的团队,ML4 有明确的评估价值。
但「开放权重」「万亿参数」「低 API 单价」分别回答不同问题,不能合并成性价比结论。原文说 DeepSeek V4.1 Flash 在综合指数上成绩接近、价格低得多,GLM-5.3 和 Kimi K3 得分更高,却没有提供统一任务集下的成功率、延迟和总费用对照。因此,关于实际业务划算与否,目前仍是选型判断,缺少完整验证。
原文也没有作者亲自部署、微调或完成编程任务的记录。末尾 A2Agent 是产品推广:它宣称一个 API key 可访问 DeepSeek、GLM、Kimi、MiniMax、Qwen 等模型,新账户有 $5 额度。示例解决的是「把同一道题发给两个模型」:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.a2agent.me/v1",
)

for model in ["deepseek-v4.1-flash-1017", "glm-5.3"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Summarize the GDPR rules on data transfers outside the EU."}],
    )
    print(model, response.usage.total_tokens)
    print(response.choices[0].message.content)
要看清 for model 这一行:它没有调用 ML4。total_tokens 也只是 token 用量,代码没有计算费用或验证答案正确性,不能把它当成性价比测试结果。
能拿来做什么
- 为日常 AI 编程准备一组固定任务,例如现有仓库的问题修复、终端操作和漏洞修补,让 ML4 与候选模型完成相同工作,记录通过验收的任务成本。
- 接入 ML4 时,先核对
mistral-large-4-0、上下文容量和路由价格,再设置max_completion_tokens,避免推理消耗挤占最终回答。 - 评估自托管前,先用 FP8、NVFP4 的权重体积及官方 GPU 示例估算资源,再核对许可证中的模型服务条款。
- 如果确实有欧洲数据驻留要求,把服务区域、数据流向和合同条件一起核实,不要只依据模型宣传页决定供应商。