在OpenCode中引入独立上下文设计评审
EGM 工作流将设计作者与评审者分离,让未接触原始讨论的 Agent 仅依据文档评审,减少自我认可倾向。文章提供非官方 OpenCode 适配插件的安装方法及嵌套子代理配置。
AI 深度解读
让 AI 审查自己刚写的设计,它很容易给出「看起来不错」的评价:讨论过程还在上下文里,先前的推理也会影响后续判断。EGM(Elephant-Goldfish Model)提出的办法,是把作者和审查者拆开,让没有参与讨论的新会话只看文档、独立挑错。
原文作者把这套流程接进了 OpenCode V2,做成非官方插件 opencode-egm。它值得关注的地方,是把独立审查、权限限制、人工决策和文件产物串成了闭环。但它能隔离多少偏见、是否值得额外花费,还得分开看。
为什么换一个审查会话,比再问一次更有意义
EGM 用两种动物区分职责:「大象」保留完整背景,负责把握方向;「金鱼」没有先前的对话历史,负责检查文档能否独立成立。
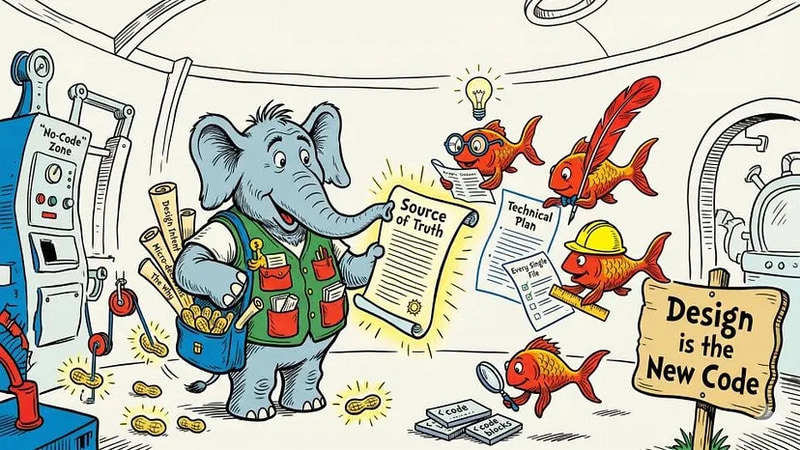
这个安排针对的是上下文锚定。参与过讨论的模型,知道某个选择为什么出现,可能会替文档补上没有写出的前提。新审查者看不到这些解释,更容易暴露未定义的术语、缺失的约束和无法执行的步骤。
独立审查的价值,是让文档失去作者口头解释的保护。
插件把检查任务分给 7 个只读角色:egm-zoom-out 检查简化空间、YAGNI 和已有能力复用;egm-design 检查架构、扩展性、基础设施成本及风险;egm-comprehension 模拟不了解背景的读者;egm-implementation-readiness 判断说明是否足够落地;egm-codebase-details 核对真实代码;egm-structural 检查文档结构;egm-style 负责表达清晰度。
随后,egm-synthesizer 合并重复意见,生成 goldfish_review_report.md。审查者不能写文件,也不能继续创建子代理;汇总者可以创建审查者,但只允许写报告。角色分工因此有权限约束,提出异议不会顺手变成修改设计。
在 OpenCode 里,怎样把审查跑成闭环
原文称,EGM 是 Google 开源的设计审查工作流,基于 Dave Rensin 的文章。作者开发的 opencode-egm 则是独立适配器,不是 Google 产品,也不由 Google 提供支持。
安装命令是 opencode plugin add opencode-egm,随后重启 OpenCode。插件启动时注册 7 个 skills、10 个 personas 和 7 个命令,无须另外复制提示词或配置文件。
下面的配置让审查编排器能够自行创建审查者,应写入 opencode.jsonc:
{
  "experimental": { "subagent_depth": 2 }
}
要看的是 subagent_depth:设为 2 后允许一层嵌套子代理;不配置也能运行,只是创建审查者的工作改由主代理承担。
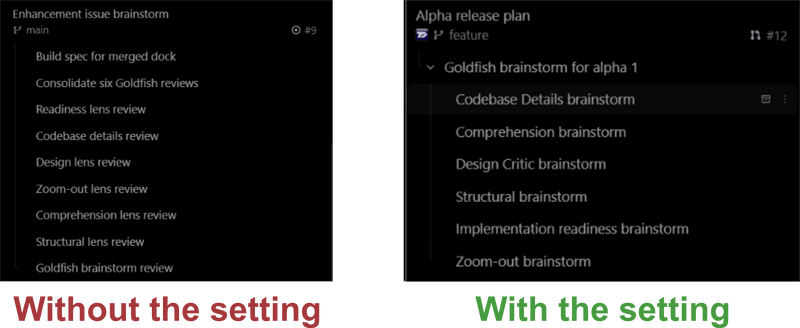
从想法到处理反馈,原文给出的调用顺序如下:
/egm-brainstorm Add an offline mode to the mobile app
/egm-draft concepts_brief.md
/egm-review design_draft.md feature_spec
/egm-resolve design_draft.md
重点是第三行:/egm-review 可以单独审查已有设计,不要求先走头脑风暴和起草流程。未指定预设时,它会询问使用 feature_spec、implementation、uninterrupted,或者选择第 5 到第 9 阶段中的某个阶段。原文没有解释这些阶段的具体差别。
遇到预设、修复项、范围等决策点,插件通过 OpenCode 的 question tool 阻塞等待回答,也支持自由输入约束。/egm-resolve 会把问题归为 fix-now、fix-later、push-back,只应用用户批准的修复。
产物落到 concepts_brief.md、design_draft.md、goldfish_review_report.md 等文件中。在提示词或 AGENTS.md 中写入 EGM artifact directory: docs/egm,即可指定存放目录。这样,设计和反馈可以进入版本管理,后续也更容易追踪改了什么。
文档写完以后,还能检查它有没有过期
原文另有两个命令,处理文档维护。
/egm-bootstrap src/ 遍历源码目录,通过并行的只读侦察代理,生成描述各目录接口、不变量和副作用的 README。不变量就是修改代码时必须一直成立的约束,例如某个模块不能直接写入外部状态。
/egm-drift-report docs/designs 则把设计文档与当前代码对照,输出分歧,产物名为 YYYY-MM-DD_DRIFT_REPORT.md。
这两项分别补充后续代理所需的代码背景、暴露设计与实现之间的偏差。但生成出来的 README 是否准确、偏差报告能覆盖多少问题,原文没有提供评估结果。它们仍需要人工抽查。
我的判断
我认同把起草和审查分开,也认同让审查者只读。相比在同一会话里追加一句「请严格批评」,这套流程更明确地切断了对话历史,并限制审查阶段的操作范围。
不过,全新对话上下文,不等于完全隔离。 OpenCode 的子会话共享工作目录,仍能读取作者写下的文件。父会话的推理如果已经进入文件,审查者依然可能接触到;原文也承认其他运行框架能提供更强的隔离。
标题里的「insane」属于作者评价。文章展示了流程和权限设计,没有给出缺陷发现率、误报率,也没有与单次审查或人工评审做对照。因此,「分工能覆盖更多检查角度」有合理依据,「一定提高设计质量」仍是经验之谈。
成本同样要算。完整审查会创建多个子代理,消耗真实 tokens,耗时几分钟,作者建议使用能力较强的模型,却没有给出具体型号和账单。对于后果较大、存在不确定性的变更,这笔成本可能合理;一行 bug 修复通常不需要这么重的流程。
上游 skills 和 personas 保留 Copyright 2026 Google LLC,采用 Apache-2.0。使用时要分清上游工作流与非官方适配器的责任边界,审查报告也不能代替开发者作决定。
能拿来做什么
- 已经写好前端或 Node 项目设计时,可以直接用
/egm-review检查,重点看陌生读者能否理解约束,以及实施者是否还需要补做关键决策。 - 项目准备交给 AI 持续维护时,可以用
/egm-bootstrap src/生成目录说明,再抽查接口、不变量和副作用,确认这些说明足以作为后续上下文。 - 设计文档长期保存在仓库里时,可以用
/egm-drift-report docs/designs找出与实现不一致的位置,再决定更新文档还是调整代码。 - 处理审查意见时,用
/egm-resolve逐项选择立即修复、延期或反驳,并保留理由,避免把模型提出的每个问题都变成新增工作。