Meta小模型瞄准代理重复性任务
Meta 发布 Muse Ember,针对工具调用、路由和数据提取等重复性代理任务优化。Meta 称其单位成本表现优于 Claude Haiku 5.5 和 GPT-6 Luna,但报道指出其实际编程能力较弱。
AI 深度解读
Meta 推出的小模型 Muse Ember,瞄准的是 AI Agent 每天反复执行的工具调用、请求分流、数据提取和小型编码任务。它的卖点是低成本:在 Artificial Analysis 测试中,单任务花费约为 Muse Spark 1.3 的十七分之一,综合分数只差 1 分。
但综合分数接近,不代表写代码也同样可靠。原文给出的真实编码测试里,Muse Ember 明显落后于 Haiku。对程序员而言,更有用的问题是:哪些重复工作值得交给它,哪些任务还需要更强的模型接手。
便宜到什么程度,要分两种账来看
Muse Ember 是 Meta 宣称迄今最小、效率最高的 AI 模型,定位很明确:调用工具、完成小型编码任务、分流请求、提取数据,以及处理长文档。
原文给出了两组成本,不能混着理解。
第一组是测试中的任务成本。在 Artificial Analysis Intelligence Index 上,Muse Ember 得分为 36,单任务成本约 $0.14;更大的 Muse Spark 1.3 得分为 37,成本为 $2.39。两者综合分数接近,花费却差了约 17 倍。
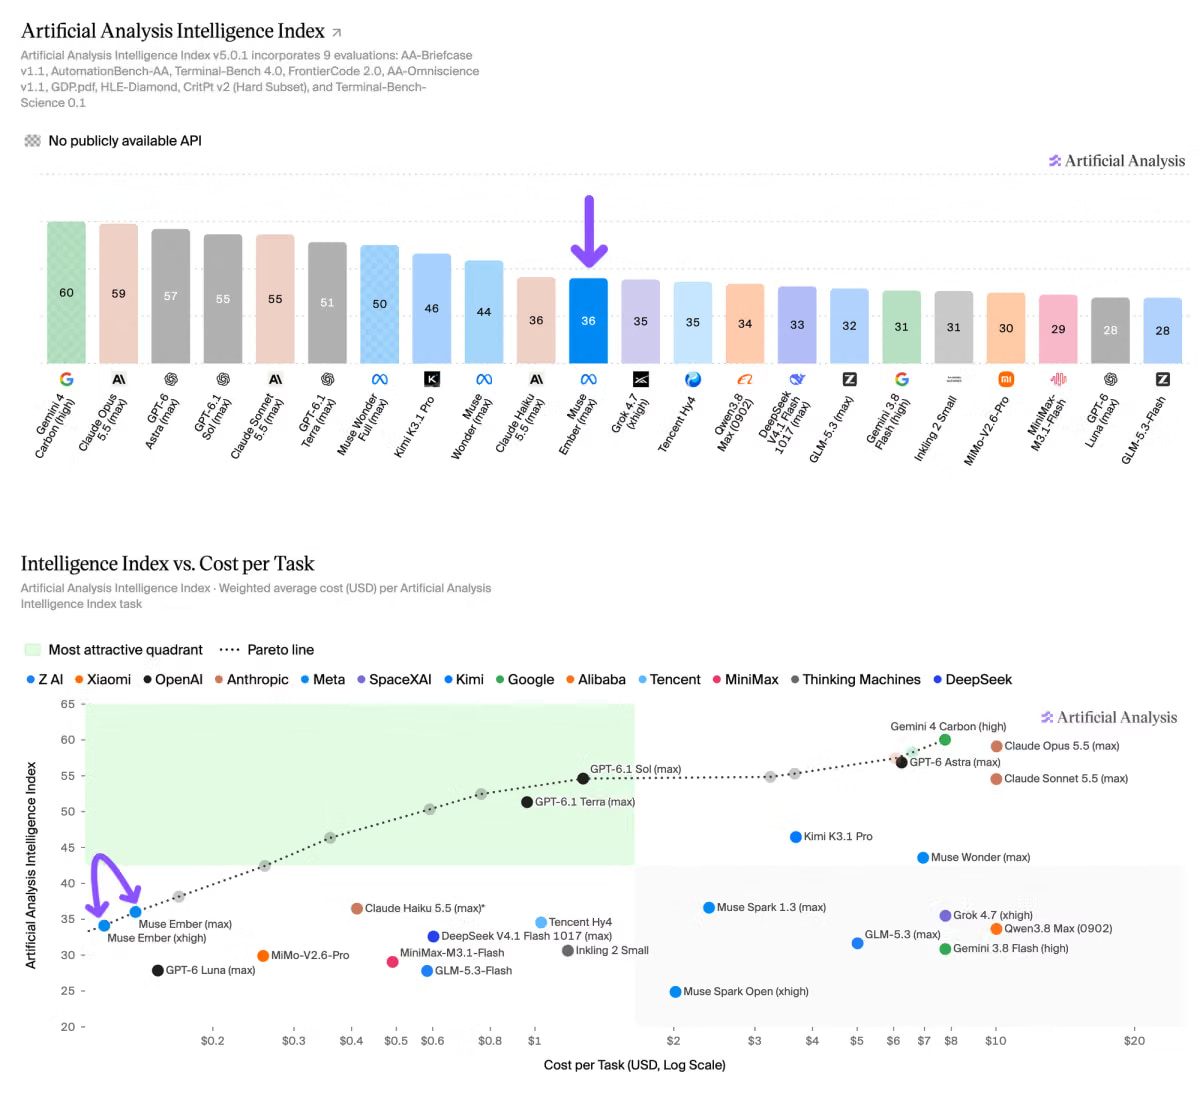
第二组是 API 定价:每百万输入 tokens 为 $0.10,每百万输出 tokens 为 $0.50。目前可通过 Meta Model API 和 Muse Code 使用。
测试里的 $0.14 是特定任务集的成本,不能直接当成业务里每次调用的预算。
一次请求要花多少钱,还取决于输入长度、输出长度和执行次数。原文没有交代测试成本的详细计算方式,也没有提供业务负载下的数据。
综合分数接近,为什么编码还要单独看
Meta 表示,在每个推理级别上,Muse Ember 的单位成本智能表现都优于 Claude Haiku 5.5 和 GPT-6 Luna。原文还称,它在 Meta 自己的大多数测试中领先。
这里需要把证据来源分开:前者是 Meta 的比较结论,后者来自 Meta 自家的测试;原文没有列出足够细节,无法据此判断它在各种任务上都占优。
真实编码任务给出了另一幅图景。在 FrontierCode 2.0-AA 中,Haiku 得分为 34.9%,Muse Ember 为 27.2%,相差 7.7 个百分点。
因此,综合智能指数可以用来初筛模型,却不能代替编码专项评估。尤其是把模型接进代码仓库之后,你关心的是它能否完成修改、通过验证,以及失败后要返工多少次。
Muse Ember 还支持文本、图像、音频和视频,一次最多处理一百万 tokens。这个容量适合纳入长文档处理的候选范围,但原文没有提供长上下文检索准确率、响应延迟或各模态的具体表现。能接收这么多内容,与能稳定找对关键信息,是两件需要分别验证的事。
我的判断
我认同它选择的方向。Agent 工作流里存在大量重复步骤,如果每一步都调用昂贵模型,成本容易积累。把工具选择、请求分流、字段提取交给便宜模型,是值得测试的方案。
但这篇报道支持的是「Muse Ember 值得进入候选名单」,还不足以支持「可以全面替换现有模型」。原文没有作者或独立团队的业务实测,也没给出工具调用成功率、重试次数和延迟对照。
与所有步骤统一使用强模型相比,按任务分配模型有节省成本的可能;代价是需要维护分流规则、结果校验和失败回退。只有节省下来的调用费足以覆盖这些额外工作,这种安排才划算。
如果主要需求是改代码,现有编码数据并不支持仅凭低价优先选择 Muse Ember。
能拿来做什么
- 在 Node Agent 中,先挑字段提取、请求分类或工具选择中的一个步骤做对照,使用相同输入和验收标准,记录成功率、重试次数与总成本。
- 对前端或全栈编码任务,把小范围修改和需要理解整个仓库的任务分开评估,不要用综合指数代替代码能否通过验证的结果。
- 处理长文档时,准备答案位置明确的样本,检查一百万 tokens 容量下是否仍能准确提取信息,再决定是否接入实际流程。