让预算 AI 只改写文案,不负责算账
Finovaa 将预算判断交给基于已加载数据运行的同步纯函数,并按风险等级排序,模型只负责改写已有结论。检测器显式接收时间参数,方便单测;模型延迟或失效时,应用仍能提供正确答案。
AI 深度解读
预算应用里的 AI 教练,最危险的错误可能是把余额 24 美元说成 240 美元,而且语气十分笃定。作者正在开发的 Finovaa 采用了一条明确边界:应用先算出结论,模型只负责改写措辞。
这套设计值得程序员参考的地方,是把判断、展示和生成拆开了:不用模型,功能也完整;模型出错,已有答案继续显示。不过,作者用来拦截虚构数字的校验,只能守住其中一部分风险。
先让应用决定说什么,模型才有资格润色
Finovaa 的信号引擎负责检测预算消耗速度、异常支出、周期扣费、储蓄目标缺口和月底资金不足。检测结果按 risk > watch > info > win 排序,先处理风险,再考虑提醒和正向反馈。
这些检测器都是纯同步函数,直接使用页面已经加载的数据。所谓纯函数,就是相同输入得到相同输出,不依赖隐藏状态。连当前时间 now 也由外部传入,测试时不必模拟 Date,月底边界也能直接构造输入验证。
另一个容易忽略的设计是:允许检测器不返回任何信号。没有值得提醒的事情,就保持安静。教练每天强行找话说,很快会变成用户忽略的噪声。
每个有效信号会先根据自身事实,立即生成一句确定性文案,然后才考虑网络请求。免费用户拿到的就是这个完整结果。卡片里的数字与页面其他部分共用计算引擎,避免上方图表和下方建议各算各的。
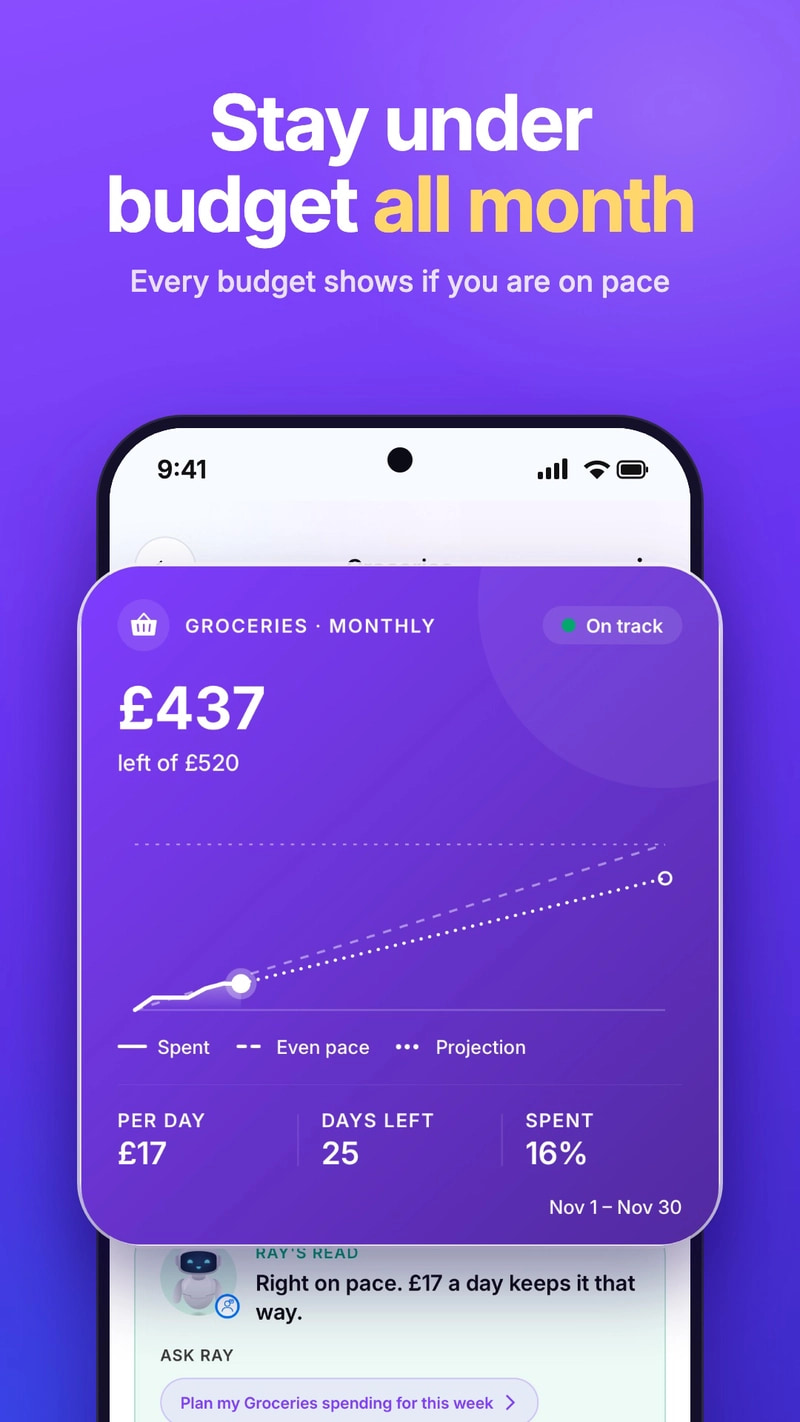
模型参与之前,正确答案就已经在屏幕上了。
因此,模型超时、不可用或额度耗尽时,用户仍能看到建议,不需要对着空卡片或加载动画等待。
给模型的事实越克制,输出越容易约束
Pro 用户会获得模型改写后的表述。输入不是让模型自行推理的一堆原始流水,而是应用整理好的、带标签的事实:
Budget: Groceries, monthly, limit £520
Day 5 of 30; 25 days left including today
Spent: £83 (16% of the limit)
Safe to spend per day for the rest: £17
这里要注意 Safe to spend per day 这一行:每天可花多少,已经由应用算好,模型无需重新计算。
作者还刻意不提供月初的支出外推结果。月初只有少量消费记录,一次采购就可能被放大成整月趋势。既然页面此时不展示预测,模型也拿不到预测。
这是一种输入约束:不希望模型说出的内容,尽量别先塞进上下文。
输出端还有一道检查。下面的代码提取回复中的数字,要求它们全部出现在输入事实里,否则丢弃改写,继续显示原来的确定性文案:
const numbersIn = (text: string): string[] =>
  (text.match(/\d+(?:[.,]\d+)*/g) ?? []).map(n => n.replace(/,/g, ''));

export const isGroundedReply = (reply: string, facts: string): boolean => {
  const text = reply.trim();
  if (!text || text.length > MAX_REPLY_CHARS) return false;
  if (/undefined|null|NaN|\{\{/.test(text)) return false;
  const allowed = new Set(numbersIn(facts));
  return numbersIn(text).every(n => allowed.has(n));
};
关键是最后一行的 every:只检查数字是否属于允许集合,不理解数字在句子里的含义。前面的检查还会拒绝空回复、超长回复,以及泄漏 {{amount}}、undefined 等内容的异常输出。原文没有给出 MAX_REPLY_CHARS 的具体值。
实际版本还会归一化阿拉伯文数字,让 ١٧ 与 17 匹配,因为应用支持阿拉伯语。
我的判断
我赞成把金额计算和风险判断留在确定性代码里。对于预算建议,模型表达自然是加分项,计算可靠才是功能成立的前提。相比让模型直接读取流水、计算余额再给建议,这种分工更容易测试,也更容易处理服务故障。
但作者对可信度的描述,需要收窄理解。
数字来自事实,不等于句子忠于事实。
例如,输入同时包含预算上限 520 和已花金额 83,模型如果把两者关系说反,数字集合检查仍会通过。没有数字的错误建议也可能通过。代码能拦住新编出来的数值,不能证明金额角色、时间范围或整句话都正确。
此外,共用引擎可以减少页面内部的不一致,却不能保证引擎自身没有错误。作者也明确接受了另一项代价:模型无法提出信号引擎尚未检测到的新洞察。
原文展示了实现思路和校验代码,但没有提供误判率、漏判率或与其他方案的对照数据。因此,它是一套边界清楚的工程经验,还不足以证明完整的财务建议可靠性。
能拿来做什么
- 在前端预算卡片中,先用页面已有数据生成可直接展示的建议,再异步请求模型润色,让网络请求退出首屏答案的关键路径。
- 为涉及日期的检测函数显式传入
now,用固定输入验证月初、月底和预算周期边界,减少对运行时钟的依赖。 - 在 Node 或客户端接入模型时,只传入允许它表达的事实;预测尚不稳定,就先不进入提示词。
- 如果采用数字集合校验,把它当作基础过滤。对于必须准确的金额角色和时间范围,可以继续保留模板表达,只开放不影响结论的措辞调整。