Python 网关实战:逐层压低大模型调用费
文章以 Python 统一调用网关处理 21995 次合成请求,逐项评估用量账本、预算、上下文裁剪、缓存和模型路由。标题所称节省 82% 来自模拟流量,正文还涉及提示缓存反增费用和语义缓存误命中的问题。
AI 深度解读
LLM 功能的账单,往往藏在重复发送的系统提示词、不断增长的聊天历史,以及每次都调用强模型的默认选择里。作者做了一个 Python 网关,把这些成本逐项拆开:在 21,995 次请求的模拟日流量中,费用从 $80.37 降到 $14.52,下降 81.9%。
这套方案值得看,但「便宜 82%」不能直接搬进项目预算。分词和代码确实运行过,模型却是确定性的假客户端,准确率也来自人为设定。真正能拿走的,是一套把费用、缓存误命中和回答质量放在一起检查的方法。
先记清每笔费用,预算才能挡对请求
所有调用统一经过 Gateway.handle(),应用不直接访问 provider SDK。网关依次处理预算、精确缓存、语义缓存、模型路由和供应商提示词缓存,最后记账。优化都变成配置开关,才能逐项回放比较。
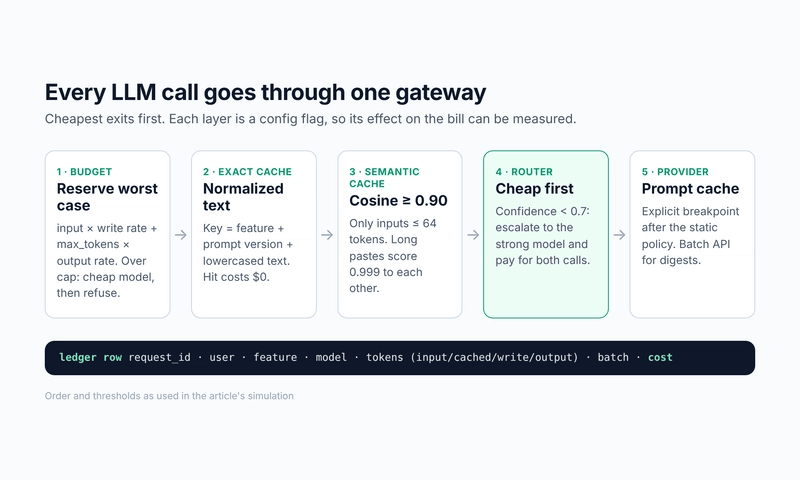
账本记录用户、功能、模型、usage 和费用。输入 token 还要分成普通输入、缓存读取、缓存写入,不能把缓存 token 当作免费。
按作者抄录于 2026-10-30 的价格,每百万 token 的 Standard 费用如下:
| 模型 | 普通输入 | 缓存读取 | 输出 |
|---|---|---|---|
gpt-6.1-terra |
$1.00 | $0.05 | $5.00 |
gpt-6-luna |
$0.10 | $0.01 | $0.50 |
作者按默认 30 分钟缓存写入收取普通输入的 1.25 倍计算;把这个规则用于 Luna,是作者自己的假设。上述金额只能用于理解这次模拟。
调用前用 tiktoken 0.14.0、o200k_base 估算 token,调用后以供应商返回的 usage 为准。原文没有确认 GPT-6 系列的编码,每条消息额外加 4 token 也是近似值。Claude 则可用 /v1/messages/count_tokens 估算。
预算检查按最坏情况预留:输入全部按缓存写入价计费,输出用满 max_tokens。额度不足时先切便宜模型,再考虑拒绝。后台任务使用 system 用户,豁免用户额度,但仍受功能额度限制。
每天 $1.00 的用户预算,在未优化时拒绝了 3,514 次请求,12 个用户触顶;完成优化后只拒绝 192 次,剩下一个大量粘贴日志的用户触顶。
预算负责限制损失,正常请求便宜下来要靠调用链本身。
缓存先看边界,再看命中率
作者把聊天历史限制为 1,500 token,保留 system、首条用户问题和最近消息。结果只省了 3.5%,因为大多数会话很短,每次约 2,000 token 的固定政策提示词才是主要负担。
保留首问却很关键:模拟中 20% 的追问依赖开场问题,不固定首问时,准确率从 99.96% 降到 97.54%。这里也有实现边界:最新消息始终保留,即使它单独就超过历史预算,超大输入还得交给预算层处理。
更大的坑出在供应商提示词缓存。按原文采用的规则,GPT-5.6 及以后最少需要 1,024 token,复用要求完整前缀一致。时间戳放开头会破坏复用;缓存写入又更贵,于是可能越缓存越花钱。
仅把时间戳挪到末尾,在作者的模拟里仍不够。隐式断点包含了变化的用户问题,不同问题无法复用整段缓存。作者用显式断点固定政策边界:
def _breakpoints(self, feature, msgs):
    if self.cfg.cache_mode == "implicit":
        return None                      # provider puts one at the end of the prompt
    if self.cfg.cache_mode == "explicit" and feature == "support_chat":
        return [0, len(msgs) - 1]        # after the policy, and after the latest turn
    return []                            # one-off prompts: no cache writes at all
关键是 return [0, len(msgs) - 1]:政策结束和当前对话结束各设一个边界。对应配置是 prompt_cache_options.mode = "explicit",内容块使用 prompt_cache_breakpoint。
第二次请求的输入费用,时间戳在前且隐式缓存时为 $0.002561,关闭缓存为 $0.002049,显式复用政策则为 $0.000128。作者的基线甚至比关闭缓存贵 18%。一次性处理的 4,000 词文档,也没必要为无人复用的缓存付写入费。
响应缓存又是另一层。精确缓存直接复用答案,namespace 必须带上模型和提示词版本,防止更新提示词后继续返回旧答案。这一步减少 4,226 次调用,费用从 $34.68 降到 $31.52。
语义缓存则要更谨慎。作者用字符 n-gram 哈希向量离线模拟 embedding,在 3,500 条首问上扫阈值:0.80 时有 11 次误命中,0.85 时还有 5 次,0.90 时本次样本才归零。
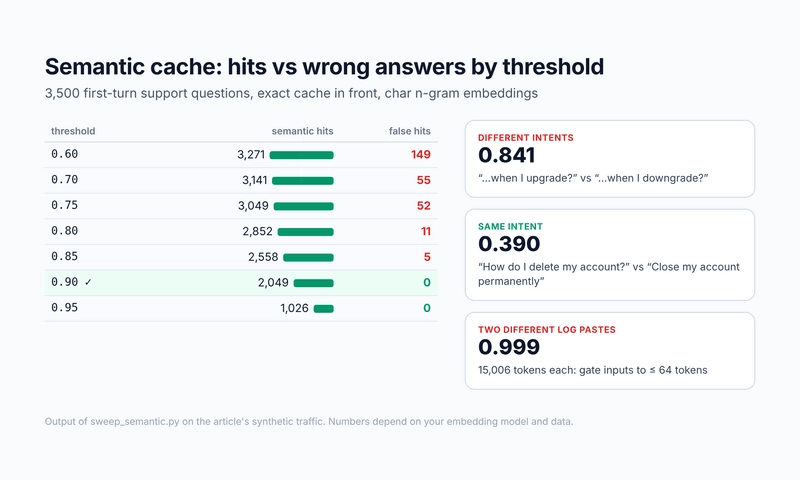
「升级后数据怎样」和「降级后数据怎样」相似度达到 0.841;两个不同的 15,006 token 日志,相似度更达到 0.999。作者早期版本因此把一个用户的日志分析返回给了另一个用户,后来增加 SEMANTIC_MAX_TOKENS = 64,只允许短问题进入语义缓存。
即便如此,0.90 阈值也只再省 $0.91/天。
便宜模型先答,关键在于谁来判断它答对了
路由是另一项大收益:先调用 gpt-6-luna,置信度不足再调用 gpt-6.1-terra。下面这段代码解决升级调用问题:
def route(client, messages, *, max_tokens, now, task, threshold=0.7, cheap=CHEAP, strong=STRONG,
          breakpoints=None):
    """Returns (final_response, all_responses). Every response is billed,
    so an escalated request costs cheap + strong."""
    first = client.complete(cheap, messages, max_tokens=max_tokens, now=now, task=task,
                            breakpoints=breakpoints)
    if first.confidence >= threshold:
        return first, [first]
    second = client.complete(strong, messages, max_tokens=max_tokens, now=now, task=task,
                             breakpoints=breakpoints)
    return second, [first, second]
要看最后一行的 [first, second]:升级时两次调用都收费,第一次的费用不会退回。
模拟中,16,743 次路由请求有 3,292 次升级,占 19.7%;日费用从 $30.61 降到 $15.42。准确率同时从 99.96% 降到 99.84%,少数便宜模型的答案属于「自信地答错」。
困难就在 confidence。假客户端直接提供与正确性相关的分数,真实服务需要从 log probabilities、验证提示词、已标注样本训练的分类器或学习式路由器获得信号,不能默认模型自报分数就可靠。
最后是能等的任务走 Batch API。原文按输入、输出价格均优惠 50%、24 小时内返回计算,适用于夜间摘要。所给原文在这一节截断,没有完整的最终分步输出,无法进一步核对最后一段收益。
我的判断
我认可统一网关、按实际 usage 记账,以及同时报告费用和准确率的做法。它们比单独追求缓存命中率更接近产品需要。
但 81.9% 是合成流量的结果。模型能力和任务难度是人为设定,置信度也被设计成与正确性相关;12 个 pytest 测试能约束代码行为,不能证明真实模型会达到同样效果。作者引用的 FrugalGPT「最高省 98%」和 RouteLLM「部分场景降本超过 2 倍」,也不能代替当前业务的对照实验。
还有两个迁移风险。精确缓存的归一化会转小写、删除标点,用在代码问题上可能改变含义。语义相似更不能充当权限判断,返回个性化内容时仍需租户和用户隔离。
这篇最有价值的是实验方法,82% 应当留在它自己的模拟条件里。
能拿来做什么
- 在 Node 或 Python 的模型调用入口记录用户、功能、模型、输入输出 token、缓存读写和实际费用,先找出最贵的调用类型。
- 检查客服或知识问答提示词,把稳定政策与动态内容分开,依据供应商实际 usage 验证缓存是否复用,再决定是否开启写入。
- 优先给重复首问、工单分类做响应缓存,键中加入模型、提示词版本和必要的权限范围;代码内容不要直接套用删除标点的归一化。
- 为模型路由准备人工标注样本,同时统计升级率、双重调用费用和错误率;夜间摘要等可等待任务,再评估 Batch API。