自动化渗透Agent如何划定安全边界
文章从行动自主性、攻击能力范围和内置防护三个维度评估Agent渗透测试框架,强调自主利用漏洞、横向移动及暴露MCP控制接口的风险。部分工具能自动提交修复PR,但仍需人工审查和合并。
AI 深度解读
AI 渗透测试工具已经能从发现漏洞一路走到利用、横向移动和后渗透。原文作者想厘清的是:这些工具有多大行动自由,出了差错谁能踩住刹车,以及怎样把自动化能力用在修复上。
对程序员来说,这篇的价值不是提供一份工具排行榜,而是提醒我们:接入安全 Agent,不能只看它能找到多少漏洞。执行权限、网络边界和人工审批,决定了它究竟是测试助手,还是可能制造事故的执行者。
判断风险,先看它能自行做什么
作者用三个维度评估工具:行动自主性、攻击能力覆盖面,以及内置防护机制。
第一,看它只是观察,还是会主动改变目标系统。扫描、识别服务,与利用漏洞、获取权限、继续访问其他系统,需要不同等级的授权。一个可以连续执行后续动作的 Agent,会把最初的判断错误放大成一串操作。
第二,看它掌握多少攻击能力。专注 Web 检查的扫描器,与能调度 150+ 种攻击工具的平台,能够触及的系统和操作范围不同。工具越多,权限和依赖也越难管理。
第三,看限制是否真正落实在执行环境中。概念验证(PoC)、沙箱、人工审批、目标白名单和范围固定,各自解决不同问题:发现是否可信、命令在哪里运行、谁批准执行、网络能够访问哪里。
PoC 验证负责证明漏洞存在,沙箱和权限边界负责限制行动范围。
作者提到,HexStrike AI 发布后,Check Point 曾记录威胁行为者讨论用它利用新披露的 Citrix NetScaler CVEs。但报告主要依据论坛讨论和攻击者自述,工具实际参与入侵的独立取证证据仍然有限。这能提示滥用风险,不能直接当作已确认的攻击归因。
哪些工具的刹车更可靠
下面这张图是作者根据构建和运行经验给出的定位,并非基准测试结果。
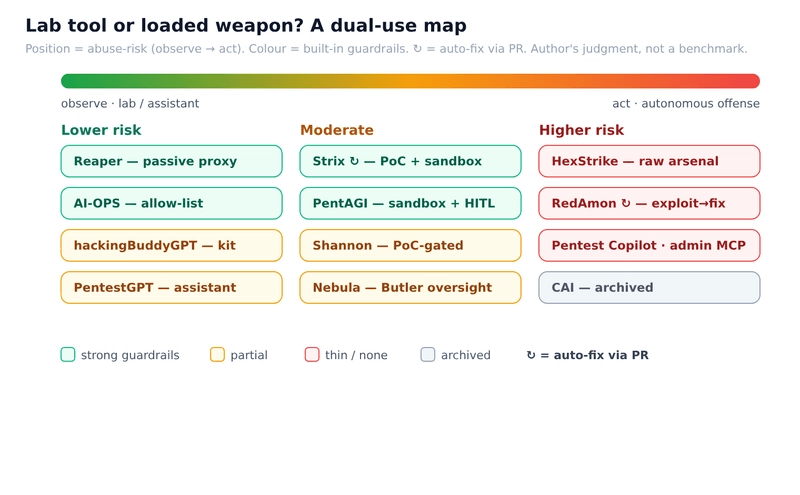
较低风险的一组包括 PentestGPT、AI-OPS、hackingBuddyGPT 和 Reaper。PentestGPT 延续助手路线;AI-OPS 带有白名单约束,面向能力较有限的模型;hackingBuddyGPT 更像研究用搭建套件;Reaper 则是被动的中间人代理(MITM proxy),并不是 Agent。它们被放在一起,是因为保留人工主导、具备限制,或不会自行采取行动。
中间一组是具有实际防护机制的自主工具。Strix 用可运行的 PoC 验证发现,在沙箱里执行,并提供 CI 模式;PentAGI 隔离工具运行环境,也支持人工参与模式;Shannon 是白盒自主工具,以「no exploit, no report」约束报告产出。这里的 PoC 门槛有助于减少不实发现,但验证本身仍可能涉及利用动作。
风险更高的一组,行动能力和执行边界需要额外审视。HexStrike 按自身统计提供 150+ 种工具,没有内置的发现验证,范围把关依赖外部模型判断。RedAmon 从侦察进入利用和后渗透,不过它对高影响工具设置了人工审批,不能简单归为完全没有限制。
Pentest Copilot 则能直接在攻击机上运行命令,并暴露 MCP server。作者特别强调:如果这个控制入口可被他人访问,对方就可能获得在攻击机上执行代码的能力。控制面本身也成了攻击面。
还有一种独立风险是停止维护。作者称 CAI 有约 10k stars,但仓库已经归档。星标数量不能抵消依赖老化、漏洞无人修复的问题;它可以供研究参考,却不该凭热度进入正式测试环境。
自动修复值得期待,但 PR 必须留下来审
原文最积极的部分,是把攻击验证与代码修复接起来。
RedAmon 的流程经过侦察、利用和分诊,再由 CodeFix agent 克隆仓库,借助理解代码的工具处理问题,最后创建带修复的 GitHub PR。Strix 则能在提供有效 PoC 的同时,给出自动修复建议和报告。发现问题与提出修复之间的等待,有机会因此缩短。
但原文没有给出修复正确率、回归缺陷率,也没有提供与人工修复的对照数据。能够开 PR,证明流程接通了,不能证明补丁已经可靠。
自动生成补丁之后,人工审查和合并仍然是必要关口。
审查既要看漏洞是否被堵住,也要看权限、接口行为和业务流程有没有被意外改变。作者明确反对自动合并,因为 LLM 生成的修复可能错误、不完整,或悄悄改变行为。PR 的价值就在于让这些修改成为可检查、可讨论的提交。
我的判断
我赞同作者把关注点从「模型有多聪明」移到「工具被允许做什么」。尤其是出口网络限制:Agent 即使接受了目标约束,也可能跟随重定向访问范围外地址。提示词里的承诺,无法代替执行环境真正拦住一次连接。
不过,这份风险分组仍是经验判断。作者没有提供统一测试集,也没有量化各工具在越界率、误报率或审批有效性上的差异。把它用作选型时的提问清单,比当作固定排名更合适。
一些防护也不能混为一谈。PoC 提高发现的可信度,却可能增加验证时对目标的影响;人工审批提供停顿机会,但能否发挥作用,还取决于审批人是否看得懂即将执行的命令。原文没有展开这些机制的配置细节,不能仅凭工具宣称具备它们,就认定边界已经建立。
相较于传统扫描器加人工验证,自主 Agent 的吸引力在于串联步骤、推进验证和衔接修复;代价是更多操作会连续发生,需要更严格的执行约束。并非每个日常检查任务,都需要开启完整攻击链。
作者还讨论了本地无审查模型:它会移除托管模型可能提供的拒绝机制。但模型会不会拒绝,只是一层不稳定的限制。无论模型部署在哪里,授权范围、执行权限与网络隔离都应独立成立。
能拿来做什么
- 给前端或 Node 项目引入安全 Agent 前,先确认任务需要源码检查、扫描还是实际漏洞利用。把允许操作的测试目标和授权范围写清楚,涉及利用时,授权也必须明确覆盖利用。
- 在沙箱或 microVM 中运行攻击工具,把出口网络锁定到授权目标,并默认只读。作者自己的做法是将工具放进 microVM 内、仅绑定 localhost 的容器;重点是把边界落实到运行环境。
- 接入 MCP server 或其他命令控制端点时,检查监听地址和认证配置。按原文建议绑定 localhost、加入认证,避免将命令执行入口直接暴露到网络。
- 将自动修复接入现有 PR 审查流程,保留 PoC、操作日志和修复说明,并检查原有功能是否回归。测试前还要确定真实数据存在哪里、保留多久,准备能终止执行的开关,在利用和后渗透之前安排人工审批。