长上下文推理:缓存卸载还是重算
文章从 KV 缓存容量公式出发,分析长上下文推理的显存压力,并讨论卸载到 NVMe 与丢弃后重算的取舍。给出的 70B 模型配置示例中,128K 上下文的单会话缓存约占 40GB。
AI 深度解读
长上下文服务最先撞上的墙,可能不是 GPU 算得慢,而是显存装不下对话状态。把 KV cache 搬到 NVMe,还是丢掉后重新计算?作者的结论是:两条路都要付账,真正该设计的是缓存保留策略。
这篇值得程序员读的地方,是把「模型响应慢」拆成了存储传输、重复计算和请求调度几个问题。不过,原文没有提供实测环境或对照数据,里面的容量计算可以复核,性能判断则需要带着前提看。
长上下文为什么会吃掉几十 GB 显存
KV cache 保存 Transformer 已处理 token 的键和值,让模型生成下一个 token 时复用历史计算。它省下计算,却要持续占用内存。
原文给出的稠密 Transformer 每 token 缓存公式是:
2 x layers x kv_heads x head_dim x bytes_per_element
这里的 2 对应 Key 和 Value。缓存大小不仅取决于模型参数量,还取决于层数、KV 头数、头维度和存储精度。
作者用一个 700 亿参数模型举例:80 层、8 个 KV 头,采用分组查询注意力(GQA),每个头的维度为 128,以 FP16 保存。每 token 占用:
2 x 80 x 8 x 128 x 2 = 327,680 bytes
约为 0.31 MB。按原文取整,8,000 tokens 的单段对话需要约 2.5 GB,128,000 tokens 则需要约 40 GB。这还只是对话缓存,并没有算模型权重等其他开销。
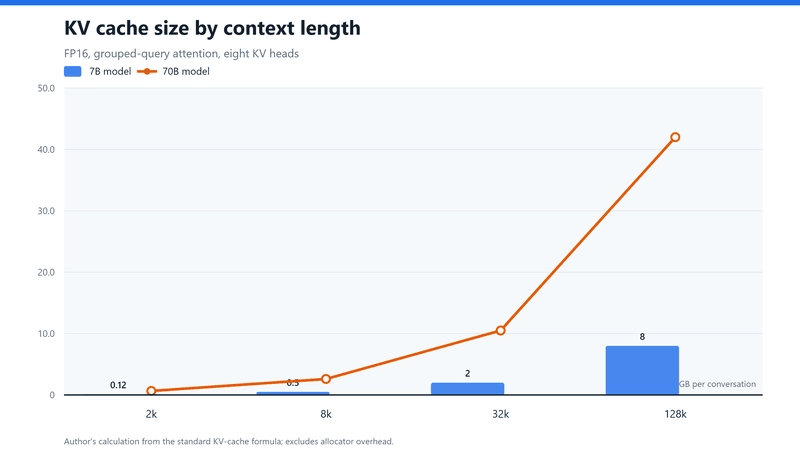
严格说,在上述配置固定时,缓存随上下文长度线性增长,模型权重则保持不变。原文所谓缓存增长比权重快,应当这样理解。
这也解释了几种推理优化分别在省什么:连续批处理让多个序列交错执行,前缀缓存避免重复计算相同系统提示词,分页注意力减少缓存碎片。它们缓解不同环节的压力,却没有取消长历史需要占空间这件事。
搬到 NVMe 和重新计算,延迟分别出在哪里
卸载(offload)的吸引力来自容量价格。作者给出的企业级 NVMe 顺序读取速度是 5~14 GB/s,并称 PCIe 5.0 SSD 每 GB 成本可比高带宽内存(HBM)低两个数量级。
但便宜不等于来得及。
作者设想,如果每次解码已经需要几十毫秒,缓存传输又能与计算重叠,读取时间就可能被遮住。问题是,提前读取需要知道接下来会解码哪个序列;动态请求不断进入批处理系统时,这个顺序未必能准确预测。
多数步骤顺利重叠,少数步骤等待数据,最后拖高的就是 p99 延迟。用户感受到的是偶发卡顿,平均速度却可能看起来不错。
这里还要补一道算术检查:按原文的带宽,完整读取 40 GB 需要约 2.9~8 秒,显然塞不进几十毫秒。实际方案必须依赖分块、预取、分层驻留或更小的读取量。原文没有交代具体访问粒度,因此不能据此认定 NVMe 可以直接承接全部活跃缓存。
写入同样影响方案能否成立。每生成一个 token,缓存都会追加内容。重新写整个块与只追加新增数据,作者称在长上下文下可能相差一百倍写带宽;但没有给出块大小和测试条件。可以确认的是,写法会影响吞吐和 SSD 寿命,具体倍数仍待验证。
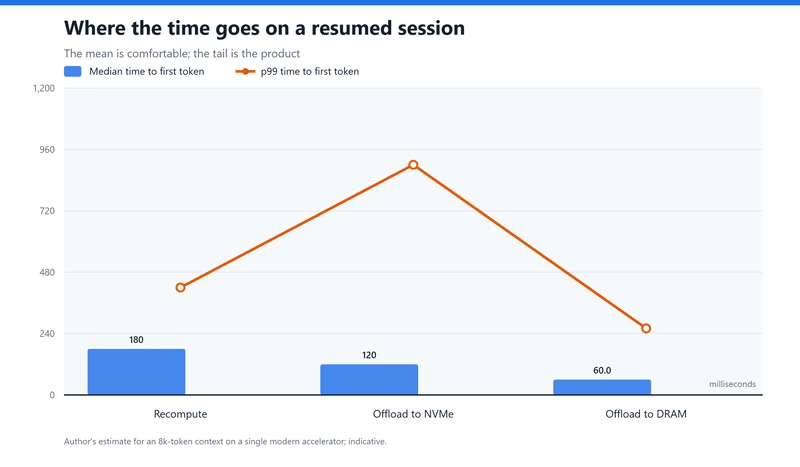
另一条路是重算(recompute):会话暂停后丢掉缓存,用户回来时,把历史重新执行一次预填充(prefill)。作者估计,现代加速器处理 8,000 tokens 的 prefill 需要几百毫秒,但没有说明硬件、模型和并发条件。
它把存储压力变成了调度压力。GPU 正忙着为在线用户解码时,一段恢复会话突然要求重新计算历史:先处理它,现有用户可能卡顿;后处理它,恢复会话的用户就要等更久。
Prefill 通常偏计算密集,decode 通常受内存带宽限制。重算虽然能高效使用计算单元,做的却是已经完成过的工作。
卸载把代价放在数据搬运上,重算把代价放在重复计算和排队上。
为什么最终还是要按会话冷热分层
作者描述的生产方案同时采用保留、迁移和丢弃:活跃会话留在 HBM,较可能恢复的温会话迁到主机 DRAM,冷会话直接释放,回来再算。
这里有个容易漏掉的区别:文章标题讨论 NVMe,但作者描述混合方案时,明确写出的温层是主机 DRAM,并没有证明所有生产系统都需要 SSD 缓存层。
淘汰策略通常是带成本模型的最近最少使用策略(LRU)变体。判断思路是:如果「预计复用概率 × 重算成本」高于存储成本,就继续保留。大白话就是,留下这段历史,未来省下的计算是否值得现在占着内存。
难点在于复用概率只能估计。30 秒后回来的人,与再也不回来的人,在淘汰发生时可能看不出区别。策略判断错了,要么白占内存,要么让恢复请求突然变慢。作者因此主张让框架开放策略配置,而不是把规则写死。
最值得先测的业务指标,是恢复会话请求占比。大量用户持续回来接着聊,与多数请求都是新对话,需要的缓存策略不会相同。仅知道平均上下文长度,还不足以回答该留多少缓存。
我的判断
我认同作者把问题落到工作负载上。对于多轮 AI 应用,首次请求、持续生成和暂停后恢复,会消耗不同的资源,不能只拿一个平均响应时间判断体验。
但原文更接近架构经验分析,没有硬件清单、并发曲线、p99 对照或 SSD 写入量记录。「卸载还是重算更划算」并没有被实验回答。相比全部保留或全部重算,分层策略提供了更多调整空间,也增加了调度和运维复杂度,小团队未必值得自己实现。
文章向外延伸的几项判断也要收紧。端侧助手遗忘可能与内存预算、上下文截断有关,却不能据此排除模型能力和应用实现。长上下文 API 定价也不能只归因于缓存持有成本。
作者还提到,分析机构预计 2026 年推理基础设施支出为 600 亿~900 亿美元,并假设上下文长度每 18 个月翻倍。原文没有列出来源,这些数字可以作为讨论设想,不能当作已核实的行业结论。
对应用团队来说,先把会话恢复时的延迟测清楚,比直接选择一种缓存技术更有用。
能拿来做什么
- 给多轮 AI 应用区分新会话、连续请求和暂停后恢复,统计恢复请求占比及间隔。这些数据可以帮助判断缓存保留多久才有价值。
- 在前端和 Node 请求链路中分别记录首 token 延迟(TTFT)与生成过程中的卡顿,并观察 p99。恢复时慢和生成中慢,需要沿不同方向排查。
- 自建推理服务时,在相同模型、上下文长度和并发条件下比较保留、卸载与重算,同时记录吞吐、恢复延迟和存储读写量,避免只比较空载表现。
- 如果只调用托管模型 API,就先检查历史消息是否持续膨胀、系统提示词是否重复,以及恢复会话是否需要携带全部历史。底层缓存由服务商管理,应用侧仍能控制送入模型的上下文。