评测失败前,先核对运行环境
作者固定 Python 代码与输入,通过改变内存限制展示同一程序如何得到不同运行结果。评估编程 Agent 时,需要区分代码违反资源要求和执行环境未兑现配置承诺。
AI 深度解读
同一份代码、同一个输入,在 256 MiB 限制下算对,在 64 MiB 下报 MemoryError,能直接判定 AI 编程失败吗?作者用固定的 Python 程序做了几组受控实验,说明一个容易被评分表抹掉的区别:究竟是代码违反了要求,还是运行环境没有兑现承诺。
这篇值得读的地方,是把「失败」拆成了可以追查的证据。对正在选 coding agent、搭评测流水线,或者处理 AI 生成代码故障的团队,这比单看通过率更有用。
同一个 MemoryError,为什么可能是两种责任
实验任务很简单:读取云成本 CSV,把每一行以分为单位的整数金额准确相加。文件有 300,000 行,金额从 1 到 1,000 循环 300 次。每轮合计 500,500 分,正确答案是 150,150,000 分。
第一种实现先把全部记录放进内存,再求和:
def total(path):
    with open(path, newline="") as source:
        rows = list(csv.DictReader(source))
    return sum(int(row["amount_cents"]) for row in rows)
关键是 list(csv.DictReader(source)):约 3.3 MiB 的文件,转成字典和字符串后,占用会明显增加。
第二种实现边读边加,让处理完的行对象及时释放:
def total(path):
    with open(path, newline="") as source:
        return sum(int(row["amount_cents"]) for row in csv.DictReader(source))
要看的是最后一行:直接遍历 csv.DictReader(source),没有保留全部记录。两者都使用标准库 csv,差别在对象保留多久。
作者还安排了一个错误对照:同样流式读取,却漏掉第一条数据,返回 150149999,而正确值是 150150000。增加资源不会补回漏算的一分钱。
每次实验都启动新进程,并用哈希确认代码和输入没变。每种条件重复三次,第二轮反转执行顺序。成功运行时,整批读取的峰值常驻内存约为 96.7 MiB,流式程序约为 20.6 MiB。
不过,实验限制的是 Linux RLIMIT_AS,即虚拟地址空间;记录的是峰值 RSS,即常驻内存。两者不是同一个量。作者通过 resource.setrlimit(resource.RLIMIT_AS, (limit, limit)) 施加限制,其中 limit = memory_mib * 1024 * 1024。这次 MemoryError 来自地址空间不足,没有触发容器 OOM kill,也没有耗尽宿主机内存。
责任归属取决于任务约定。承诺提供 256 MiB,却只给 64 MiB,是运行器没有满足条件;明确要求在 64 MiB 内完成,整批读取方案就没有完成任务。
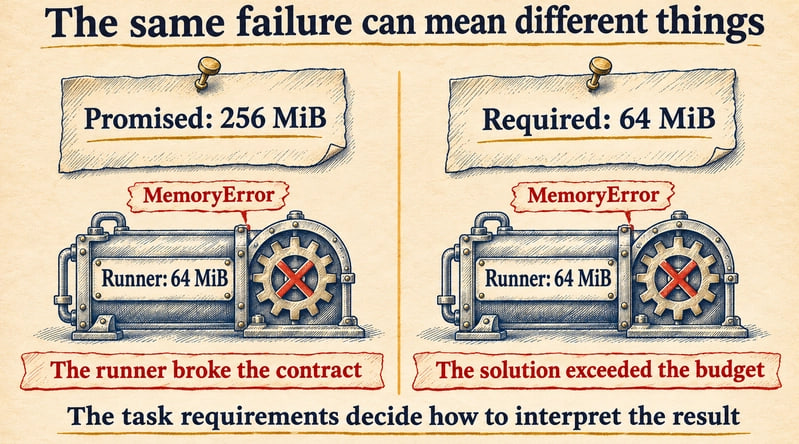
错误信息描述发生了什么,任务要求决定这次失败该如何归类。
超时和重试,分别能证明什么
第二组实验在流式程序启动前增加一秒等待,模拟依赖延迟,没有实际网络请求。墙钟时间限制为 0.25 秒时,三次全部超时;放宽到四秒,三次都算对,耗时约 2.2 到 2.3 秒。
短超时发生时,程序还没开始读取 CSV。拿这个结果证明「求和算法太慢」,原因就找错了。但如果生产服务承诺 250 毫秒内返回,依赖等待也必须计入预算,用户确实等了这么久。
所以,代码正确性评测要分开记录环境准备和代码执行;端到端服务评测则要包含用户实际等待的环节。作者建议保留环境准备、环境就绪、模型请求、工具执行和评分的起止时间。
墙钟时间与 CPU 时间也要区分。等待服务会消耗前者,却未必消耗多少后者;CPU 配额又可能通过限流拉长运行时间。Kubernetes 的 CPU 限制通过 throttling 执行,内存超限则可能导致 OOM 终止。只写「Two CPUs and 4 GB」,还不足以复现测试条件。
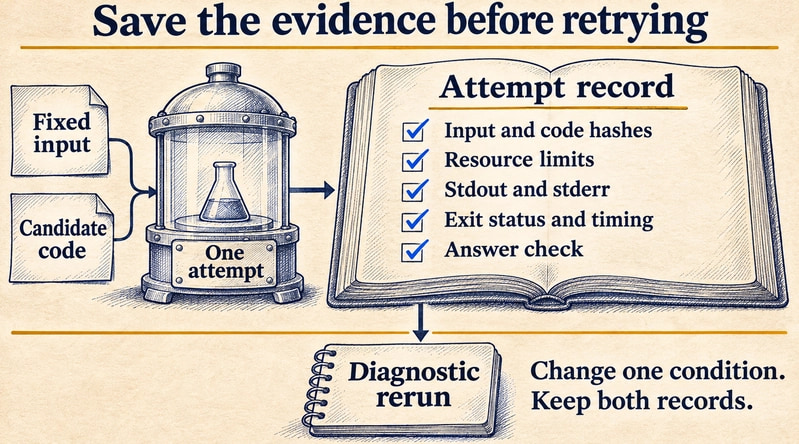
重试也有类似边界。256 MiB 下通过,只能证明程序在更宽松条件下能算对,不能覆盖它在 64 MiB 下的失败。要定位原因,最好一次只改一个条件,并为重跑建立独立 ID。
对真实 agent,重新发起任务可能得到不同计划和补丁。这适合观察多次尝试的可靠性;回放保存的补丁,才更容易隔离环境因素。哪些失败允许重试、最多几次、哪些尝试计分,都应在比较模型前确定。
通过率的分母,可能比小数点更重要
作者最终保存了 27 条记录:18 条内存比较、六条超时比较,以及三条故意缺少输入文件的准备失败记录。后三次在启动候选程序前就被拦下,没有发生代码执行。
记录包含代码与输入哈希、限制配置、输出、错误文本、退出码、耗时和可获取的资源测量。超时进程被终止后,无法写出最终 CPU 和峰值内存数据,对应字段存为缺失,而不是零。
假设另一次评测安排了 100 次尝试:70 次通过,20 次答案错误,10 次因环境准备失败而没有启动。端到端通过比例是 70/100;进入评分环节后的通过率是 70/90,约 77.8%。两个数字都有意义,但必须同时交代分母和那十次失败。
如果每个模型各自剔除不同的失败任务,难题恰好被移除的一方还可能占便宜。因此,报告不仅需要失败分类,还需要一致的无效运行政策与可比较的任务覆盖范围。
作者引用的 Anthropic Terminal-Bench 2.0 实验也说明资源配置会影响分数:固定模型、harness 和任务集后,最严格与不设上限配置相差六个百分点。但其中既可能有基础设施故障减少,也可能有 agent 获得资源后采用更昂贵方案的收益,不能把这六个百分点套给其他评测。
示例要求 Linux、Python 3.11 或更新版本,仅使用标准库,运行命令是 python3 environment_failures.py --output environment-demo。程序顺序执行内置示例,每个工作进程另有八秒 CPU 限制;输出目录必须新建,脚本拒绝覆盖已有目录。
公布的数据来自 Linux x86-64、Python 3.12.3,整体实验受 150% CPU 配额、6 GiB 内存上限约束,swap 关闭。宿主机同时有其他工作,因此耗时不能拿来做实现性能排名。
我的判断
我认同作者最关键的要求:先核对约定,再解释失败。它同时约束两种草率判断,既不能遇到报错就怪模型,也不能把资源耗尽都算作环境问题。代码创建过多对象、工作进程或装入过重依赖,同样可能违反预算。
但这组实验的证明范围很窄。它使用人工构造的固定程序,没有调用模型,只隔离了几种失败机制,不能据此估算真实 coding agent 有多少失败来自环境。96.7 MiB 和 20.6 MiB 也只是这套 Linux/Python 环境的观测值。
它对固定程序采用受控比较,解释力比「重跑后好了」更强;代价是需要保存补丁、输入、环境和过程记录。真实模型评测还要补上精确模型标识、生成参数、提示词、工具配置、环境镜像摘要及完整交互历史。
Python isolated mode 和进程资源限制也没有把示例变成任意代码的安全沙箱。它只是配套 IaC Eval Bench 的教学示例,没有修改评分器或引入模型执行。
证据不足时保留「原因未知」,比给失败贴一个看似明确的标签更可靠。
能拿来做什么
- 在前端或 Node 项目的 AI 编程评测中,先保存输入、补丁和初始文件状态,再区分依赖安装、工具执行、程序运行与评分失败,避免所有问题只剩一个 fail。
- 遇到超时或内存失败时,固定代码和输入,每次只调整一个限制,并保留原始记录。把诊断重跑与正式评分尝试分开管理。
- 比较 coding agent 时,同时报告全部尝试和实际进入评分环节的通过率,并提前写明重试规则、无效运行处理方式和任务覆盖范围。
- 对依赖外部服务的日常 AI 编程流程,分别记录准备时间与执行时间;对承诺响应时限的服务,再把用户等待的完整链路计入预算。