开源OCR方案宣称缓存缩减96%
一项开源OCR方案宣称将KV Cache压至常数量级,并减少96%的缓存占用,以支持更多页文档处理。素材未给出模型名称、测试条件或识别精度。
AI 深度解读
文心Unlimited OCR 2想解决的,是长文档OCR里一个很实际的问题:前几页识别得动,读到几百页后,计算和显存开销还能不能控制住。它给出的办法是按需参考页面,再分块解码,让每一步少算、显存里少存。
量子位展示了884页《指环王》的连续解析,技术报告则给出KV缓存减少约96%的对比。对做文档解析服务的程序员,值得看的不是「无限」这个名字,而是它怎样处理跨页衔接,以及这些成绩有哪些适用边界。
缓存降了96%,到底省掉了什么
文心Unlimited OCR 2延续了上一代的基本流程:页面图像经过DeepEncoder,变成包含文字与版面信息的视觉Token,再由语言模型逐步生成解析结果。
生成时,模型会保存可供后续计算复用的键值缓存,也就是KV Cache。假如把所有页面的视觉缓存一直留在显存里,文档越厚,缓存就越大。即便某页暂时不参与计算,它占用的显存也不会自动归还。
这次升级把两个问题分开处理:SR-SWA缩小每一步的计算范围,Unlimited-Horizon Decoding Paradigm控制缓存保留范围。
少参与计算,不等于少占显存,两件事必须分别解决。
在MarathonDocBench的百页级单序列测试中,对比同时保留所有页面视觉缓存的标准解码,分块解码将峰值KV缓存从47GB降到1.77GB,减少约96%。这里仅统计KV缓存,模型权重等其他显存开销另算。
因此,不能拿1.77GB直接当作部署显存需求。标题里的「压成常数」,更适合理解为:固定处理块和窗口规模后,保留的缓存受到约束,而非整份任务的时间、内存和输出规模都固定不变。
为什么既要挑页面,还要挑页面里的内容
上一代采用参考滑动窗口注意力机制R-SWA,已经降低了推理阶段的KV缓存,但回看时,所有输入页面的视觉信息仍会参与注意力计算。长文档里,大量与当前输出无关的内容也跟着消耗算力。
SR-SWA增加了两层筛选。
Page Gate先确定当前需要参考哪些页面。Token Sieve再从这些页面中筛出相关的信息块:先用信息块的简要表示计算相关性,再通过TopK选出数量固定、得分最高的块。选中后,模型读取的仍是块内具体的视觉信息,并非只读摘要。
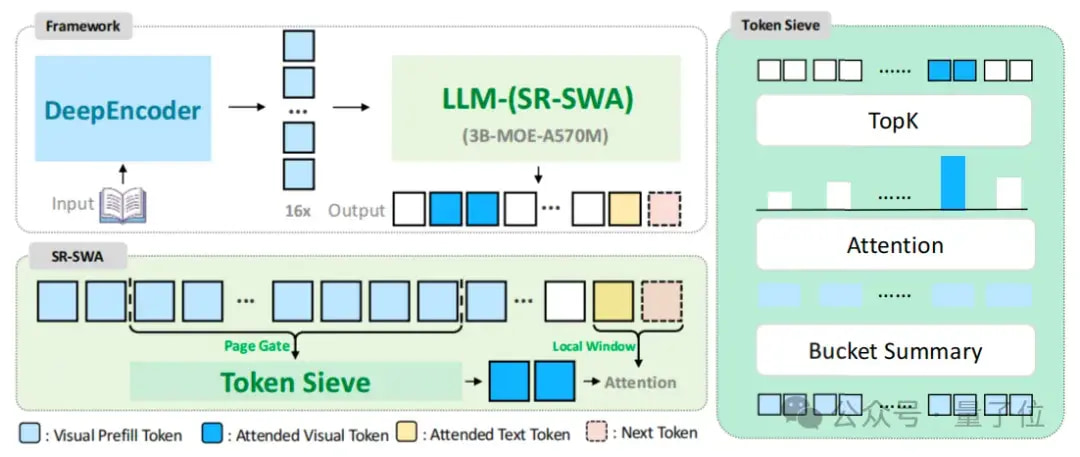
这些视觉信息与固定大小的Local Window一起参与解析。Local Window保存最近的上下文,随着输出向前移动;筛选出的视觉块则补充需要回看的内容。
固定数量的信息块,加上固定大小的局部窗口,就把每步参考的信息量限制住了。报告的百页级测试显示,SR-SWA单步解码速度达到Full Attention的7.0倍、R-SWA的5.6倍,单步耗时随文档增长的曲线也近乎水平。
这里衡量的是单步解码。整本书页数增加,总处理时间仍然会增加,不能把7.0倍直接当成完整任务的加速比。
缓存控制依靠另一套机制:将文档切成大小可控的页面块,相邻两块重叠一页。进入下一块时,复用重叠页的视觉KV缓存,并保留上一段输出末尾的文本缓存,其余不再需要的页面视觉缓存及时释放。
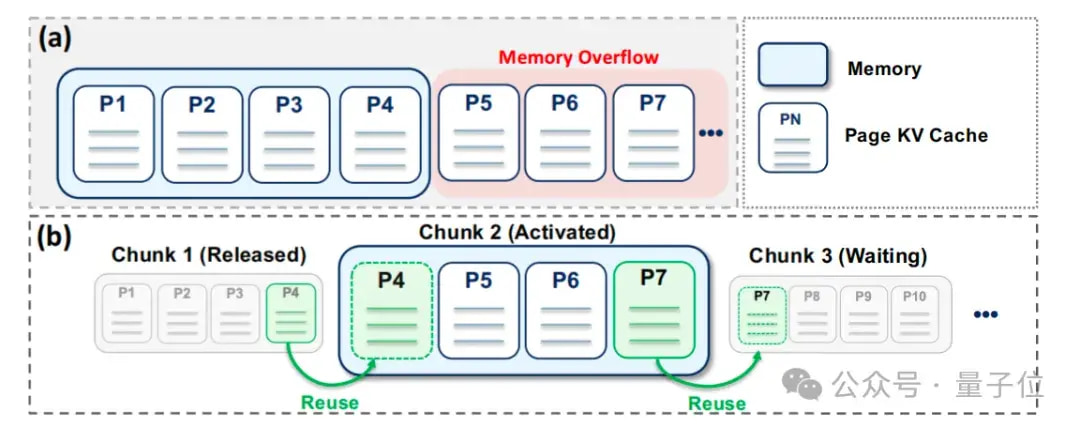
这个设计试图保住跨页连续性,同时避免让所有历史页面一直占着显存。不过,保留边界信息能帮助衔接,并不能据此推断模型随时都能完整回看任意历史页面。
哪些成绩来自实测,哪些来自报告
原文展示了3600+页的7部《哈利·波特》和1200+页的《三体》全集连续处理能力。量子位还实际提交了884页英文版《指环王》,约42分56秒完成解析,平均每页约2.9秒,输入与输出均为884页。
他们抽查第600页和第750页正文,称识别文本与原文一致;系统标记了466处跨页合并,并展示了第873至874页被分页截断的句子如何接回。
这能证明长任务跑完了,也提供了后段页面和跨页衔接的样例。但两页抽查不能代表884页全文零错误,466处合并也不等于466处都经过人工验收。
技术报告提供的是另一类证据:
- MPDocBench多页文档解析综合得分为84.59。
- 新建的MarathonDocBench包含100份文档,每份103至300页,综合得分为77.06。
- 两项综合得分均为报告所列参评模型中的最高值。
- 另一项16路并发测试中,端到端吞吐量从360提升至1315 Token/秒,约为标准解码的3.65倍。
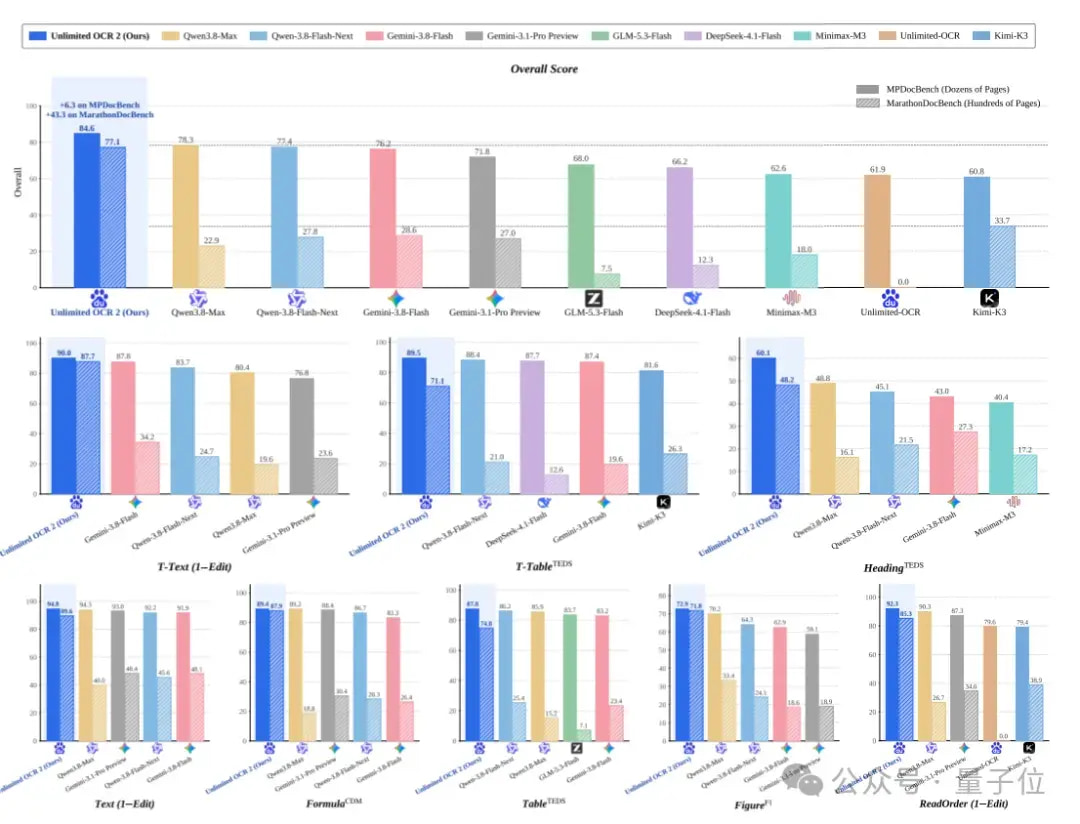
这几组数字各有口径:1.77GB来自单序列缓存测试,3.65倍来自16路并发,7.0倍来自单步解码对比。把它们合成一句「所有场景都更快、更省、更准」,就超出了证据范围。
原文还明确说,第二代单页综合得分与上一代基本持平。升级重点是长文档连续处理和资源控制,并非每一页的识别能力都大幅提高。
我的判断
我认可这次升级对问题的拆解。逐页OCR再拼接,容易丢失跨页段落和表格关系;整份文档持续解析,又容易背上不断增长的计算与缓存负担。SR-SWA和分块解码分别处理这两种开销,思路有针对性。
但「开源新王」只能收窄到报告列出的参评范围。MarathonDocBench由团队新建,原文没有展开数据构成、完整评测条件和独立复现情况,也没交代884页实测的硬件配置,不能据此推算自己服务器上的速度。
连续解析几千页,证明的是任务可以持续推进,不等于模型始终完整记得前面几千页。
对只提取单页字段的业务,传统OCR或逐页端到端解析仍然值得比较,流程也更容易分别重试。对跨页表格、连续正文,Unlimited OCR 2更有评估价值,但原文没有给出它与常见逐页拼接方案的完整成本对照。
团队提出的OCR 1.0、2.0、3.0,是从模块流水线、端到端页面解析,到持续文档解析的阶段划分。它能解释技术目标,不宜直接当作行业统一标准。「页数没上限」「永不宕机」也应视为目标表达,而非服务保证。
能拿来做什么
- 如果你在做扫描版技术手册或年报的检索服务,可以先用它生成连续文本,再接入检索流程;验收时重点检查跨页段落和表格,而不只看页面是否全部输出。
- 如果你维护Node文档处理后端,可以用自己的文件分别测单任务峰值显存、整份耗时和并发吞吐。记录模型权重等额外开销,避免把1.77GB误填成部署预算。
- 如果产品需要展示解析结果,可以保留原始页码与跨页合并信息,方便用户回查扫描件;评估时也应抽查文档后段及每个处理块的交界处。
- 如果只是处理短文档或单页表单,先与现有逐页方案比较质量和成本。原文已经说明单页得分基本持平,没有必要仅因「无限解析」就替换整条链路。